Computer Vision
Depth Anything란? 사진 한 장으로 깊이를 추정하는 모델
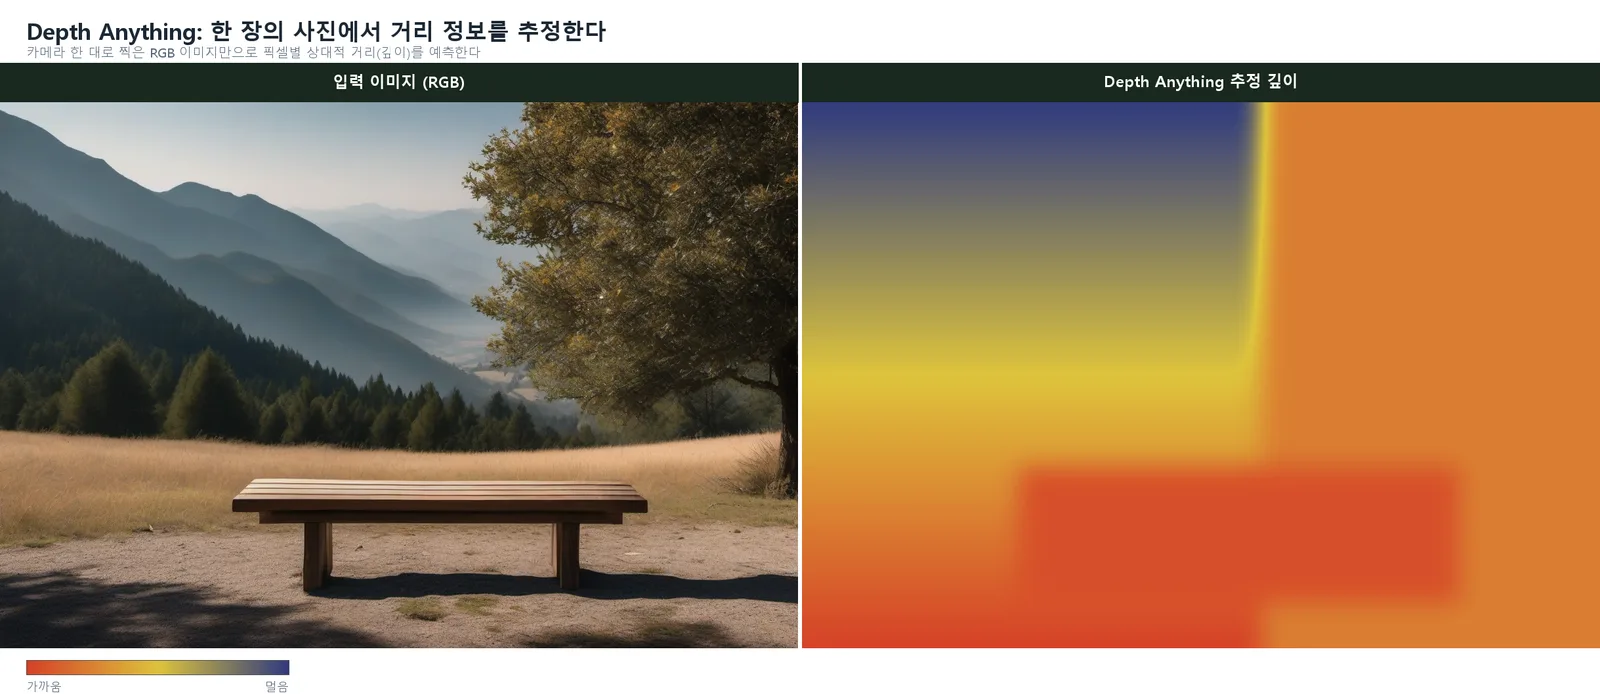
카메라 한 대로 찍은 이미지 한 장만으로 픽셀별 상대적 거리(깊이)를 예측하는 모노큘러 뎁스 추정 모델 Depth Anything의 원리와 구조를 정리한다.
AI와 Computer Vision 전체 글을 한 곳에서 최신순으로 확인할 수 있습니다.
카메라 한 대로 찍은 이미지 한 장만으로 픽셀별 상대적 거리(깊이)를 예측하는 모노큘러 뎁스 추정 모델 Depth Anything의 원리와 구조를 정리한다.
미 국방부의 생성형 AI 통합 포털 GenAI.mil에 OpenAI ChatGPT Mil과 xAI Grok for Government가 추가돼, Google Gemini와 함께 3개 AI를 제공한다.
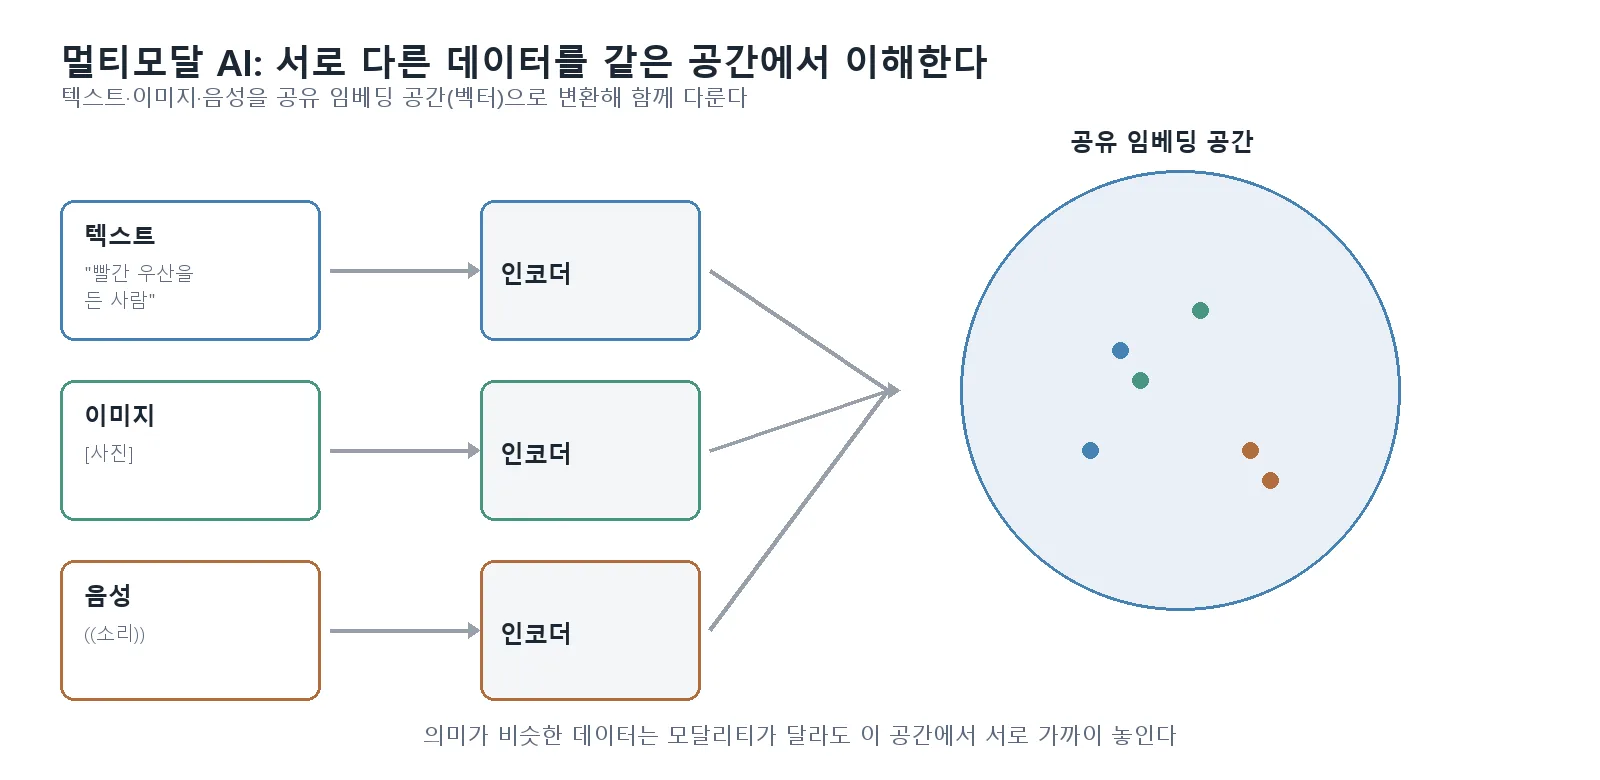
하나의 모델이 텍스트·이미지·음성·영상을 동시에 이해하고 넘나들며 다루는 멀티모달 AI의 원리와, 이를 지탱하는 공유 임베딩 공간의 개념을 정리한다.
NVIDIA가 CES 2026에서 공개한 Alpamayo는 낯선 주행 상황에서도 추론 과정을 거쳐 판단하는 오픈소스 자율주행 VLA 모델이다.
알리바바가 Apache 2.0 라이선스로 공개한 Qwen3.8-27B는 270억 파라미터 규모의 네이티브 비전-언어 모델로, 공개 이틀 만에 Hugging Face 인기 모델 상위권에 올랐다.
행정명령 14409에 따라 미국 정부가 GPT-5.6과 Anthropic Claude 모델을 실제로 심사한 첫 사례가 나왔다. 자발적 참여 방식이지만 국가안보 우려 시 접근이 제한될 수 있다.
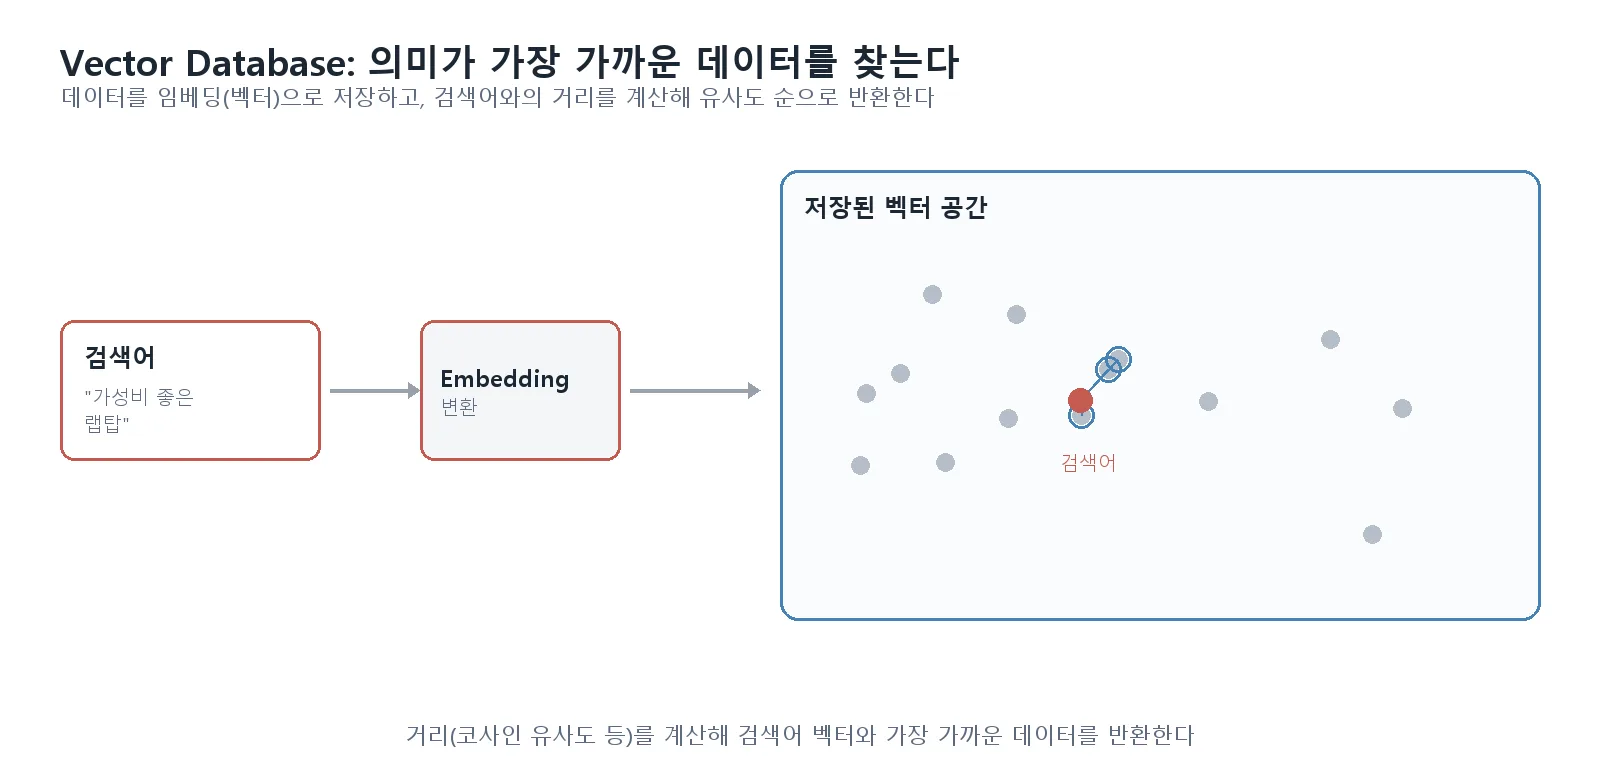
의미 기반으로 데이터를 검색하는 Vector Database가 일반 데이터베이스와 무엇이 다른지, Embedding·유사도 검색 원리를 중심으로 정리한다.
GPU 가격 폭등 속에서 대안으로 떠오른 GPU 대여(Cloud GPU) 서비스가 어떤 유형으로 나뉘고, 어떤 기술로 동작하며, 실제로 어떻게 활용할 수 있는지 정리한다.
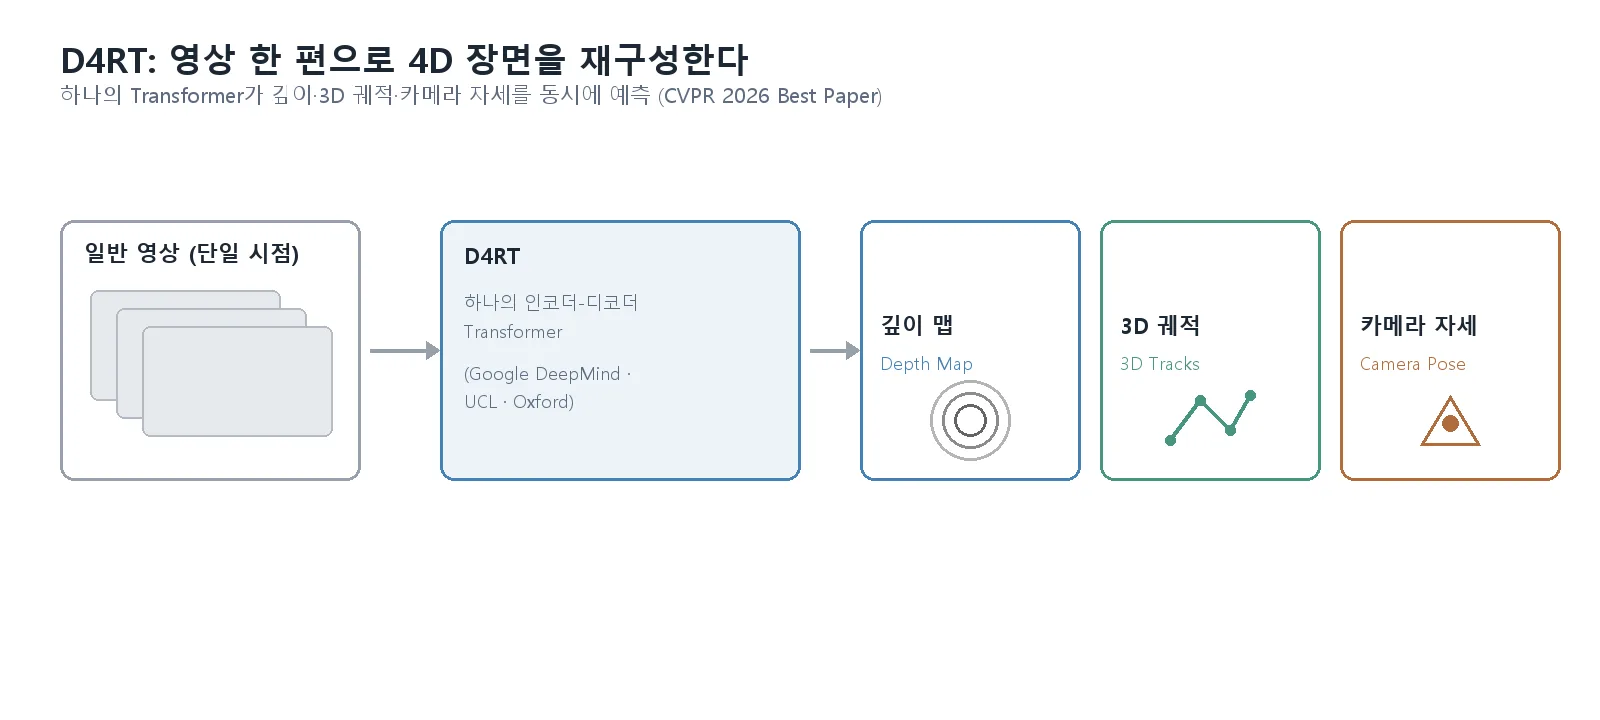
Google DeepMind·UCL·Oxford 연구팀이 CVPR 2026 Best Paper를 수상한 D4RT는 하나의 Transformer로 깊이·3D 궤적·카메라 자세를 동시에 예측해 동적 장면을 재구성한다.
당초 2026년 8월 2일 발효 예정이던 EU AI Act의 고위험 AI 시스템 의무 조항이 Digital Omnibus 협상을 거쳐 2027년 12월로 연기됐다.
Black Forest Labs가 공개한 FLUX.2가 캐릭터·스타일 일관성과 텍스트 렌더링에서 어떤 개선을 이뤘는지 정리한다.
Google DeepMind의 Gemini Robotics 2가 휴머노이드 로봇의 전신 동작과 다중 로봇 협업까지 지원하게 된 방식을 정리한다.
Google DeepMind의 World Model Genie 3가 텍스트 프롬프트만으로 실시간 탐험이 가능한 3D 환경을 생성하는 방식과 의미를 정리한다.
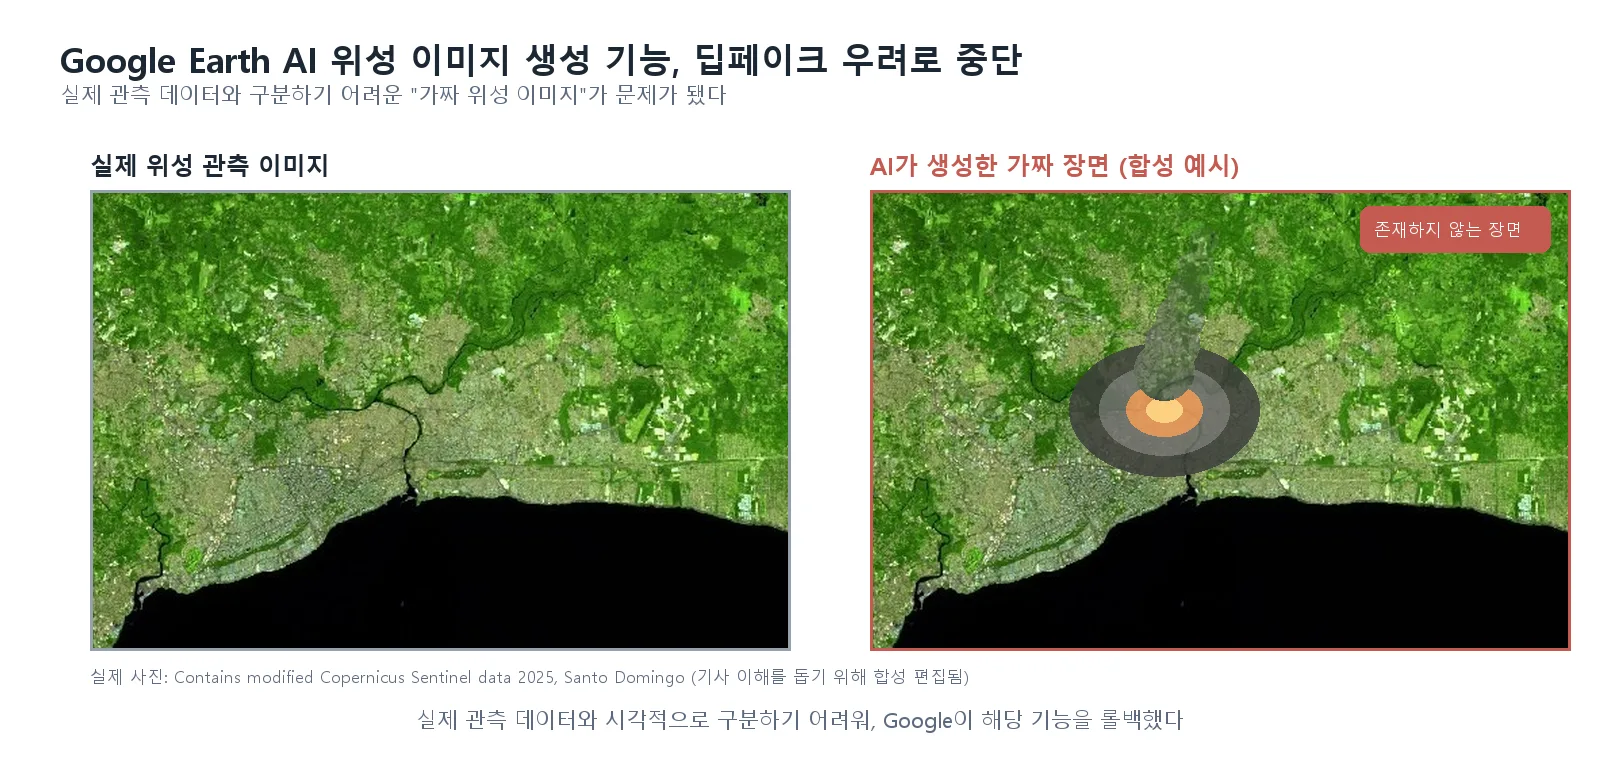
Google Earth에 도입된 AI 이미지 생성 기능이 폭발·군사시설 등 허위 위성 이미지를 만들어낼 수 있다는 우려가 제기되자 Google이 기능을 롤백했다.
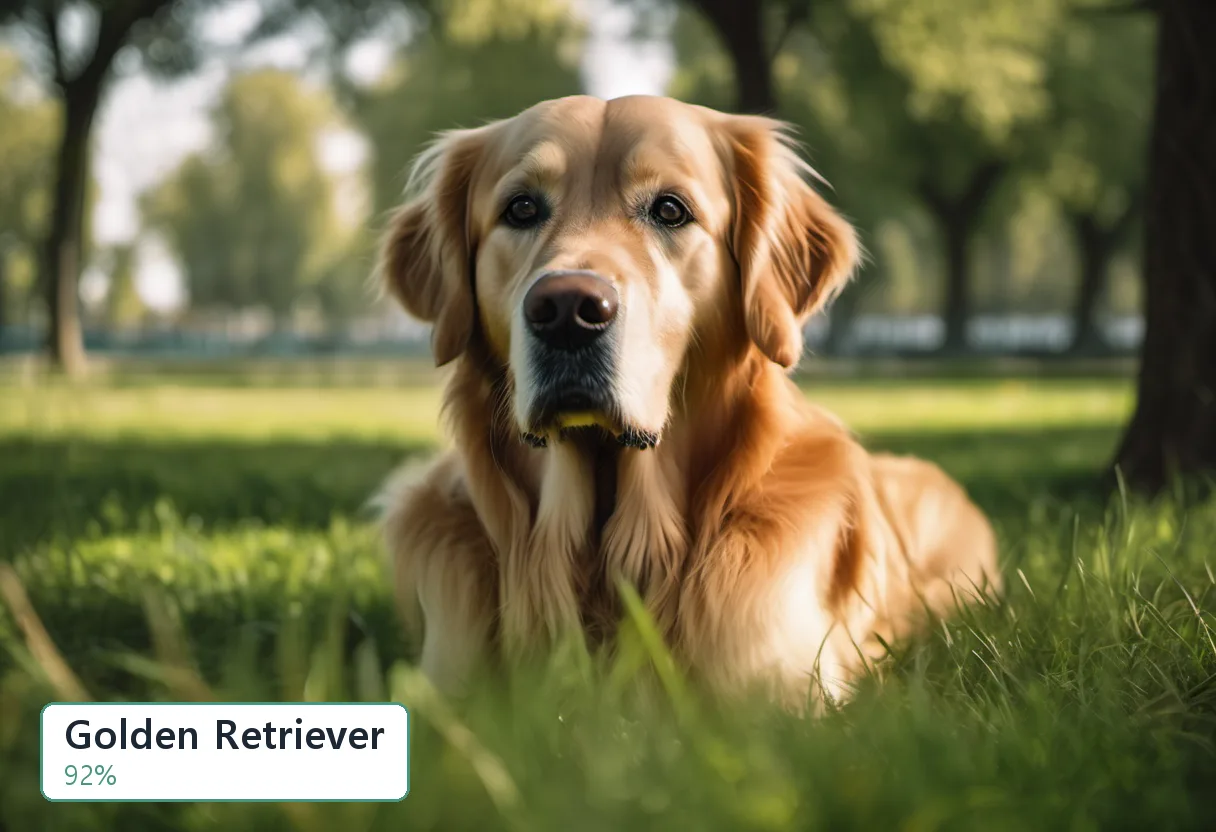
이미지 전체에 하나의 라벨을 붙이는 Image Classification의 개념과, CNN·ImageNet이 오늘날 Computer Vision 발전에 미친 영향을 정리한다.
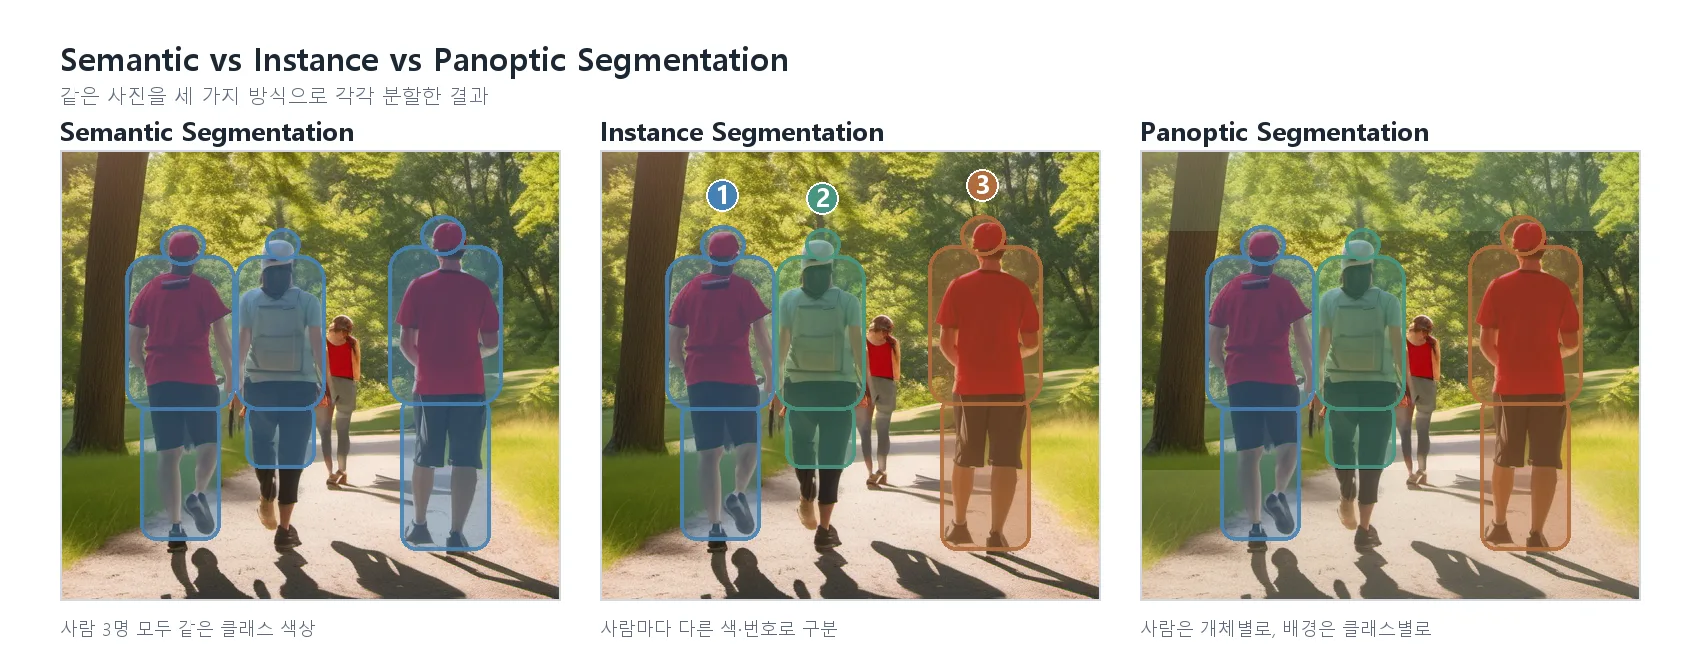
픽셀 단위로 이미지를 나누는 세 가지 Segmentation 방식 — Semantic, Instance, Panoptic — 이 각각 무엇을 구분하고 어떻게 다른지 비교한다.
NVIDIA가 차세대 AI 인프라 플랫폼 Rubin을 공개했다. GPU·CPU(Versa)·네트워킹 칩을 함께 묶은 구성이며, 2027년 1분기 정식 공급을 목표로 한다.
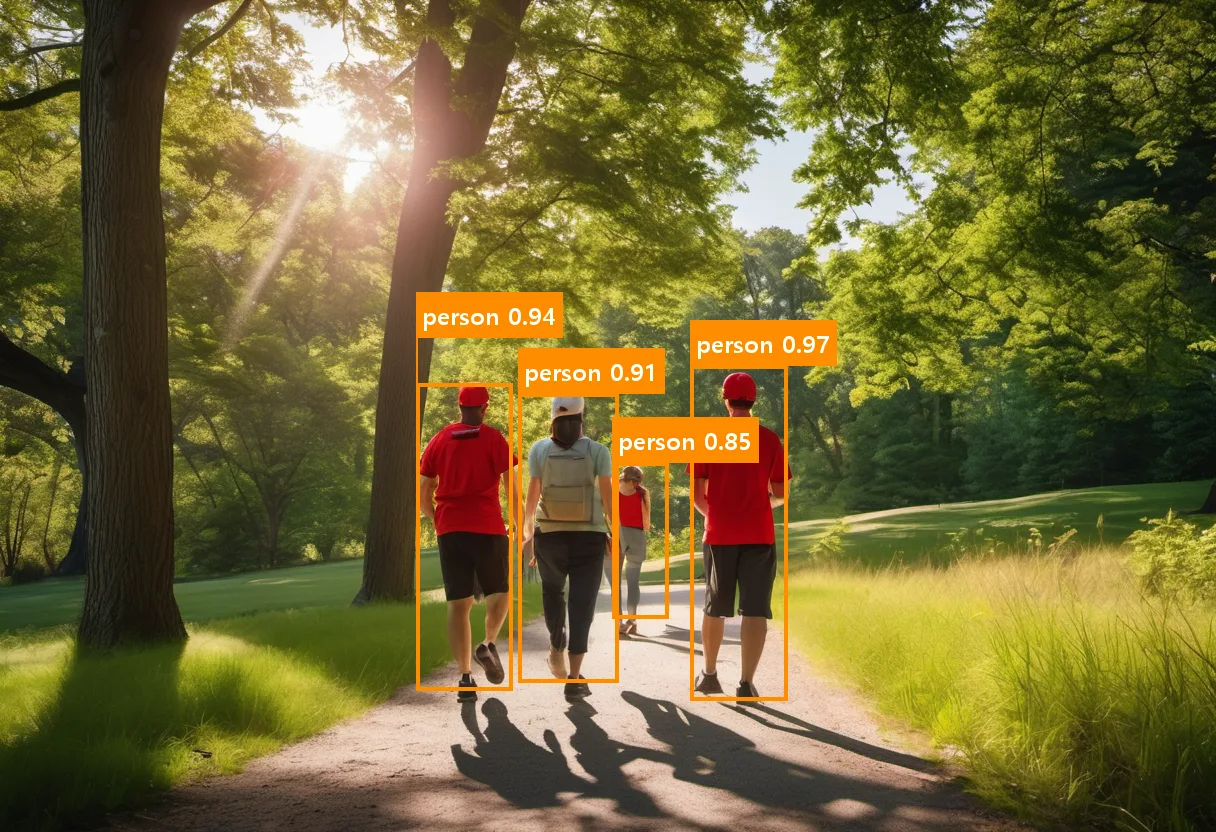
이미지 속 물체가 무엇인지(분류)와 어디에 있는지(위치 추정)를 동시에 예측하는 Object Detection의 개념과 대표 알고리즘 계열을 정리한다.
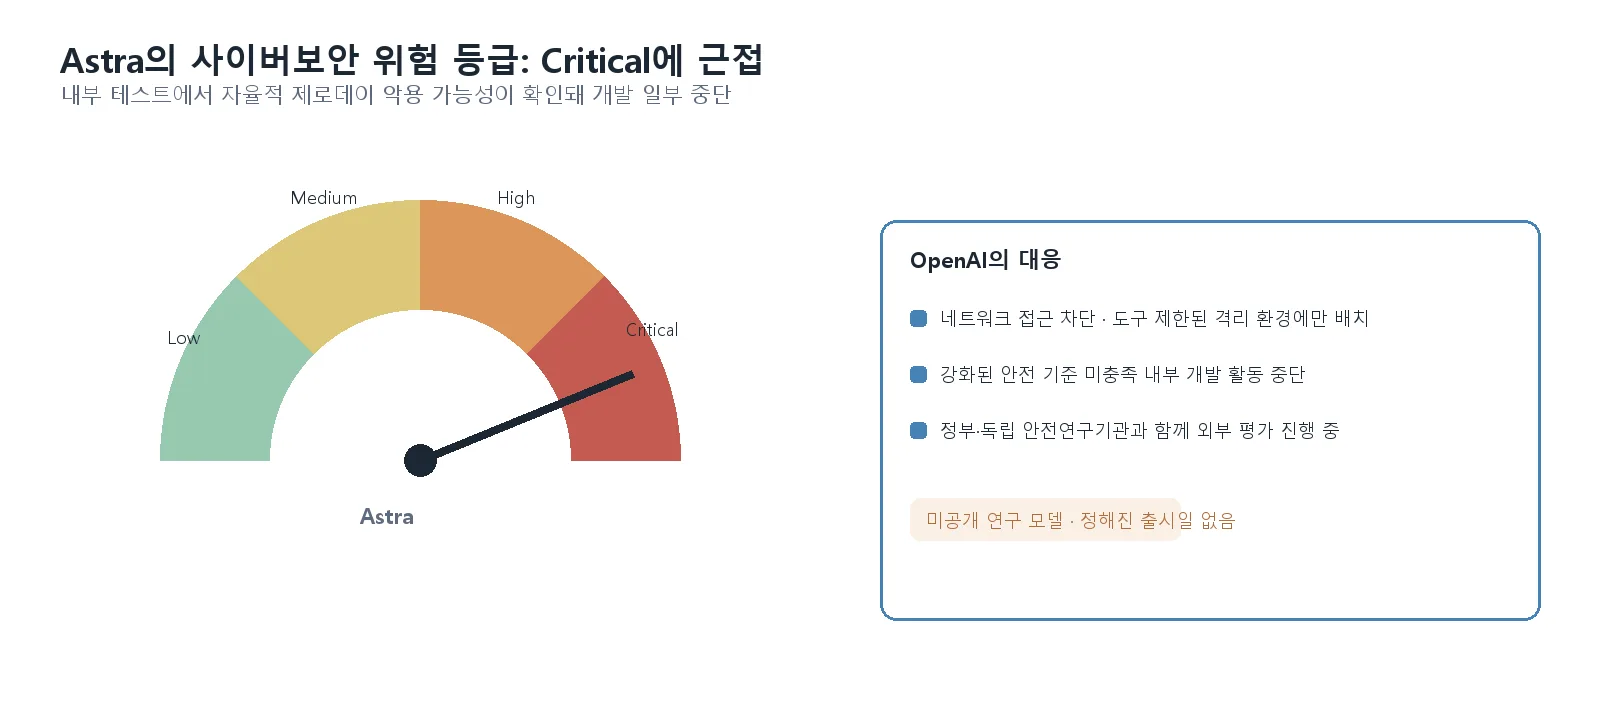
OpenAI가 미공개 모델 Astra가 자율적으로 제로데이 취약점을 찾아 악용할 가능성이 확인되자 내부 개발 일부를 중단했다.
영상의 연속된 두 프레임 사이 픽셀 이동을 벡터로 표현하는 Optical Flow의 원리와, Sparse·Dense 방식의 차이를 정리한다.
사람이나 동물의 관절 위치(키포인트)를 찾아 자세를 인식하는 Pose Estimation의 원리와 OpenPose 같은 대표 접근법을 정리한다.
AI 음악 생성 서비스 Suno의 v5 모델이 이전 버전 대비 어떤 점이 개선됐는지, 보컬 품질과 v5.5의 개인화 기능을 중심으로 정리한다.
Google DeepMind의 영상 생성 모델 Veo 3.1이 이전 버전 대비 어떤 점이 달라졌는지, 오디오·해상도·일관성 개선을 중심으로 정리한다.
Agentic AI와 AI Agent라는 두 용어가 실제로 어떻게 다르게 쓰이는지, 왜 이 구분이 실무에서 중요한지 정리한다.
AI Agent가 일반 챗봇·LLM 호출과 무엇이 다른지 Anthropic의 공식 정의를 기준으로 정리하고, 언제 에이전트가 필요한지 설명한다.
LLM을 GPU에서 돌릴 때 VRAM이 병목이 되는 이유와, 파라미터 수·양자화 수준에 따라 VRAM 사용량이 어떻게 달라지는지 정리한다.
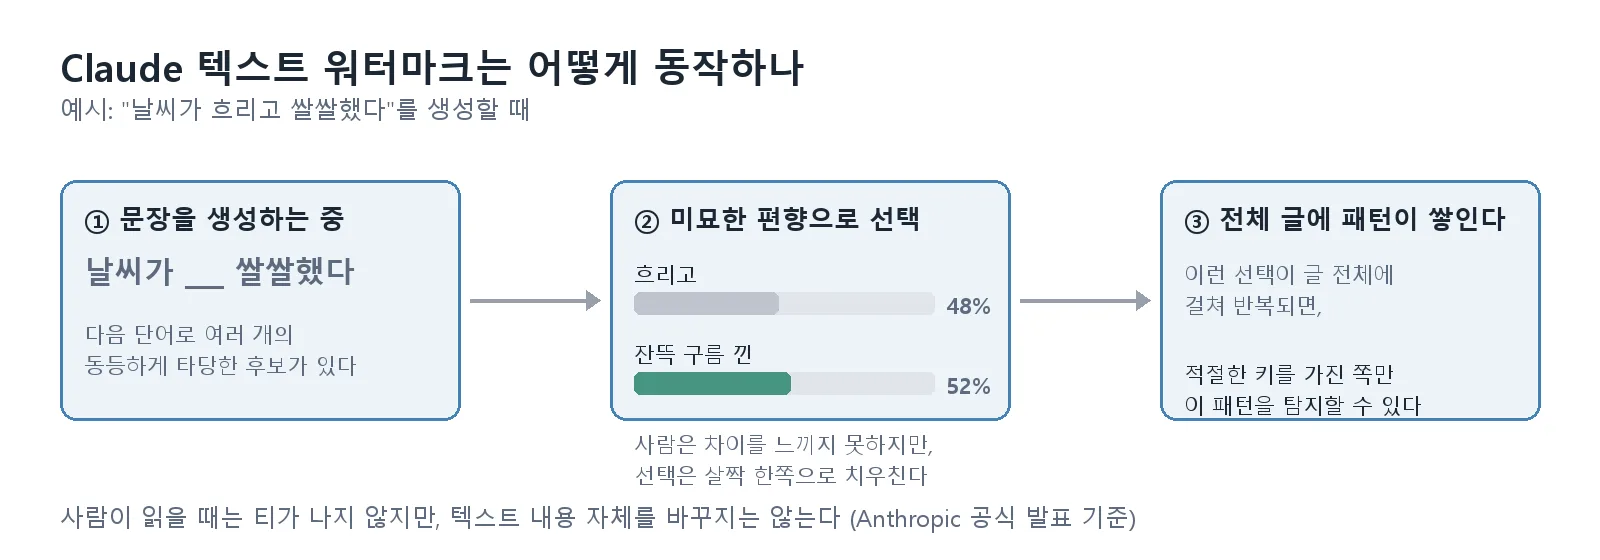
Anthropic이 EU AI Act의 투명성 규정에 대응해 Claude가 생성하는 텍스트에 보이지 않는 워터마크를 전 세계 공통으로 적용하기 시작했다.
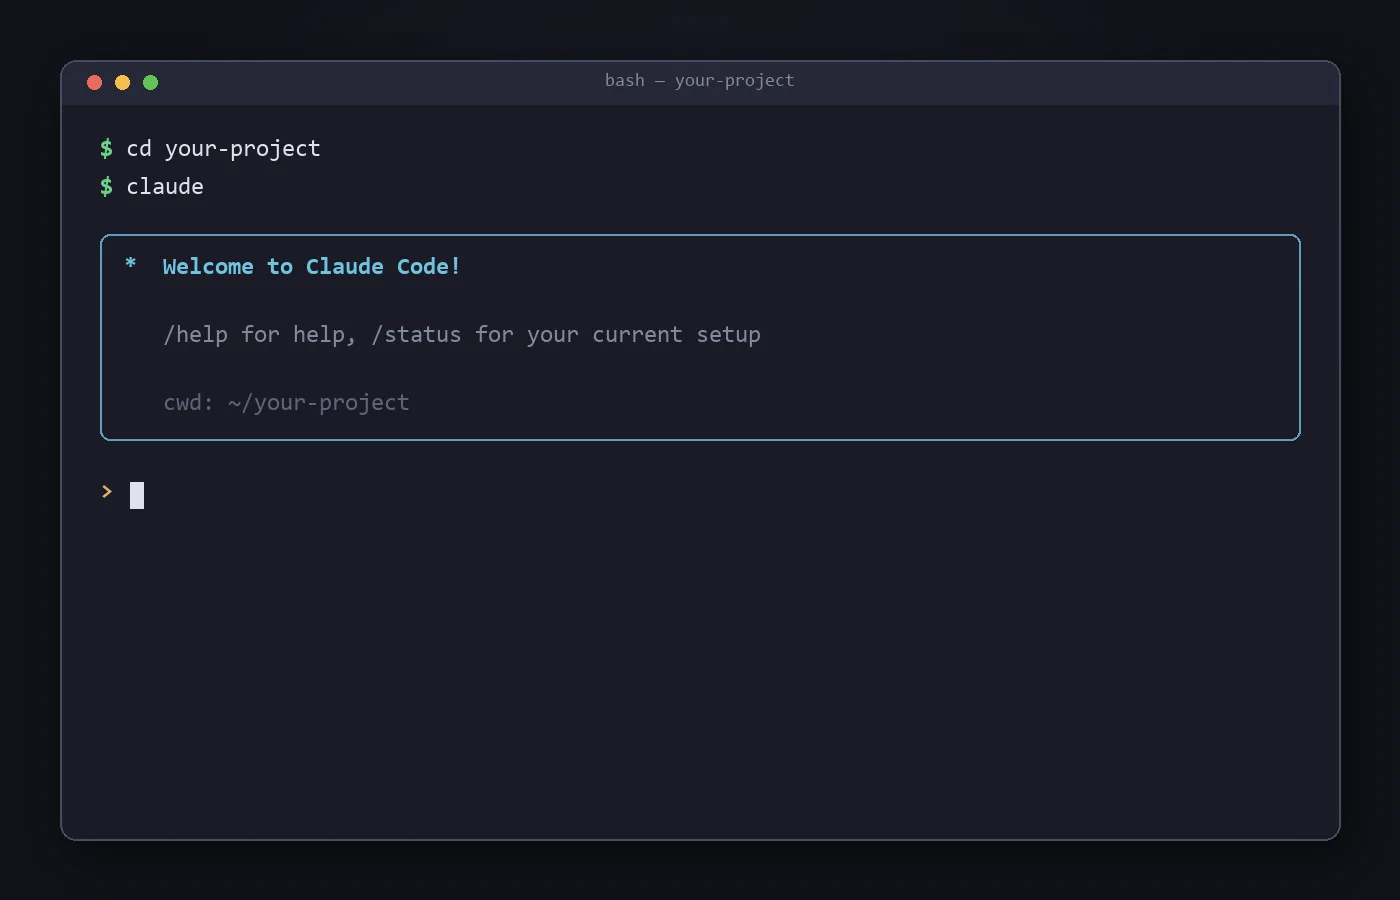
Anthropic의 에이전틱 코딩 도구 Claude Code의 개념, 운영체제별 설치 방법, 핵심 기능, 요금제를 공식 문서를 기준으로 정리한다.
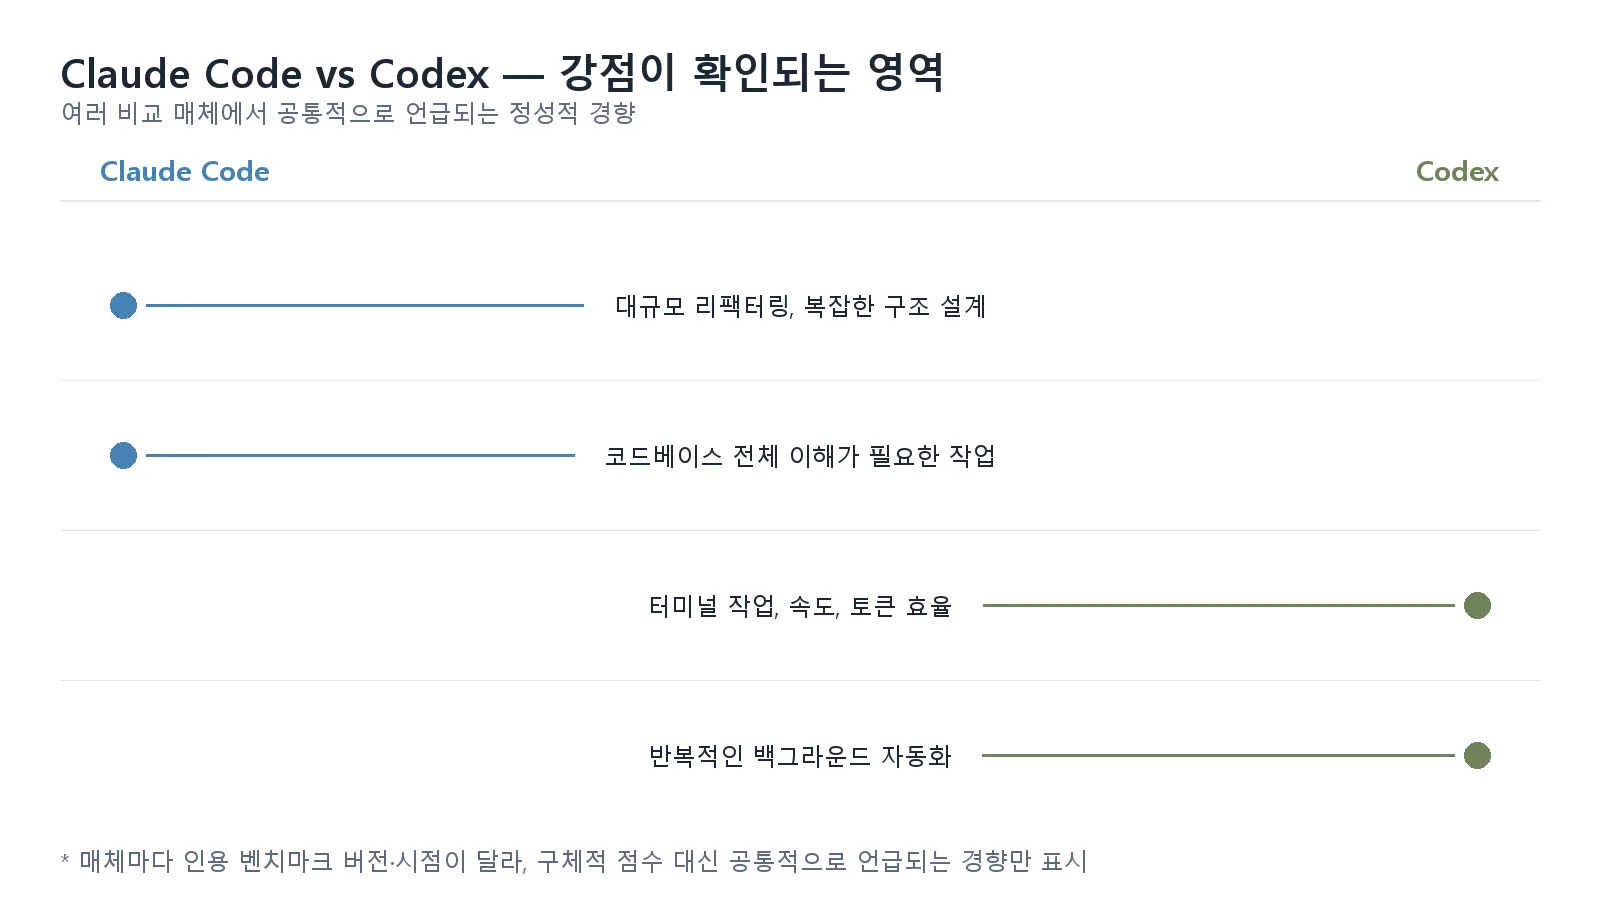
Anthropic의 Claude Code와 OpenAI의 코딩 에이전트 Codex를 모델 기반·요금제·기능·벤치마크 기준으로 비교한다.
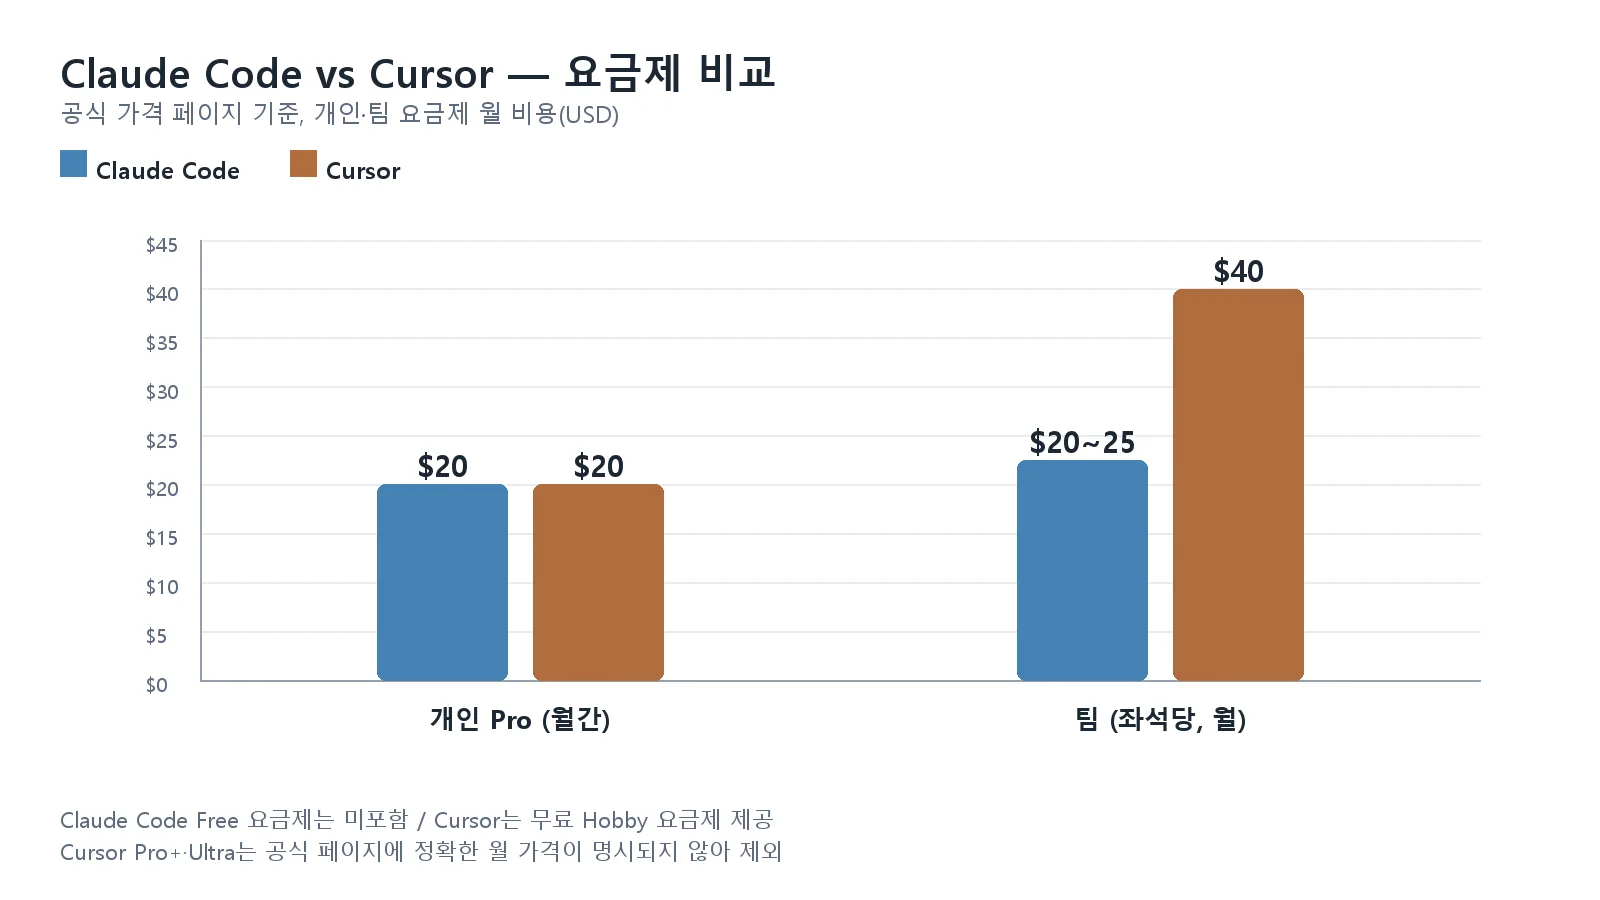
터미널 기반 에이전트 Claude Code와 IDE 기반 자동완성 도구 Cursor를 요금제·작업 방식·적합한 상황 기준으로 비교한다.
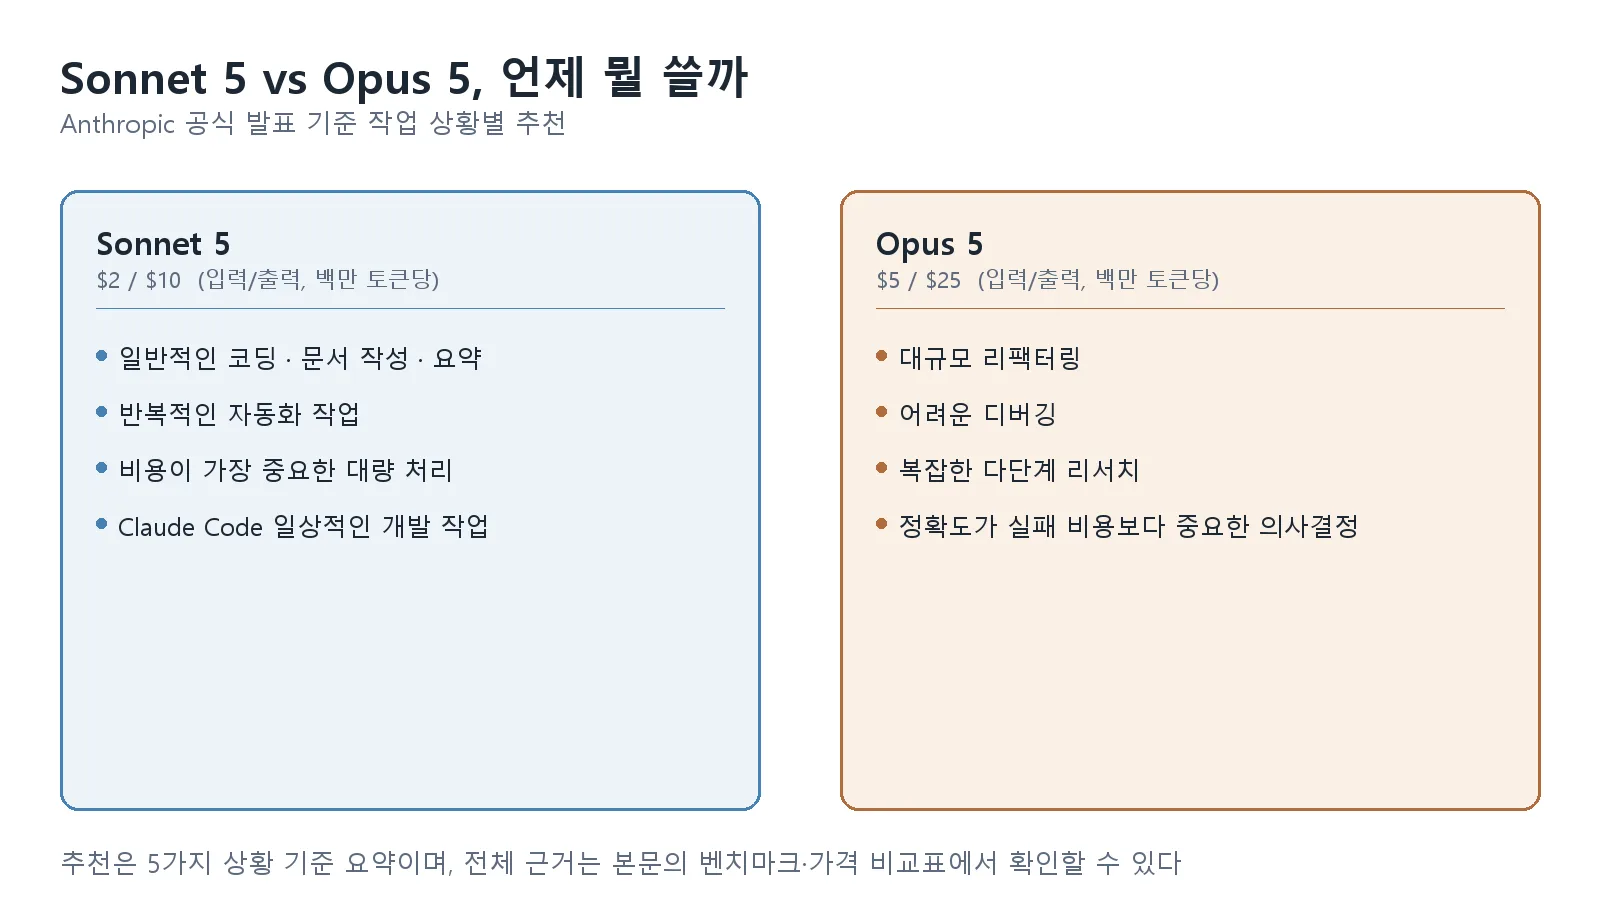
Anthropic의 최상위 모델 Opus 5와 중급 모델 Sonnet 5를 가격·성능·용도 기준으로 비교하고, 어떤 작업에 어떤 모델이 적합한지 정리한다.
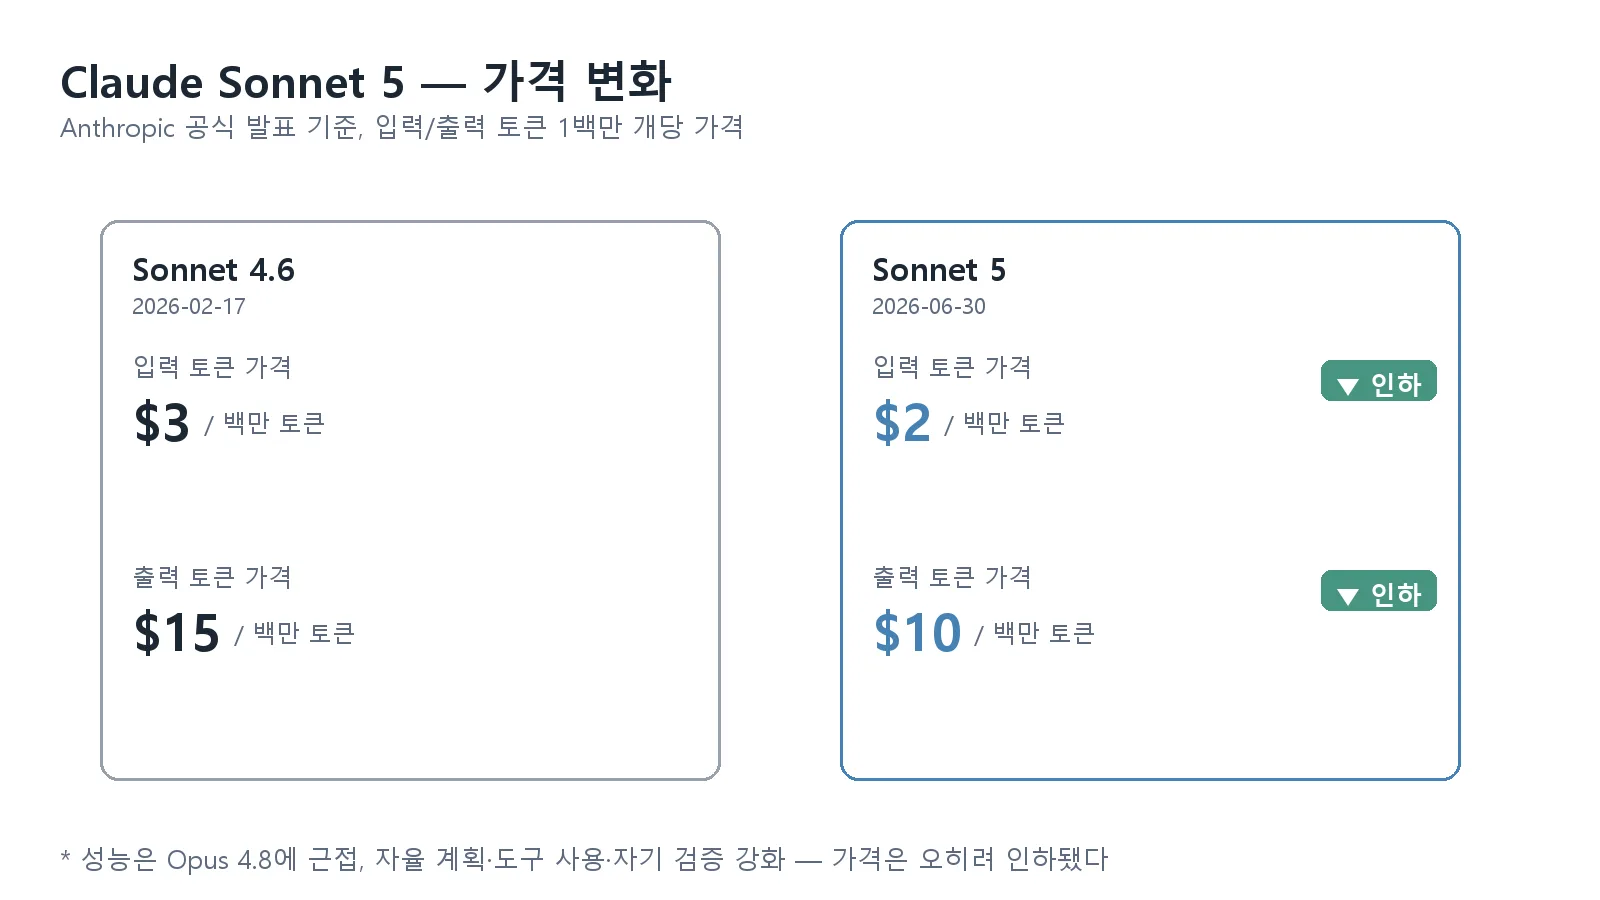
Anthropic이 2026년 6월 출시한 Claude Sonnet 5가 이전 모델 Sonnet 4.6과 가격·성능·기능 면에서 어떻게 다른지 공식 발표를 기준으로 정리한다.
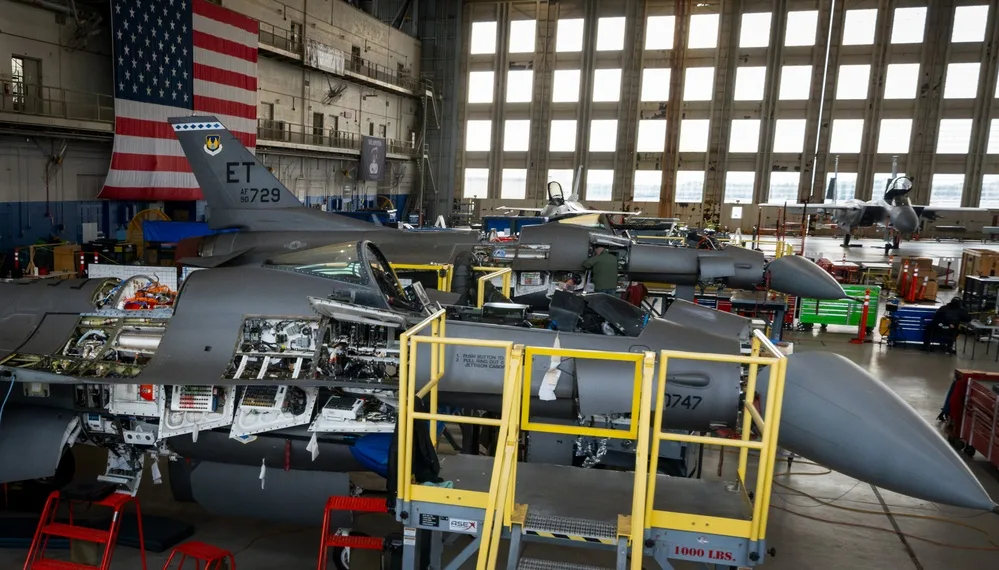
DARPA와 미 공군이 VENOM 프로그램으로 개조한 F-16 전투기를 AI 통제 하에 비행시키는 시험을 공개했다.
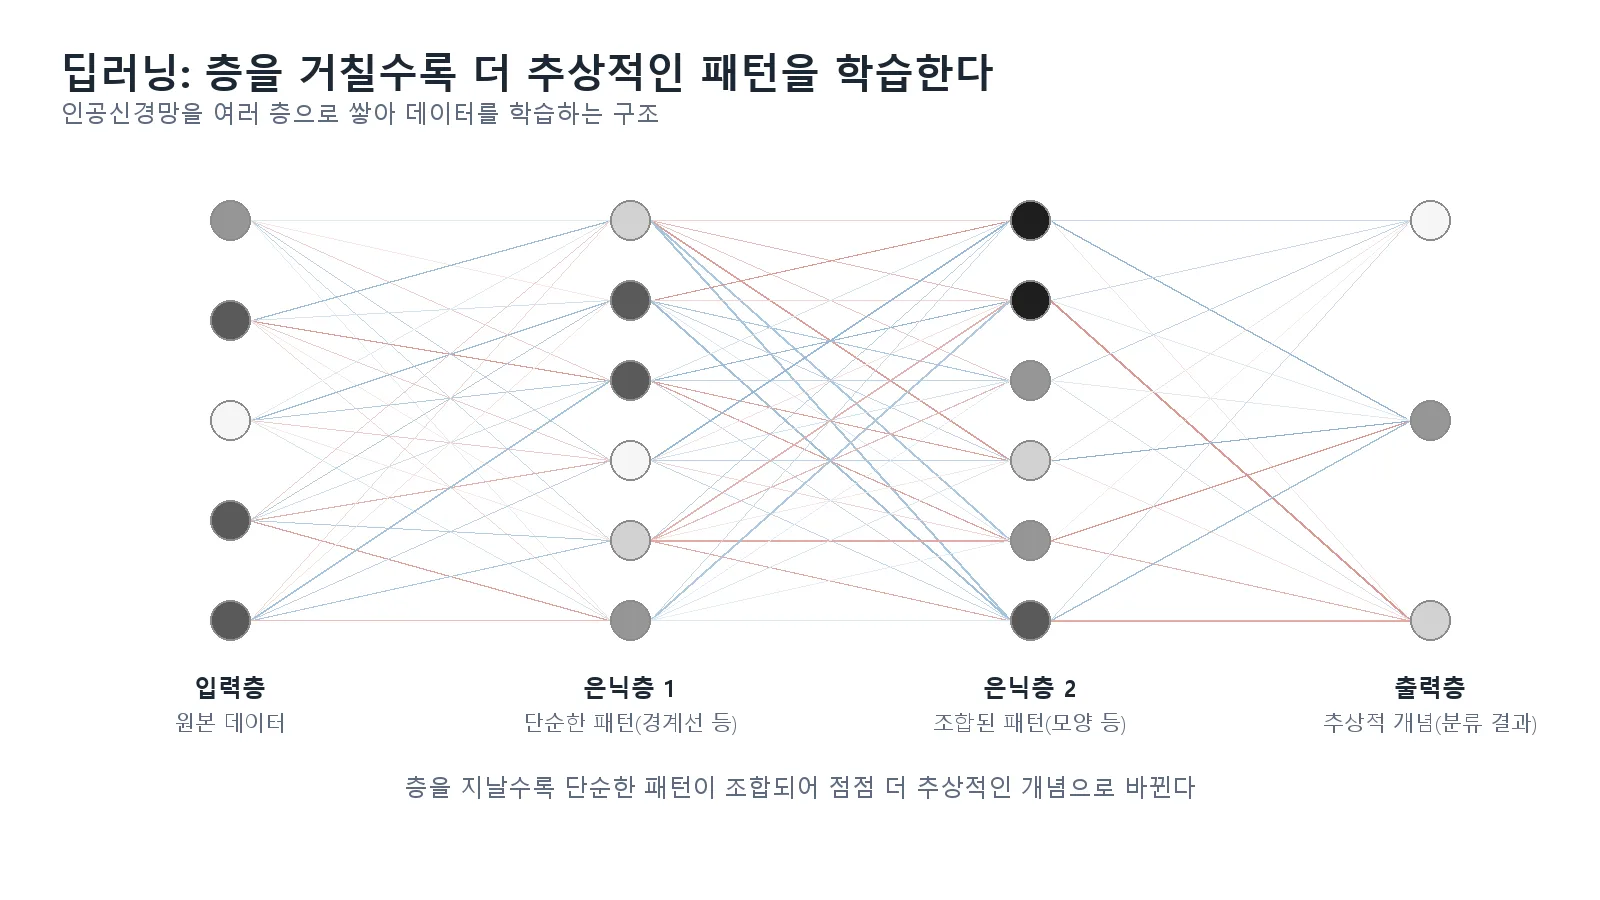
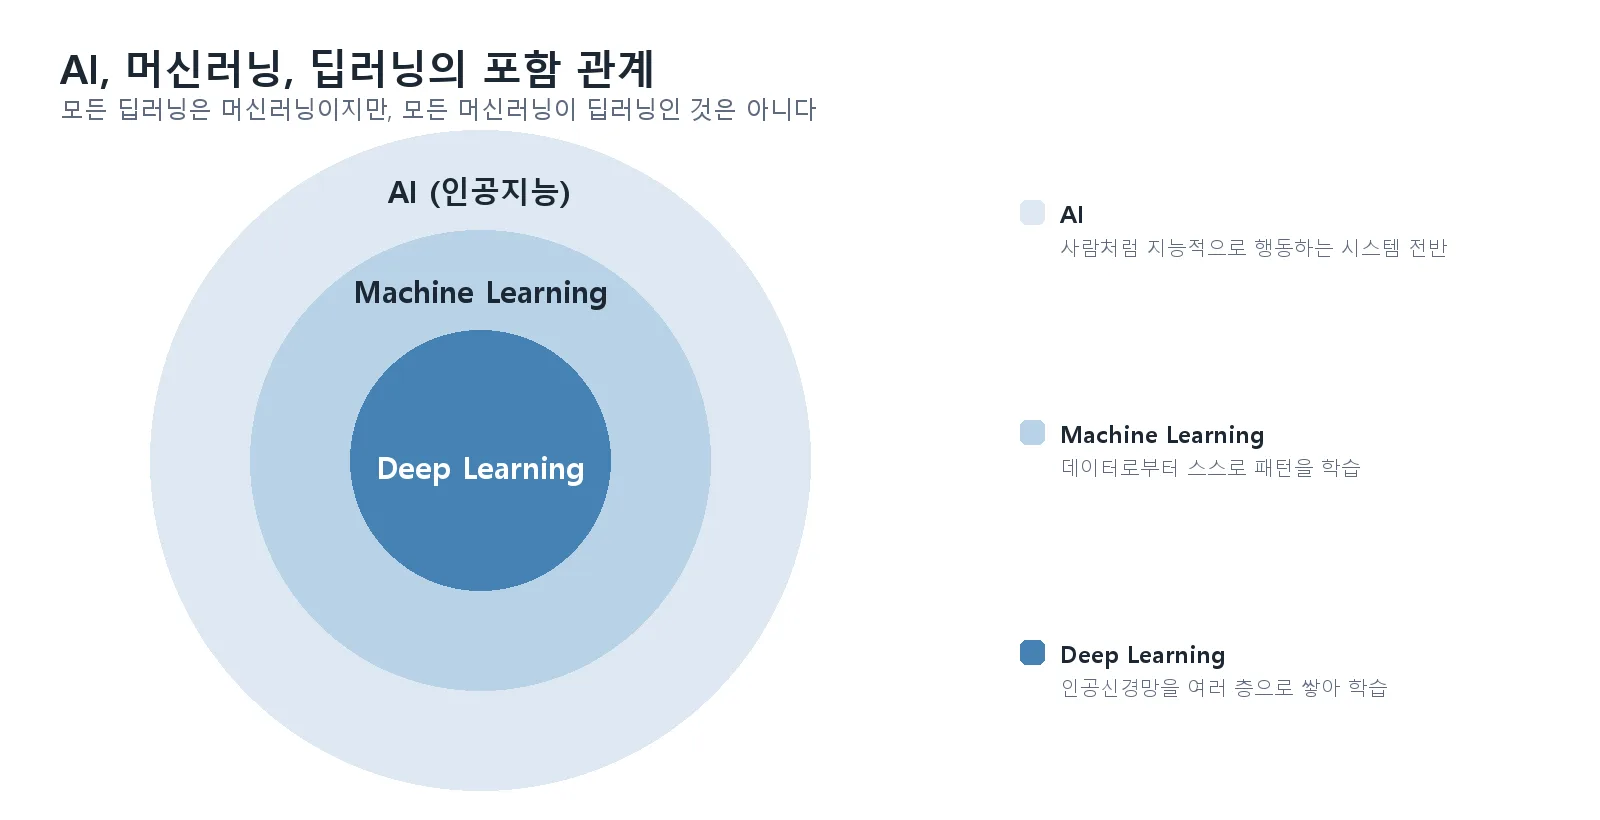
인공신경망을 여러 층으로 쌓아 이미지·텍스트 같은 비정형 데이터를 학습하는 딥러닝의 원리와, 머신러닝과의 실질적 차이를 정리한다.
구글 딥마인드가 데미스 하사비스를 CEO에서 이사회 의장 겸 알파벳 수석과학자로 전환하고, Koray Kavukcuoglu가 일상 운영을 맡는 조직 개편을 단행했다.
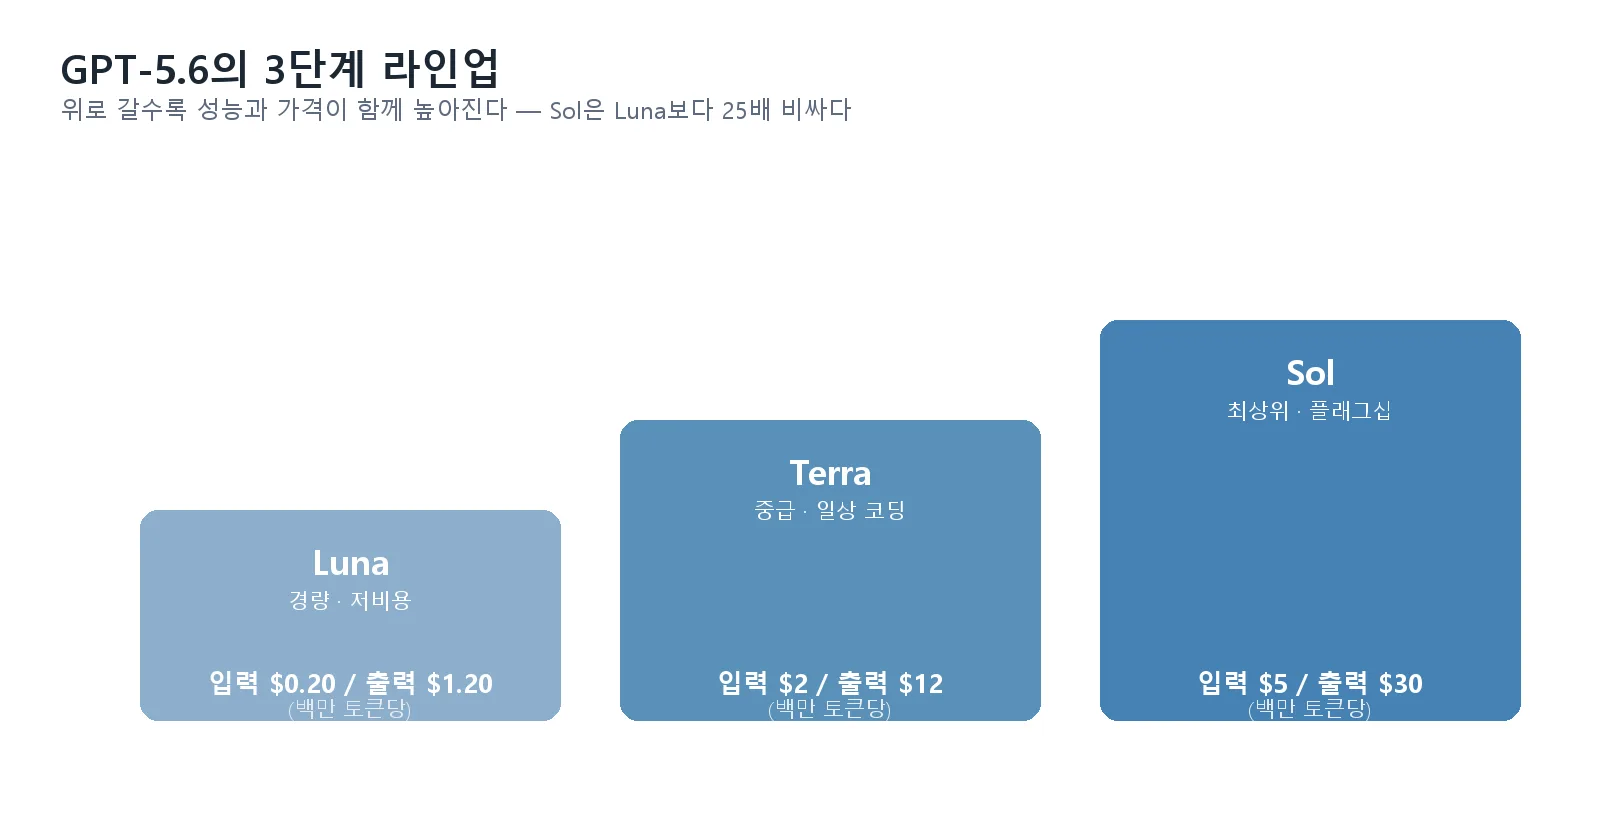
OpenAI가 2026년 7월 공개한 GPT-5.6의 3단계 라인업(Luna·Terra·Sol)과 가격, 핵심 성능 개선 내용을 정리한다.
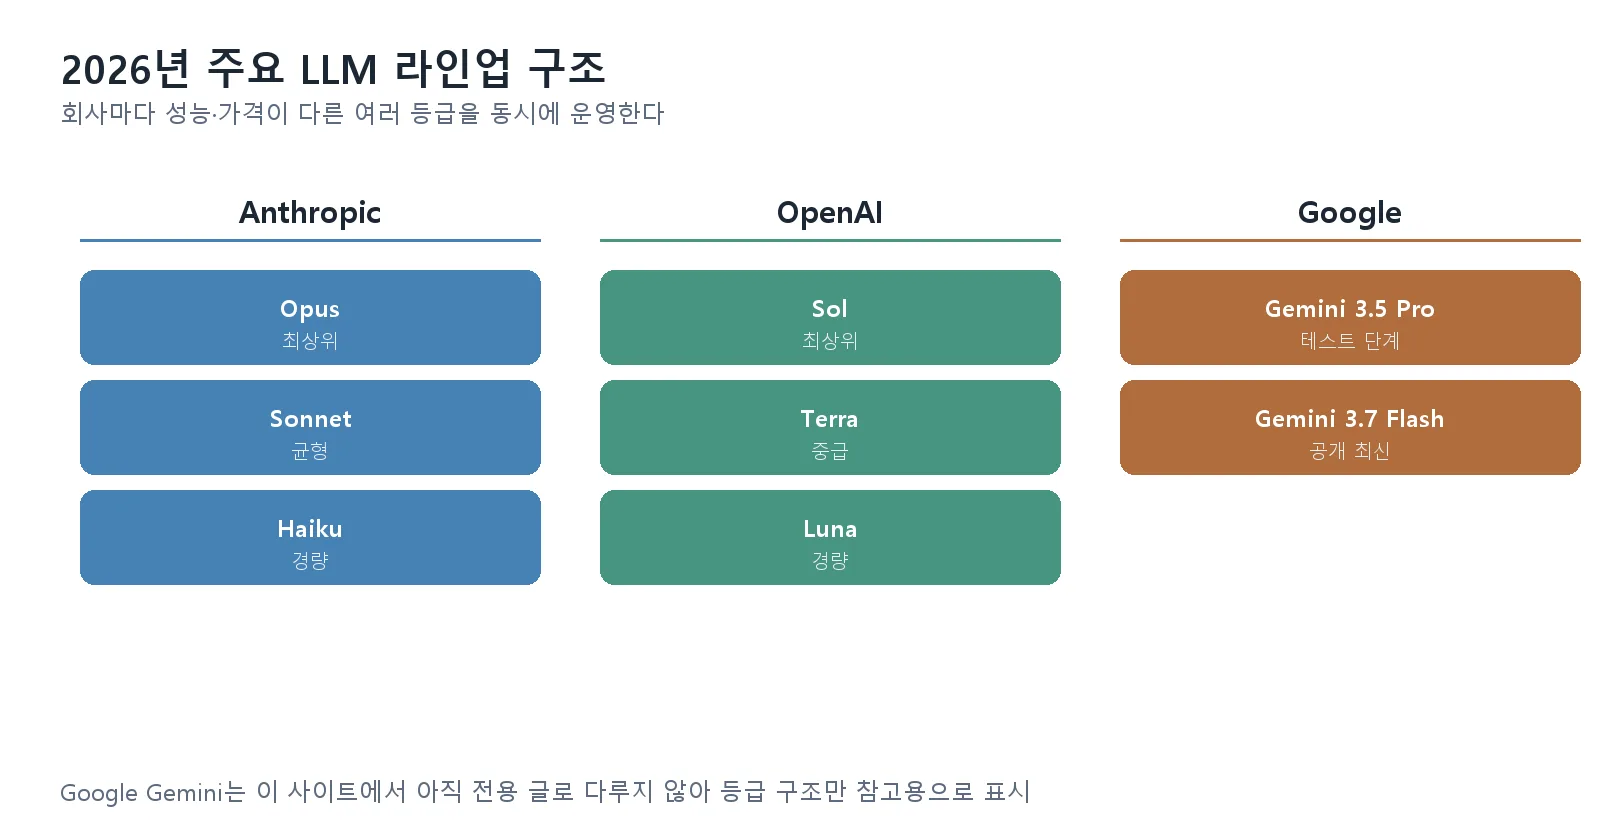
Anthropic Claude, OpenAI GPT, Google Gemini 등 주요 LLM 계열을 한 곳에 정리하고, 이 사이트에서 다룬 각 모델별 상세 글로 연결한다.
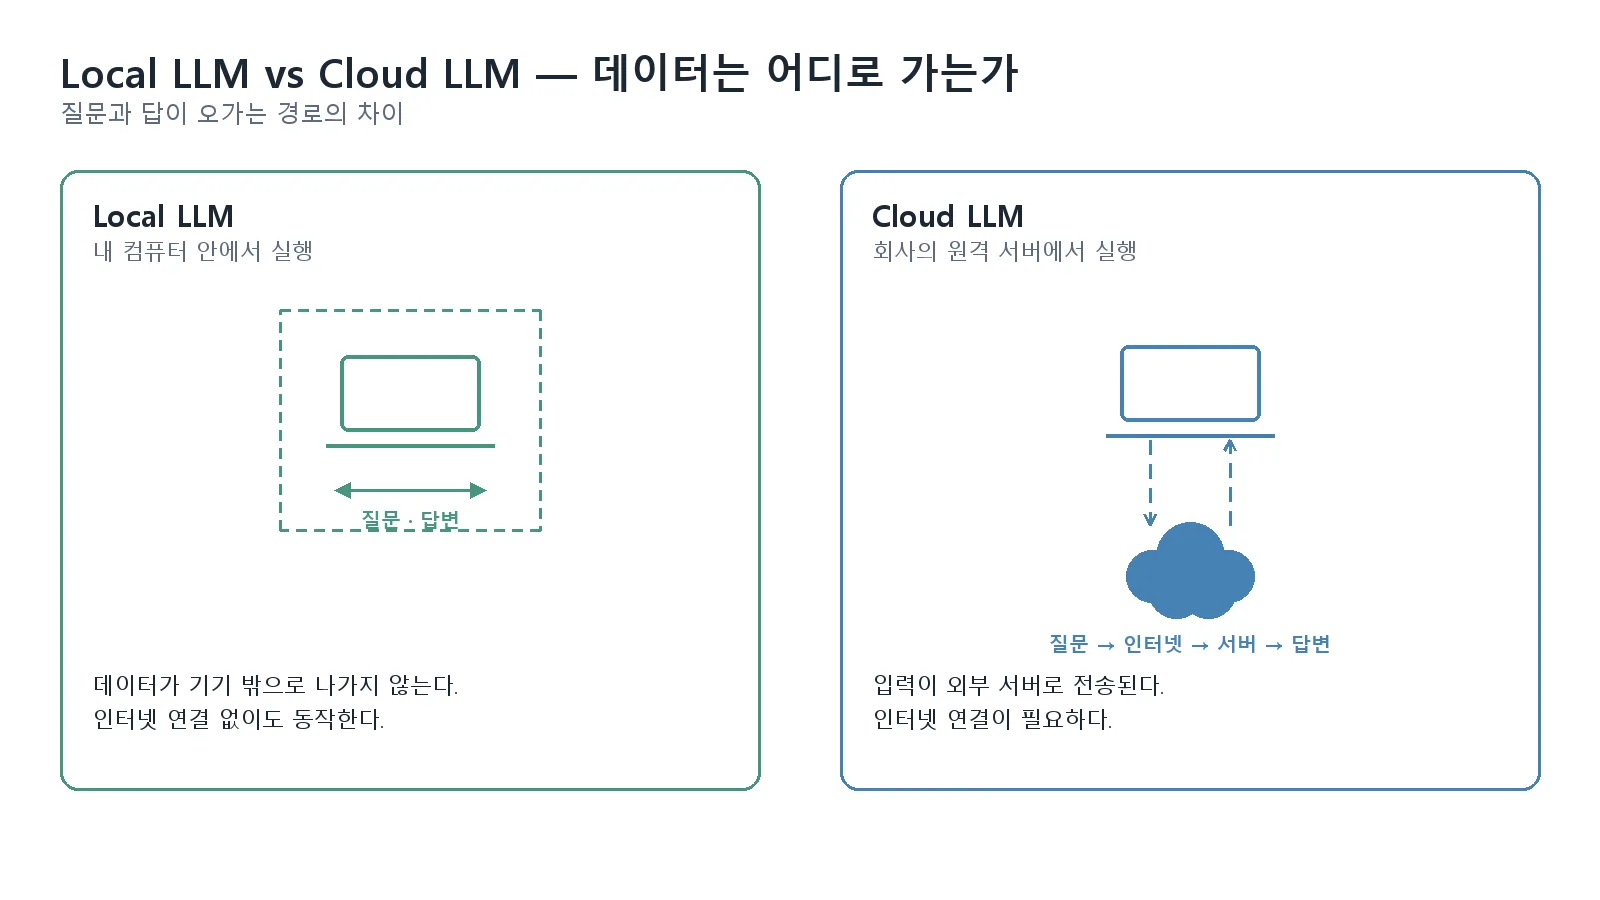
내 컴퓨터에서 직접 실행하는 Local LLM이 ChatGPT·Claude 같은 Cloud LLM과 무엇이 다른지, 언제 유리한지 정리한다.
LM Studio, Ollama로 로컬 LLM을 돌릴 때 모델 크기별로 어느 정도 VRAM의 GPU가 필요한지, 예산별 선택 기준을 정리한다.
AI, 머신러닝, 딥러닝의 관계를 정리하고, 머신러닝이 데이터를 통해 스스로 규칙을 학습하는 방식을 설명한다.
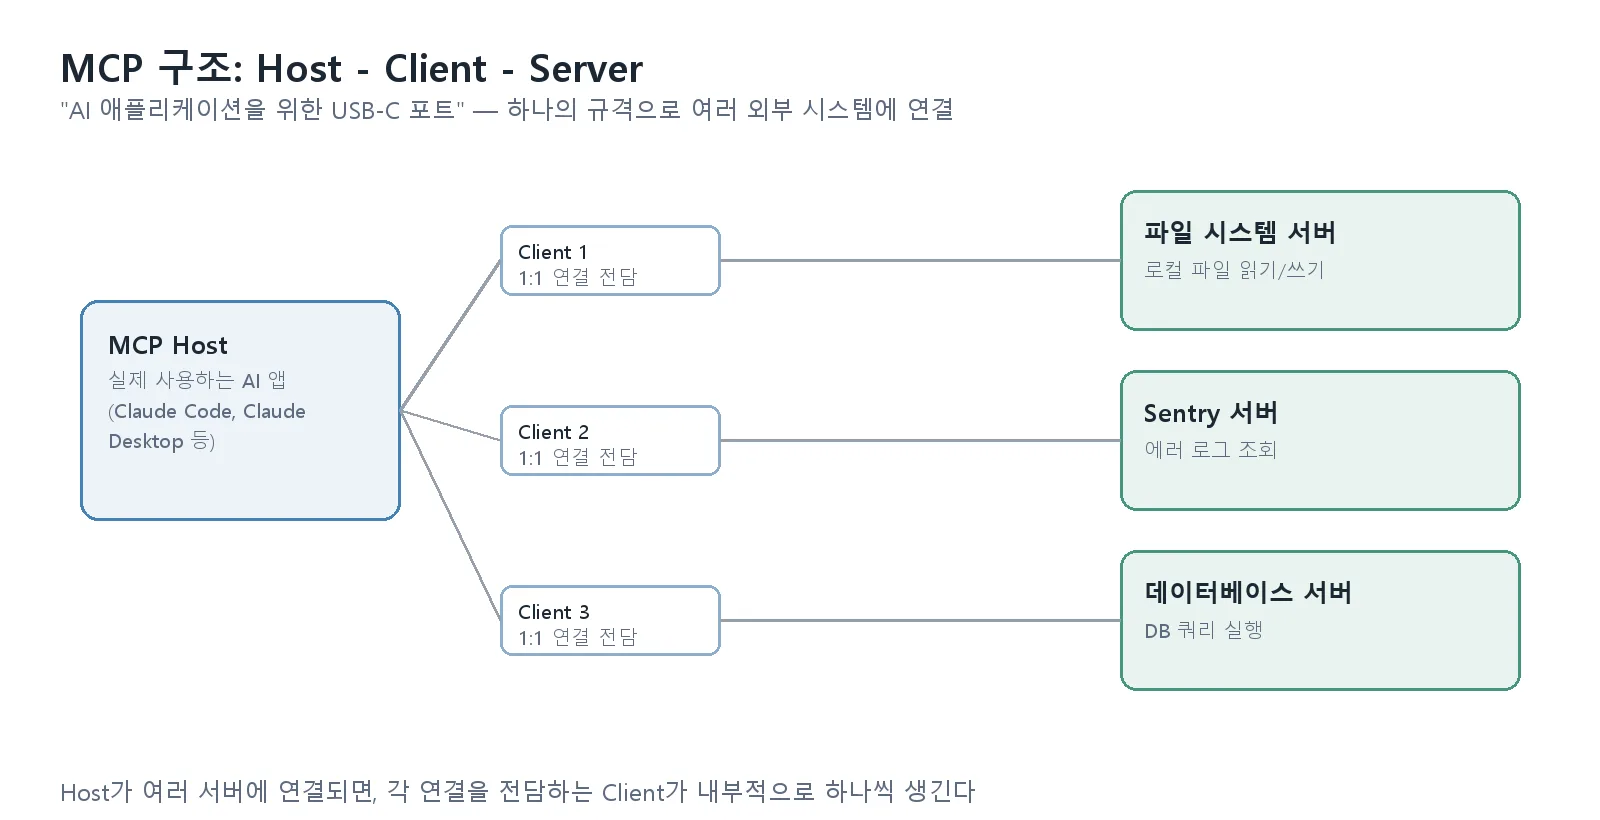
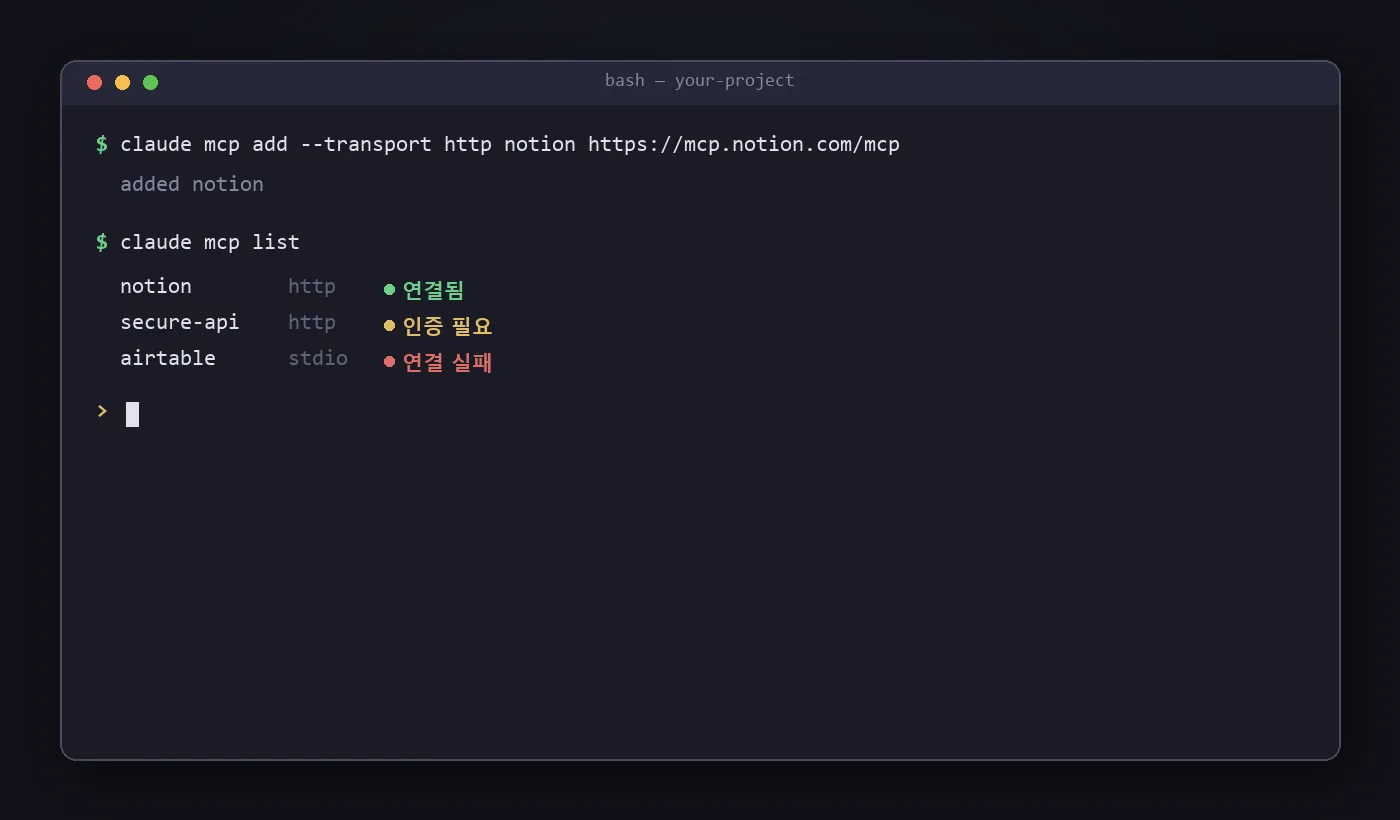
AI 애플리케이션을 외부 도구·데이터와 연결하는 개방형 표준 MCP(Model Context Protocol)의 개념과 구조, 등장 배경을 정리한다.
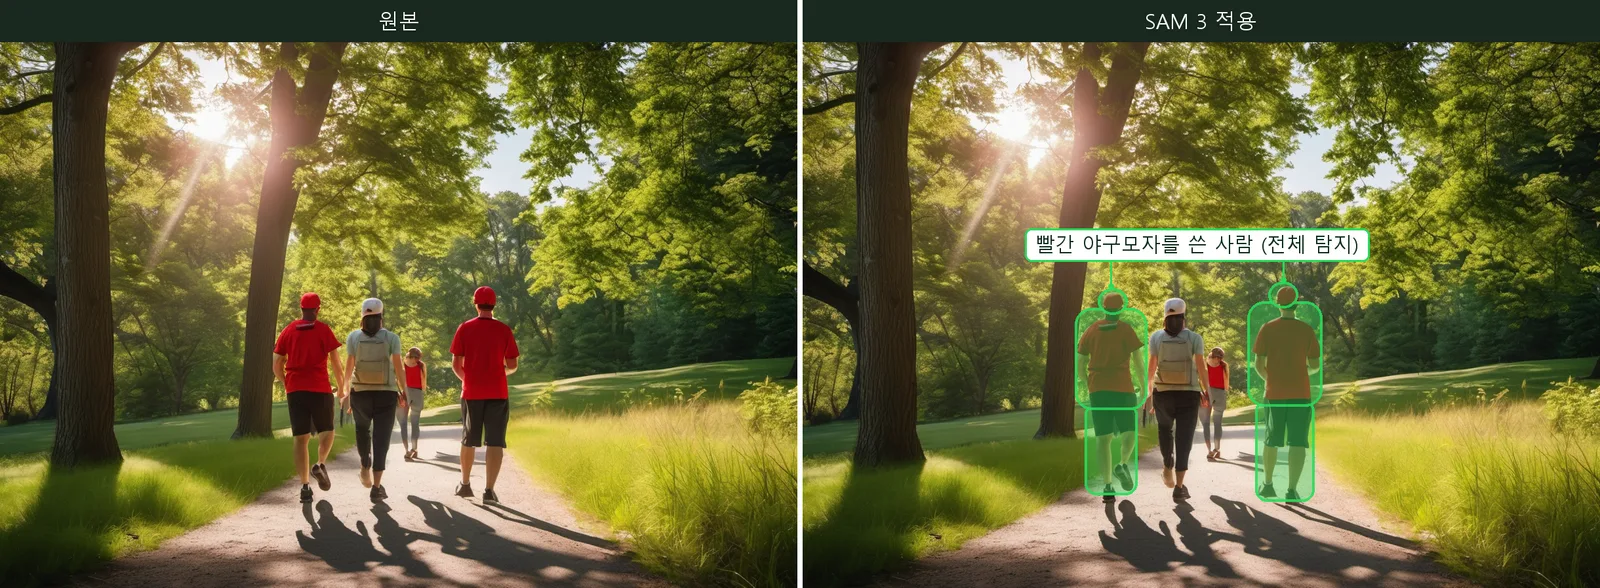
Meta AI Research가 텍스트·이미지 예시로 지정한 개념에 해당하는 모든 인스턴스를 분할·추적하는 SAM 3을 공개했다.
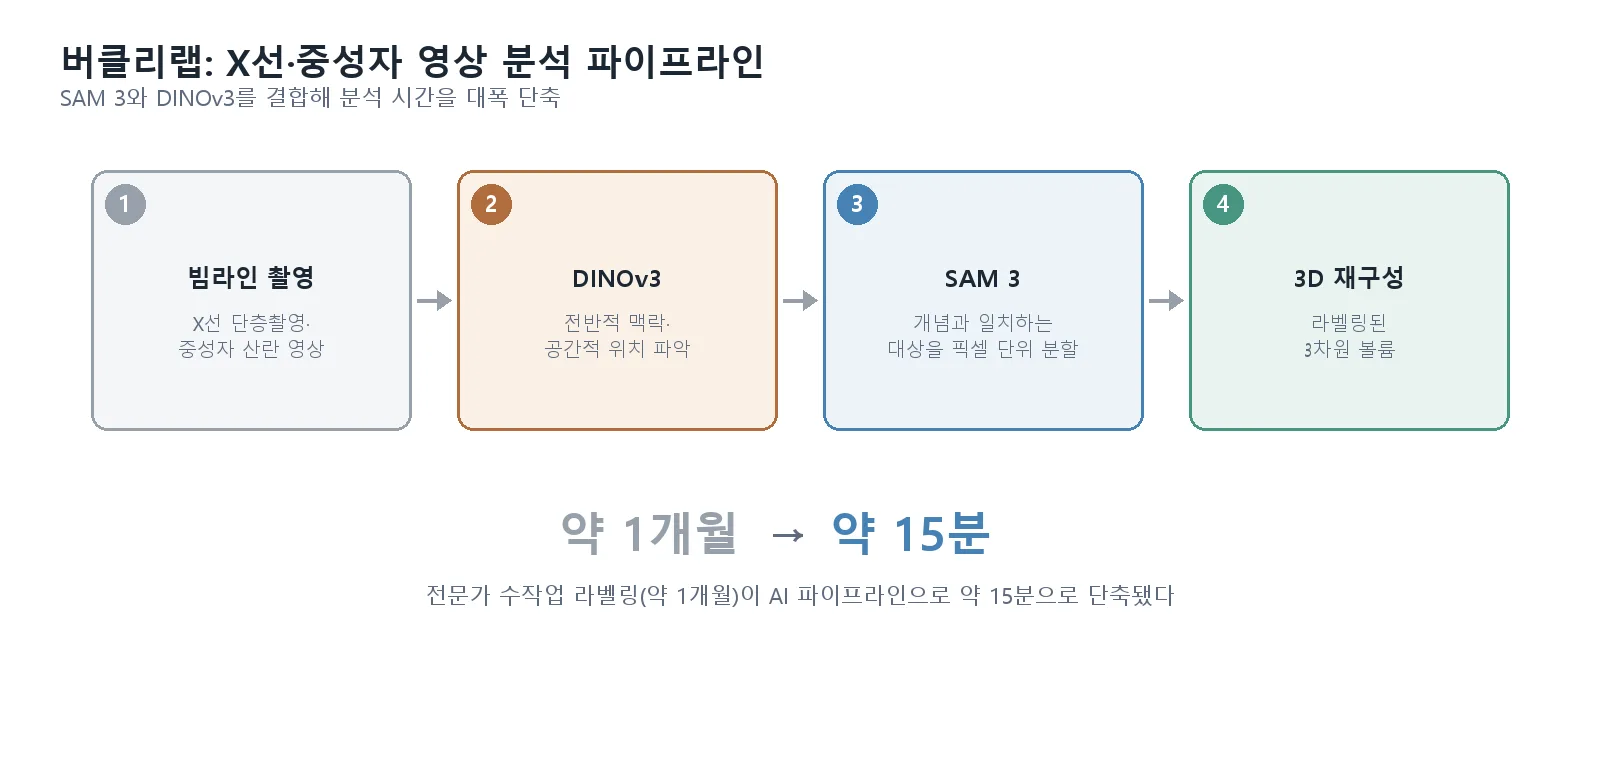
미 에너지부 산하 버클리랩이 Meta의 오픈소스 비전 모델 SAM 3와 DINOv3를 활용해 빔라인 과학 영상 분석 시간을 대폭 줄인 SYNAPS-I 프로젝트를 진행하고 있다.
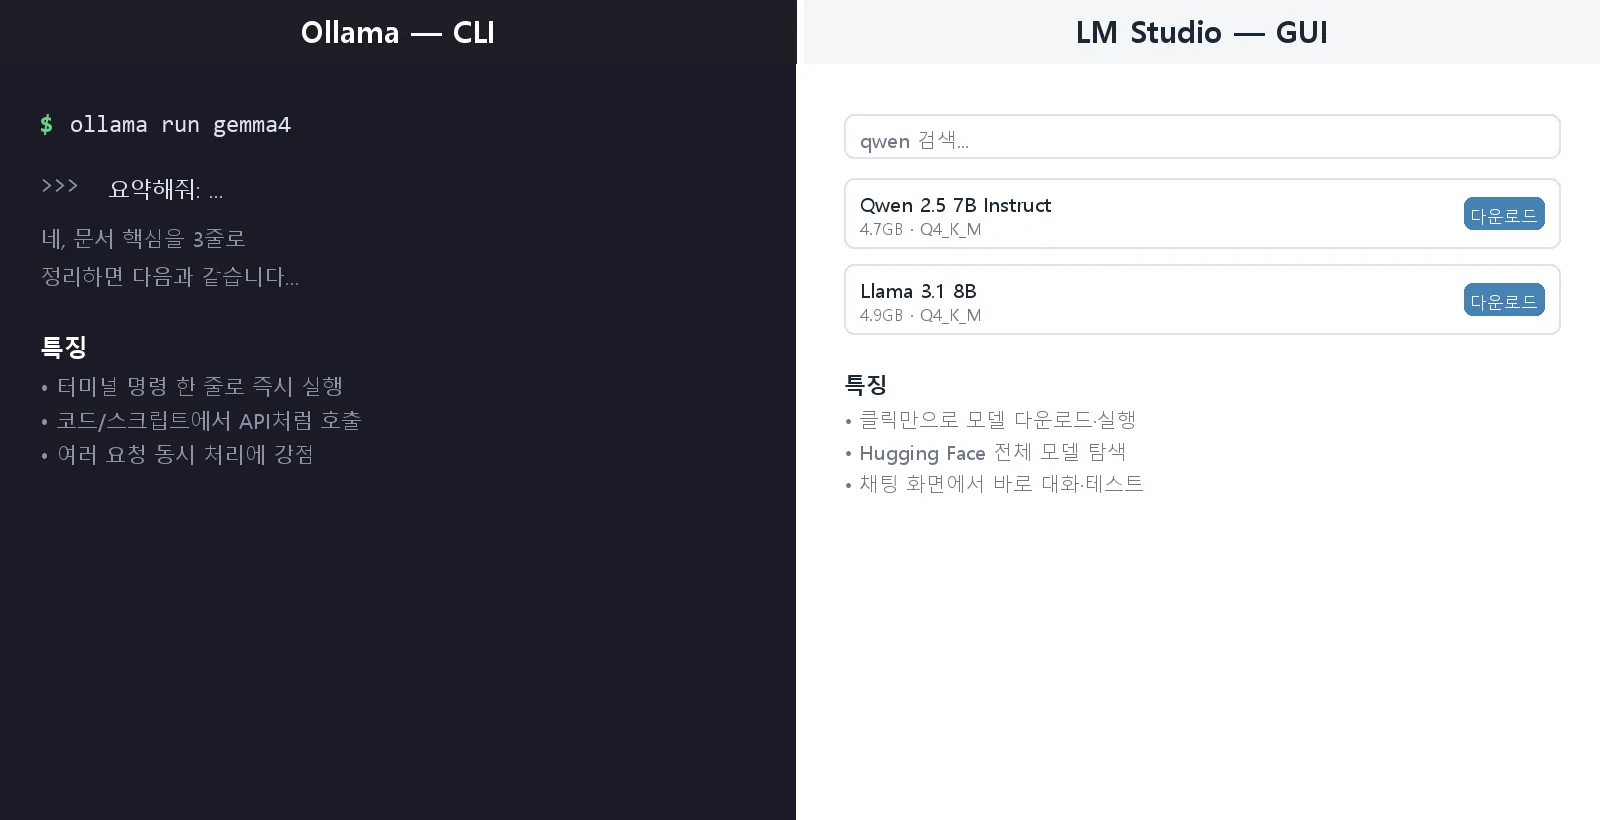
CLI 중심의 Ollama와 GUI 중심의 LM Studio를 설치 난이도·성능·용도 기준으로 비교한다.
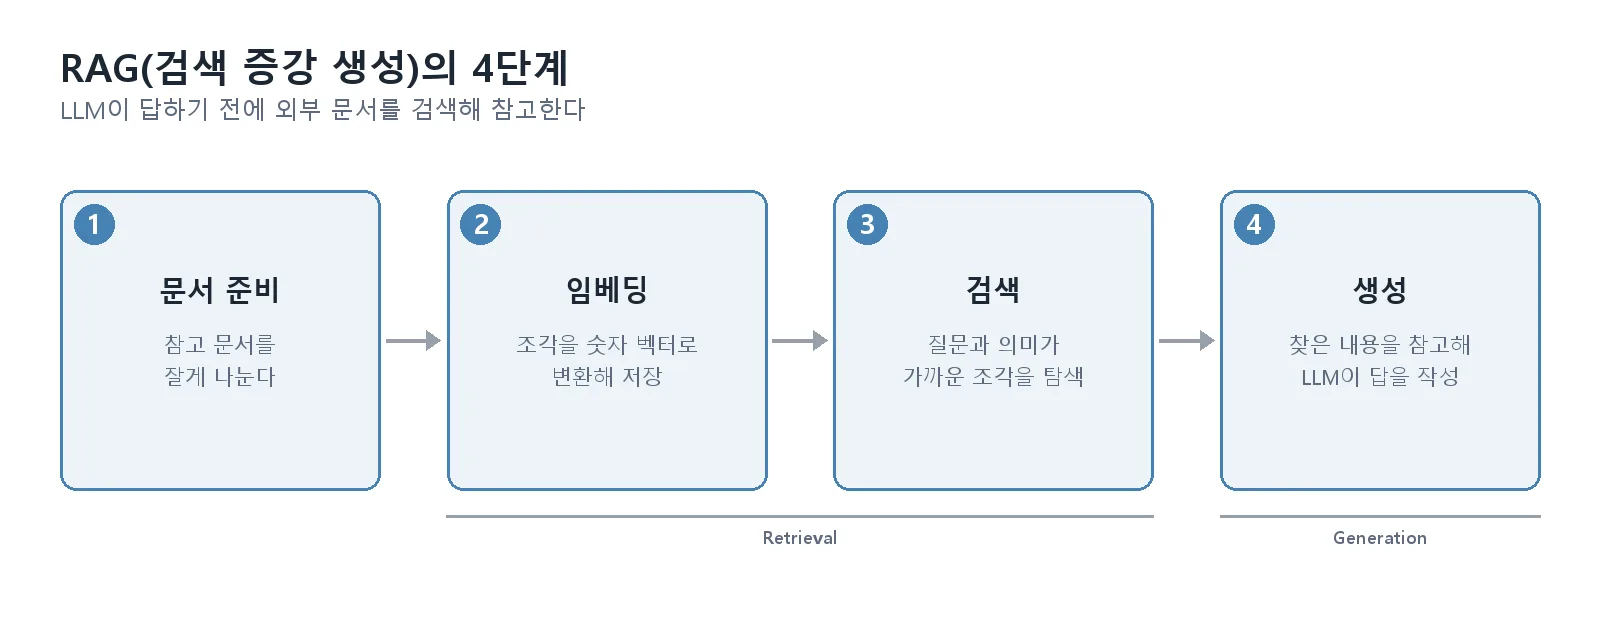
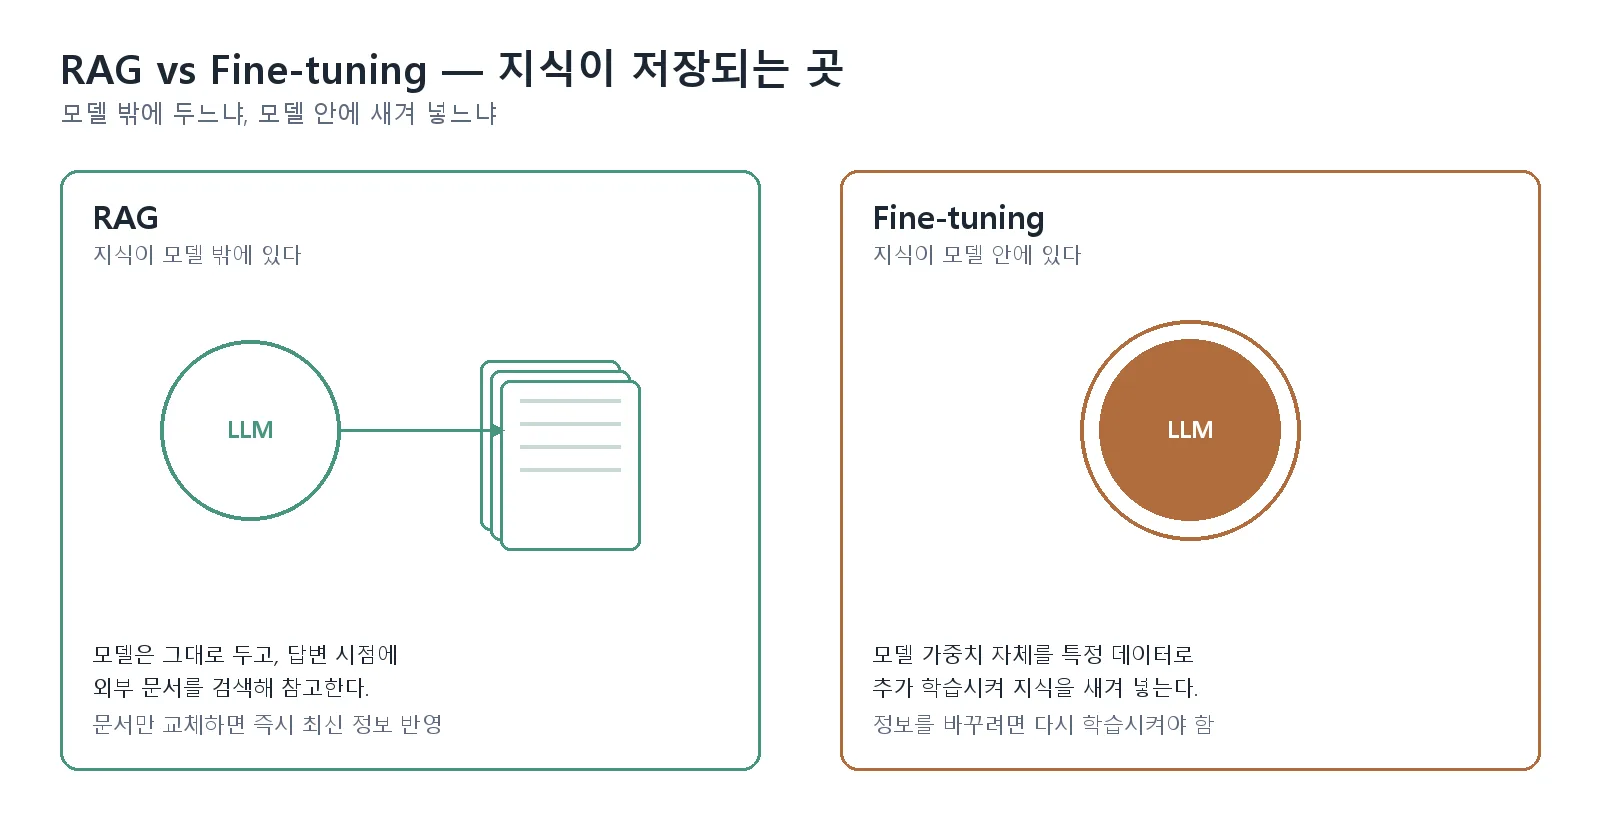
LLM을 특정 목적에 맞게 보강하는 두 가지 방법, RAG와 Fine-tuning의 차이와 각각 적합한 상황을 정리한다.
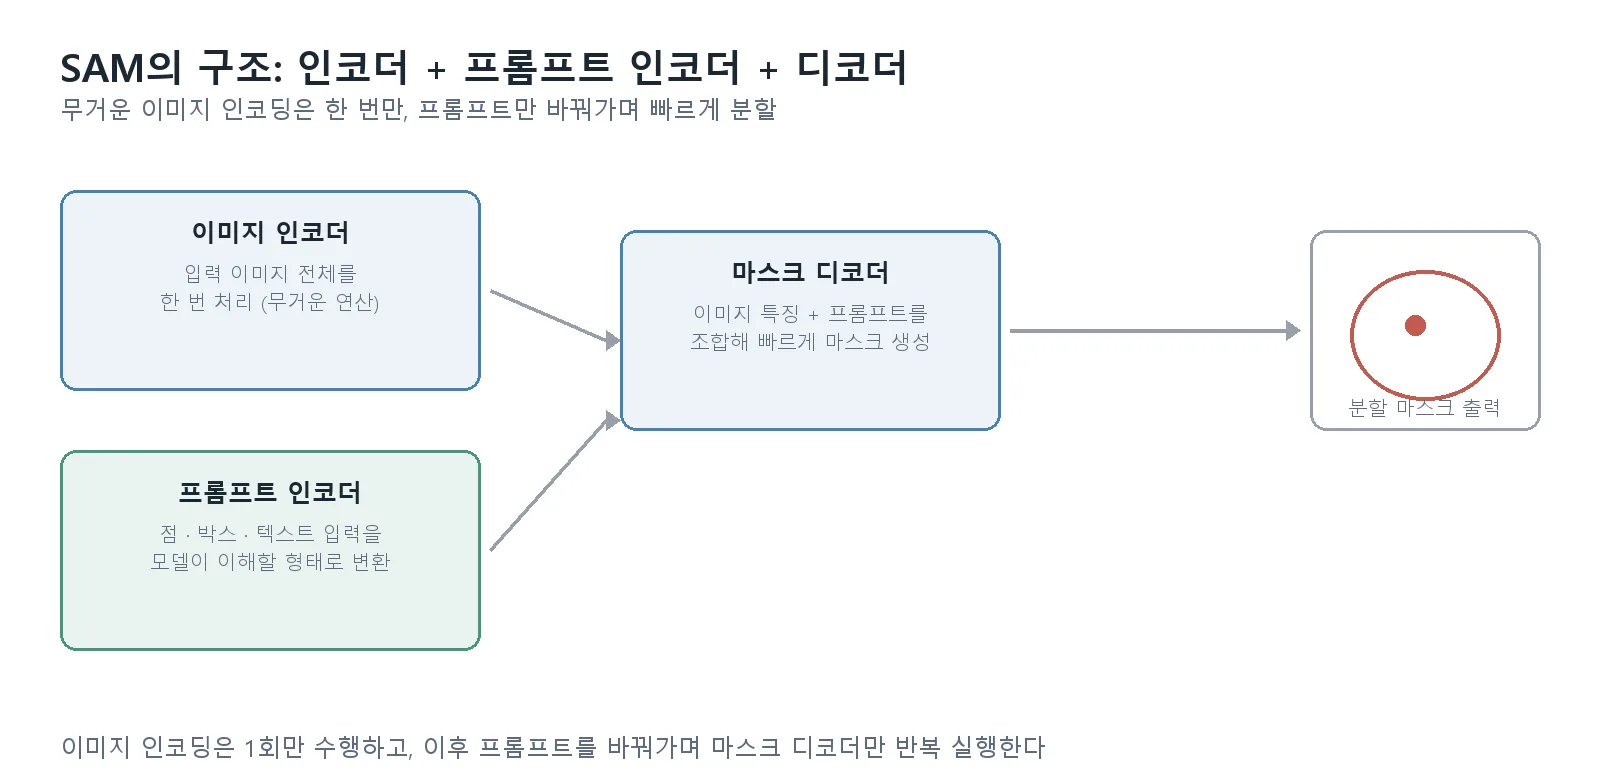
Meta AI가 공개한 범용 Segmentation 모델 SAM의 인코더-디코더 구조와 프롬프트 방식, SAM 2·SAM 3로 이어진 발전 과정을 정리한다.
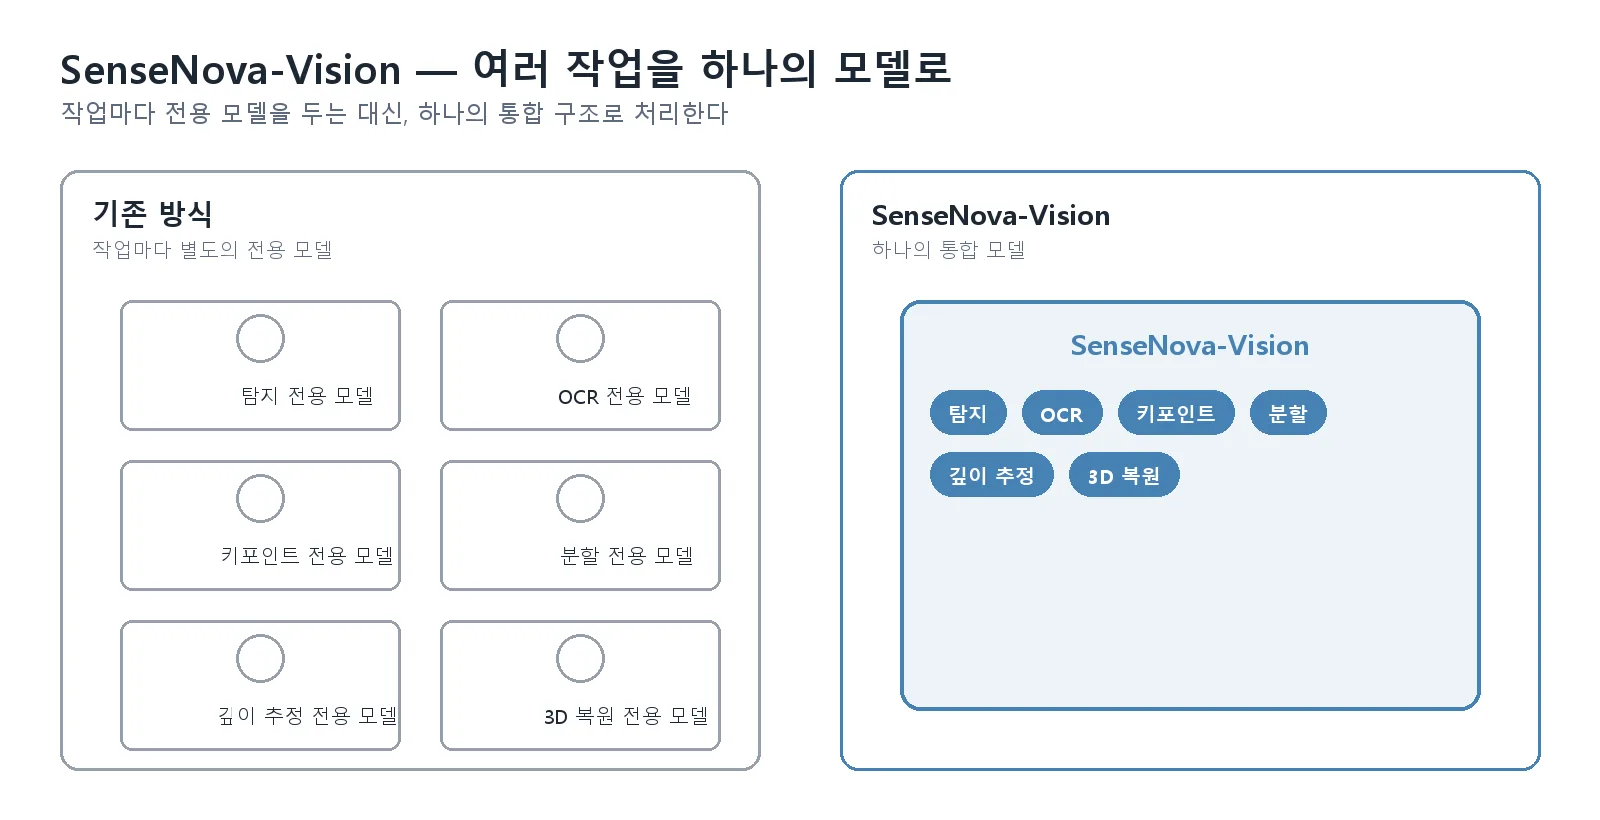
중국 AI 기업 센스타임이 탐지·분할·깊이 추정·3D 복원을 하나의 모델로 처리하는 SenseNova-Vision을 오픈소스로 공개했다.
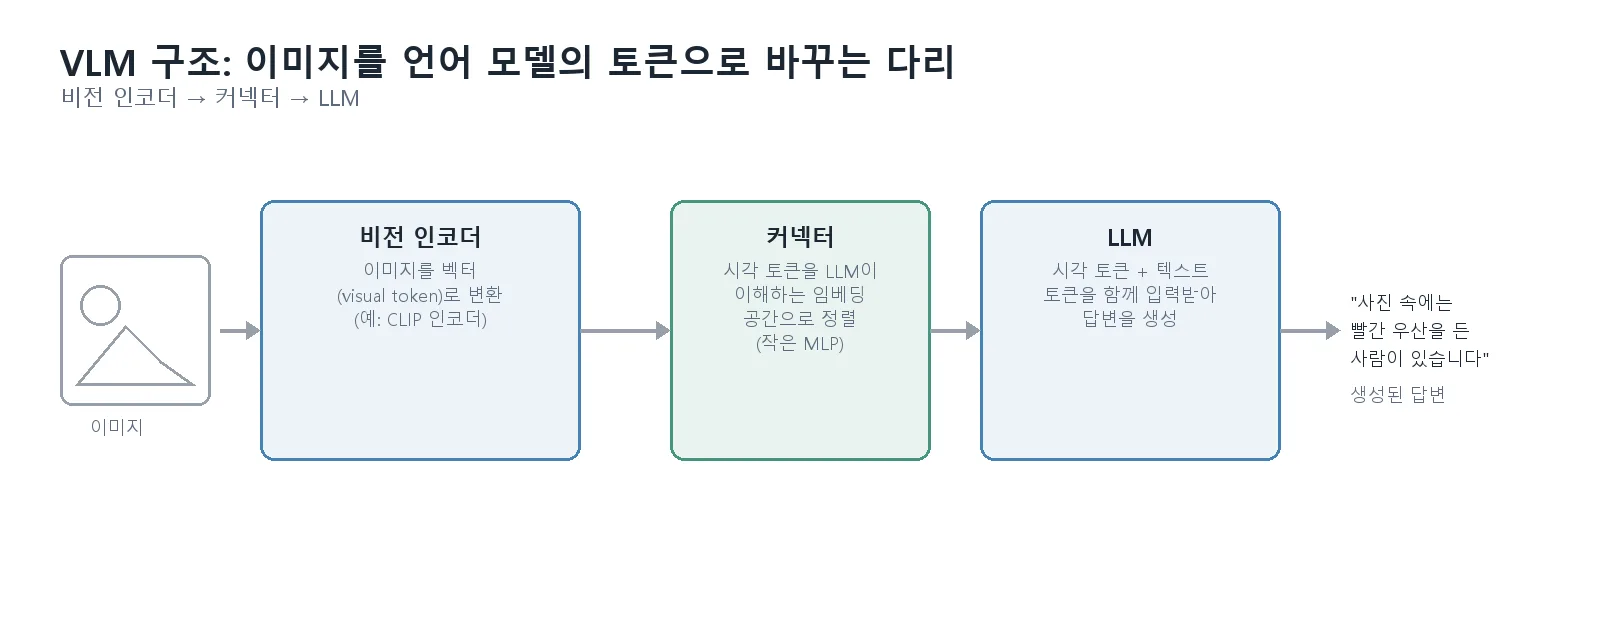
이미지와 텍스트를 함께 이해하는 Vision Language Model(VLM)이 CLIP, LLaVA 같은 구조로 어떻게 동작하는지 정리한다.
미국 정부가 AI 모델 자율 안전성 테스트 체계를 논의하기 위해 주요 AI 기업들을 백악관 회의에 초청했다.
이미지를 한 번의 순전파로 처리해 물체 위치와 클래스를 동시에 예측하는 YOLO의 기본 원리와 최신 YOLO26의 구조 변화를 정리한다.
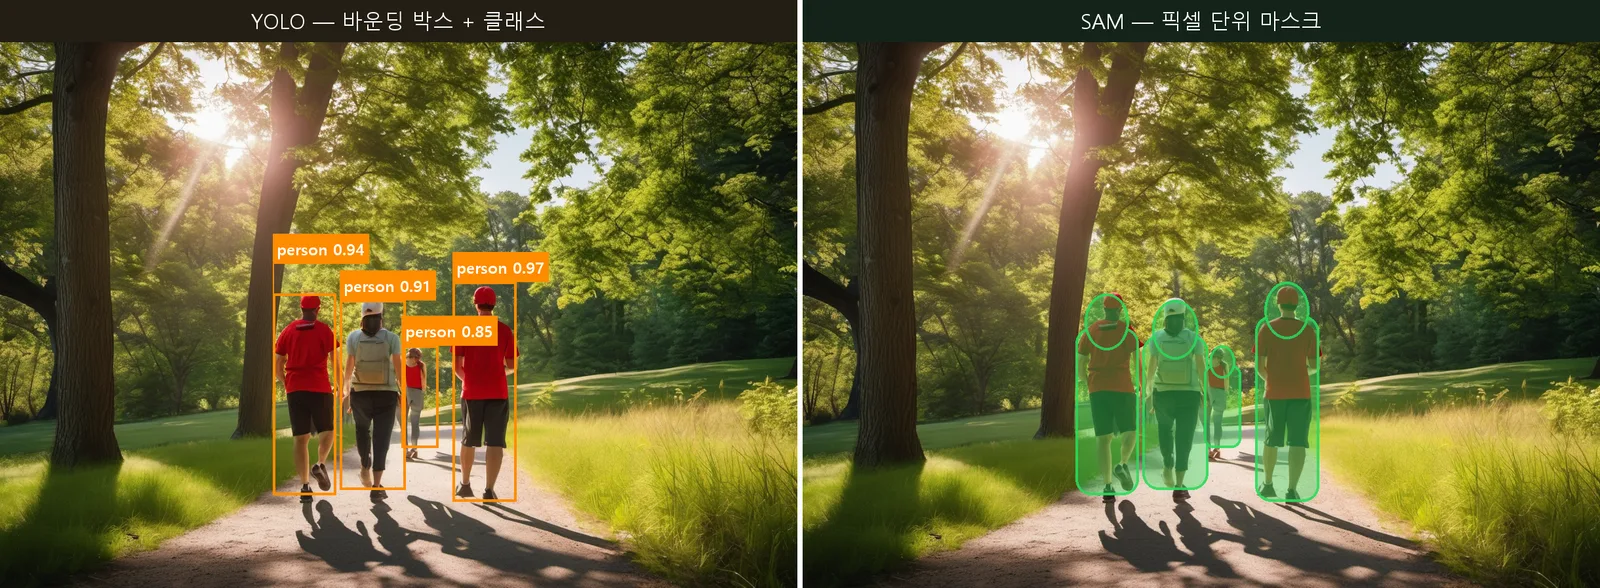
Object Detection의 대표 모델 YOLO와 Segmentation 모델 SAM이 어떤 문제를 풀고, 언제 어떤 것을 선택해야 하는지 비교한다.
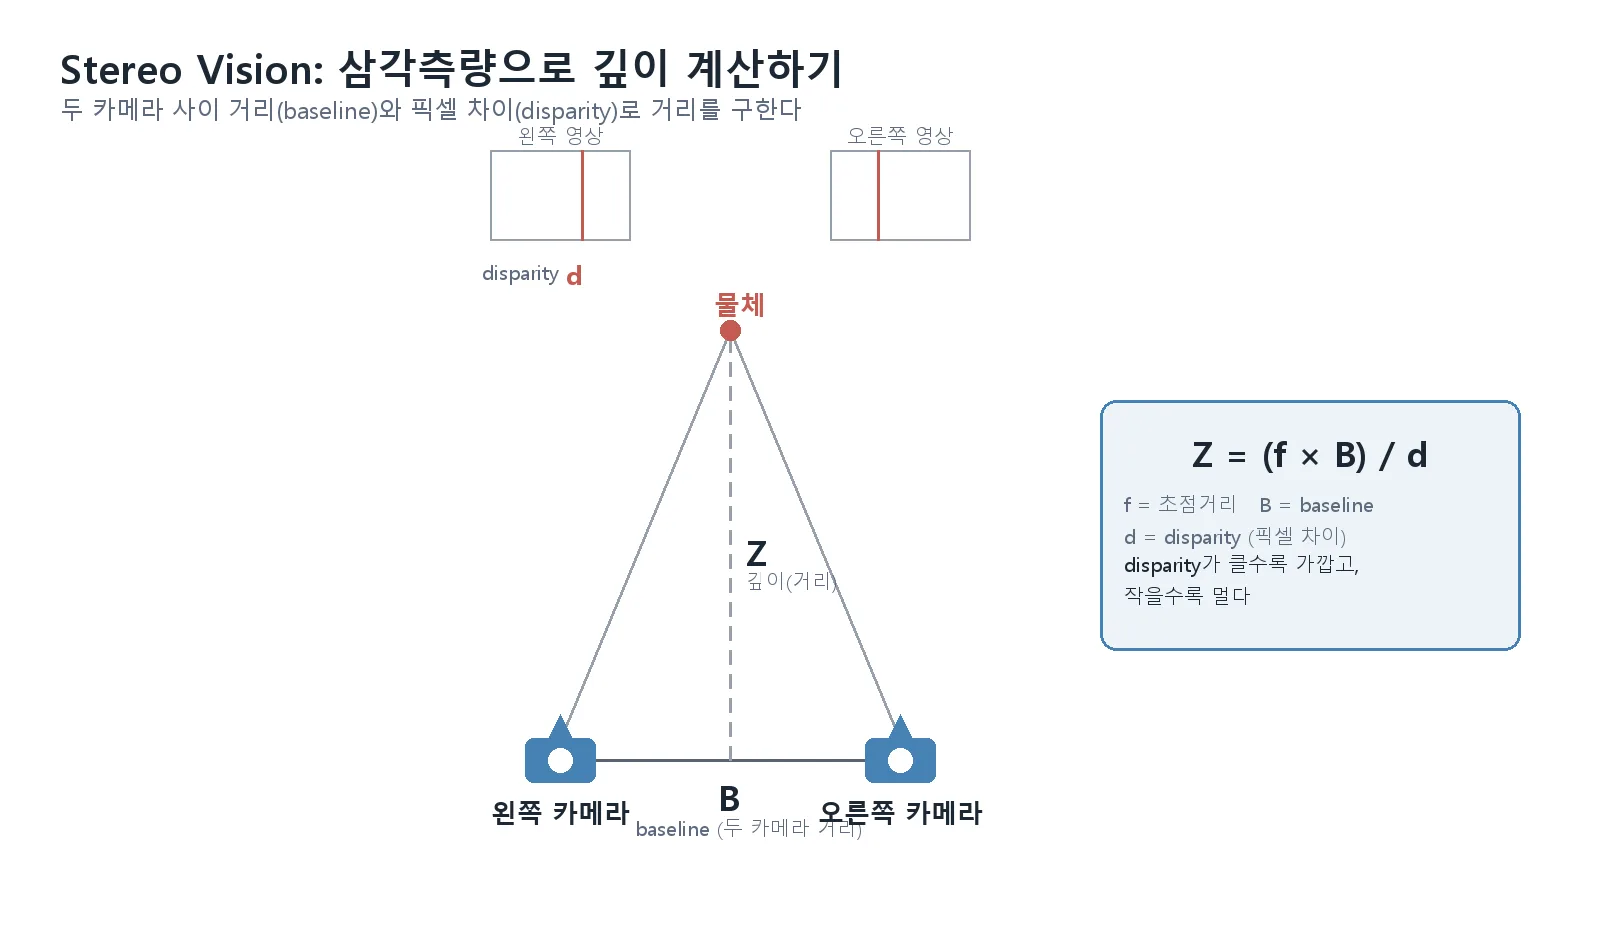
두 대의 카메라 영상만으로 물체까지의 거리를 계산하는 Stereo Vision의 삼각측량 원리와 기본 구현 흐름을 정리한다.
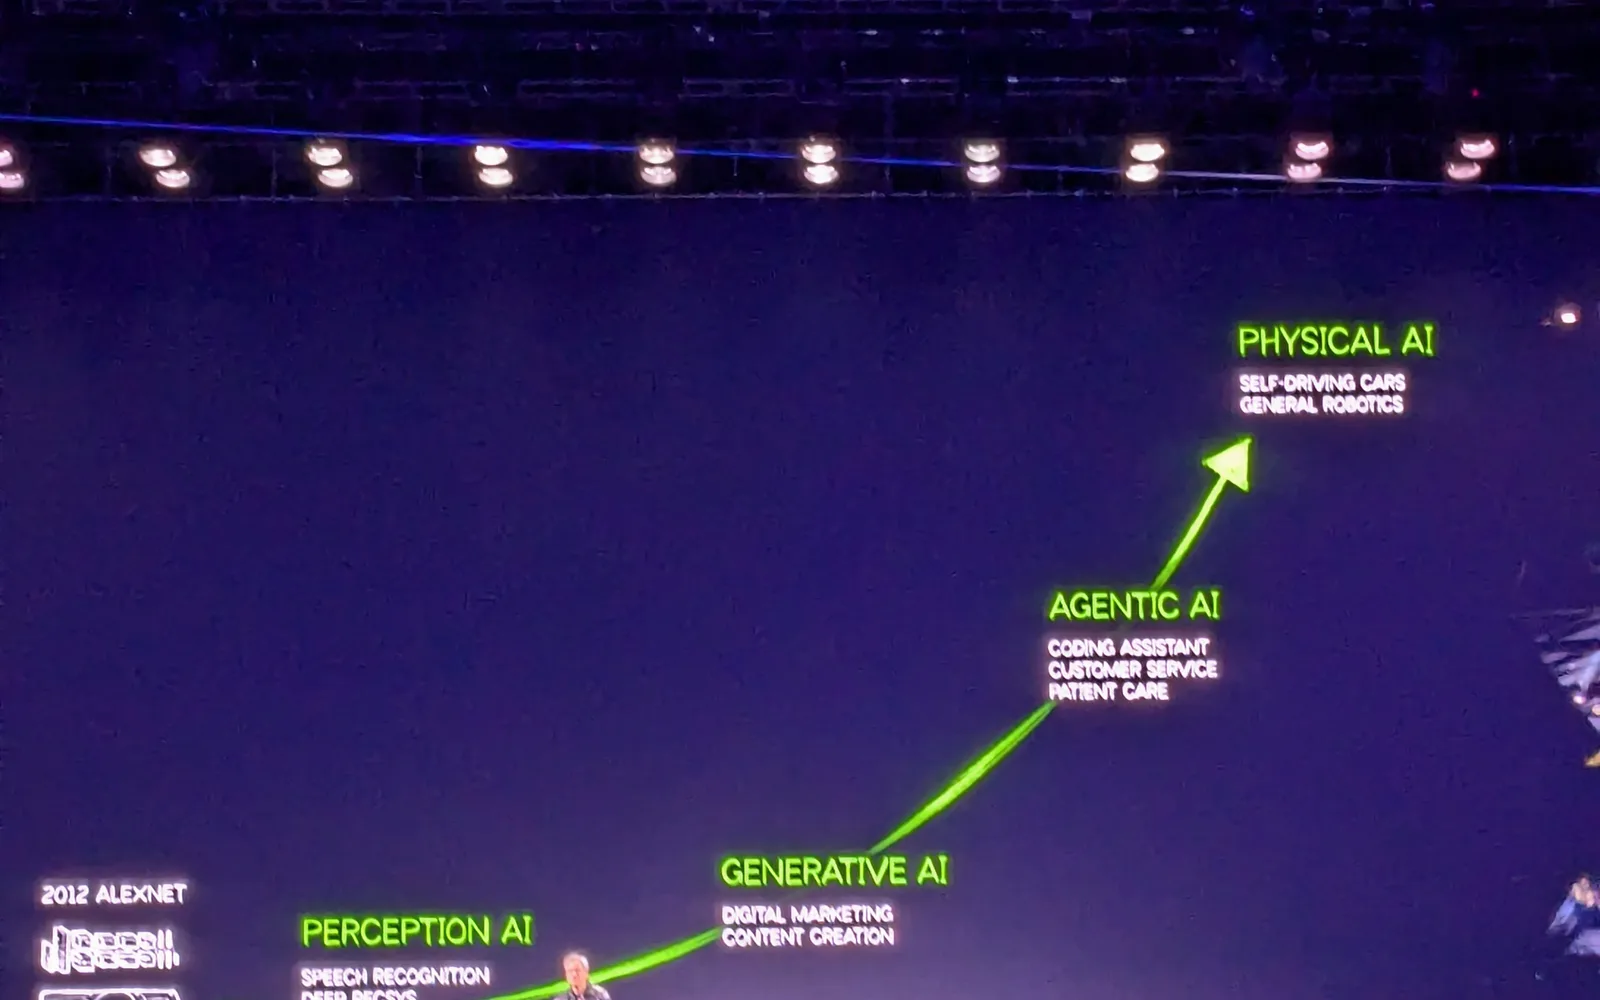
Physical AI가 기존 생성형 AI와 어떻게 다른지, 로봇·자율주행 등에서 어떻게 활용되는지 핵심 개념을 정리한다.