Depth Anything란? 사진 한 장으로 깊이를 추정하는 모델
카메라 한 대로 찍은 이미지 한 장만으로 픽셀별 상대적 거리(깊이)를 예측하는 모노큘러 뎁스 추정 모델 Depth Anything의 원리와 구조를 정리한다.
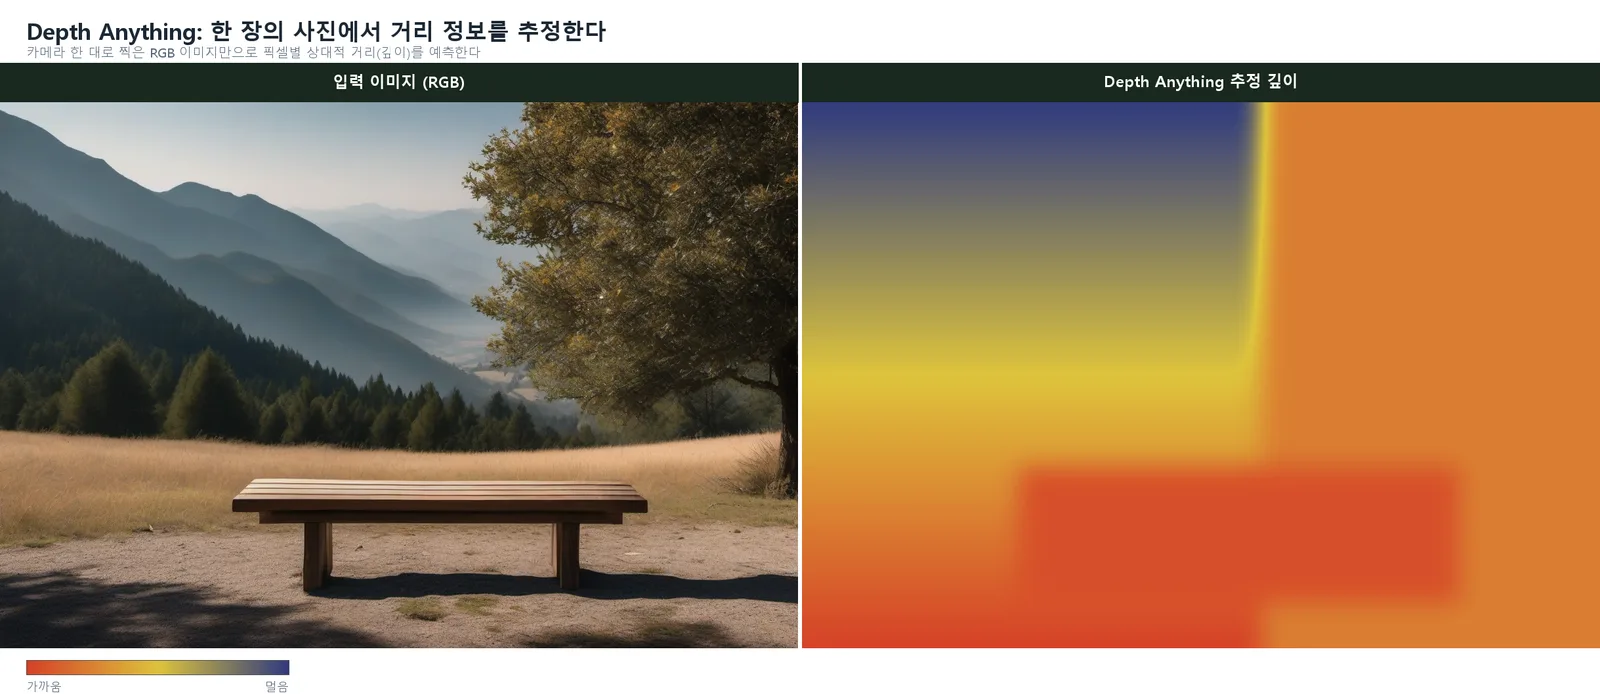
Depth Anything(뎁스 애니씽)는 카메라 한 대로 찍은 이미지 한 장만으로 픽셀별 상대적 거리(깊이)를 추정하는 모노큘러 뎁스 추정(Monocular Depth Estimation) 모델이다. Stereo Vision이 두 대의 카메라 영상 차이(disparity)를 삼각측량해 깊이를 계산하는 것과 달리, Depth Anything은 카메라 한 대·이미지 한 장만 있어도 “이 픽셀이 저 픽셀보다 가깝다/멀다”는 상대적 깊이를 예측한다.
어떻게 한 장의 사진만으로 깊이를 알아내나
Depth Anything(V2)은 교사-학생(teacher-student) 방식으로 학습된다.
- 먼저 DINOv2-Giant 기반의 대형 교사(teacher) 모델을 정답이 있는 합성(synthetic) 이미지 약 59만 5천 장으로만 학습시킨다.
- 이 교사 모델이 실제 사진 6,200만 장 이상에 깊이 의사 정답(pseudo-label)을 매긴다.
- 이렇게 자동으로 라벨링된 대량의 실사진 데이터로 최종 학생(student) 모델들을 학습시킨다.
이 방식 덕분에 사람이 일일이 깊이 값을 측정해 라벨을 붙인 실사진 데이터셋 없이도, 실제 사진에 강건한 모델을 만들 수 있다. 모델 구조 자체는 비전 트랜스포머 계열인 DINOv2를 기반으로, 디코딩 방식을 일부 개선한 형태다.
모델 크기와 라이선스
| 모델 | 파라미터 수 | 라이선스 |
|---|---|---|
| Small | 약 2,480만 | Apache-2.0 |
| Base | 약 9,750만 | CC-BY-NC-4.0 |
| Large | 약 3억 3,530만 | CC-BY-NC-4.0 |
| Giant | 약 13억 | CC-BY-NC-4.0 |
가장 작은 Small 모델만 상업적 이용이 자유로운 Apache-2.0으로 공개되어 있고, 나머지는 비상업적 이용(CC-BY-NC-4.0)으로 제한된다.
기존 방식과 무엇이 다른가
Depth Anything 이전에도 Stable Diffusion 기반으로 깊이를 추정하는 Marigold, GeoWizard 같은 모델이 있었다. Depth Anything(V2)은 이런 확산 모델(diffusion model) 기반 방식보다 10배 이상 빠른 추론 속도를 내면서도 더 세밀한 깊이 경계를 표현하고, 더 적은 파라미터로 더 높은 정확도를 낸다고 공식 프로젝트 페이지에서 밝히고 있다.
어디에 쓰이나
- 3D 재구성: 사진·영상만으로 대략적인 3차원 구조를 복원
- 증강현실(AR): 실제 공간의 깊이를 알아야 가상 물체를 자연스럽게 배치 가능
- 로보틱스·Physical AI: 별도 깊이 센서 없이 카메라 영상만으로 장애물과의 거리 파악
- 사진 편집: 피사체와 배경 거리를 구분해 배경 흐림(아웃포커싱) 효과 적용
한계와 주의할 점
- Depth Anything이 추정하는 깊이는 상대적 깊이로, 별도 보정 없이는 “정확히 몇 미터”인지 알려주는 절대적 거리값이 아니다(단, 실내·실외용 메트릭 깊이 변형 모델도 별도로 제공된다).
- Stereo Vision처럼 실제 카메라 기하학에 기반한 계산이 아니라 학습 데이터로부터 추정한 값이므로, 학습 데이터와 크게 다른 장면에서는 오차가 커질 수 있다.
- Base 이상 모델은 비상업적 라이선스(CC-BY-NC-4.0)이므로 상업적 서비스에 적용하려면 라이선스 조건을 반드시 확인해야 한다.
결론
Depth Anything은 교사-학생 방식의 대규모 의사 라벨링을 통해, 카메라 한 대의 사진 한 장만으로도 실용적인 수준의 깊이 추정을 가능하게 한 모델이다. 두 대의 카메라가 필요한 Stereo Vision과 달리 하드웨어 제약이 적어, AR·로보틱스·사진 편집 등 폭넓은 분야에 적용되고 있다.