AI
Vector Database란? 일반 데이터베이스와 다른 점
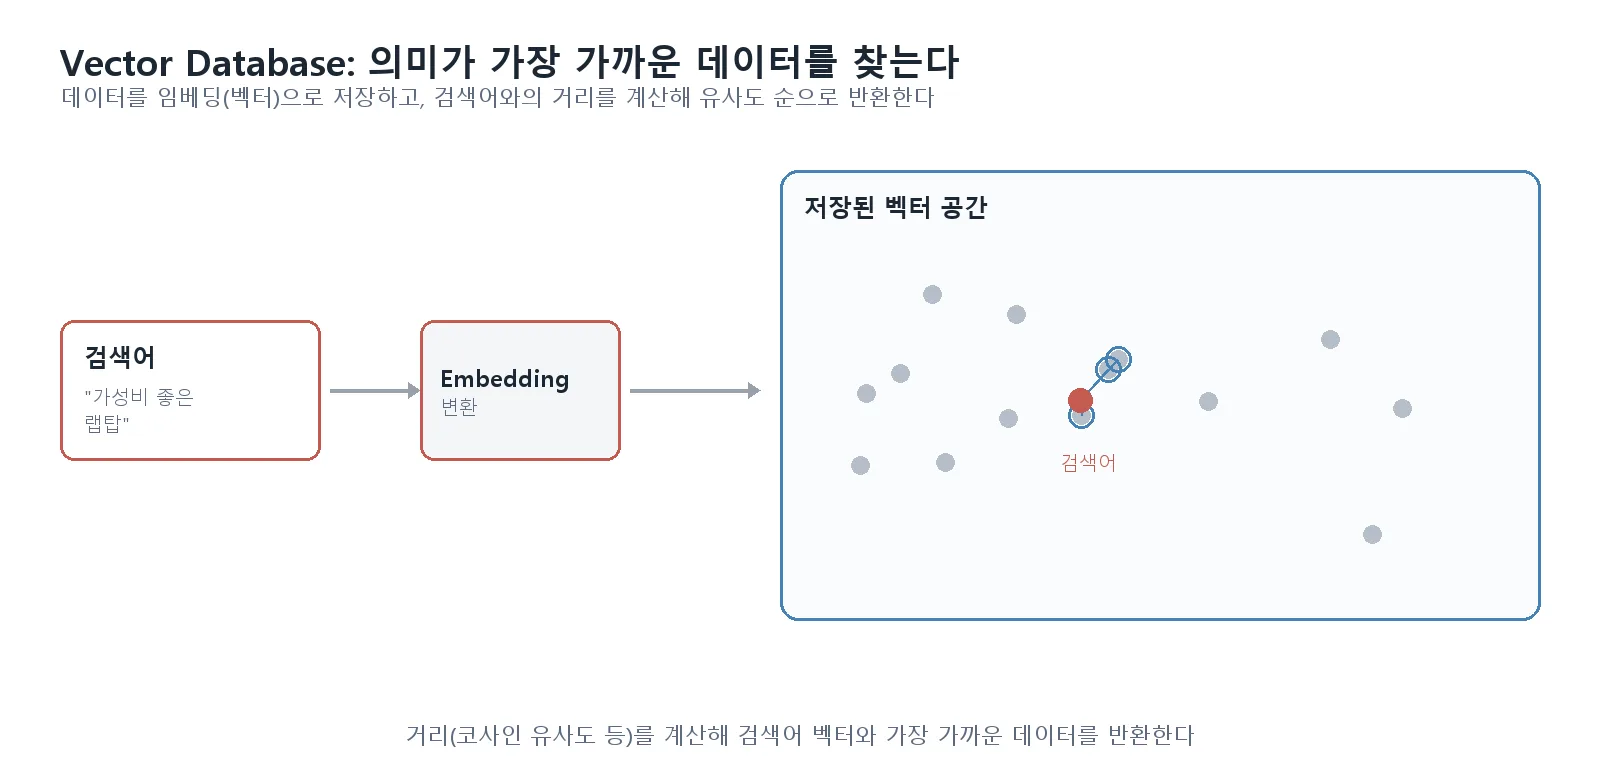
의미 기반으로 데이터를 검색하는 Vector Database가 일반 데이터베이스와 무엇이 다른지, Embedding·유사도 검색 원리를 중심으로 정리한다.
LLM, AI Agent, RAG, AI Automation 등 생성형 AI의 원리와 실무 활용을 다룹니다.
AI와 Computer Vision을 다루는 기술 지식 허브
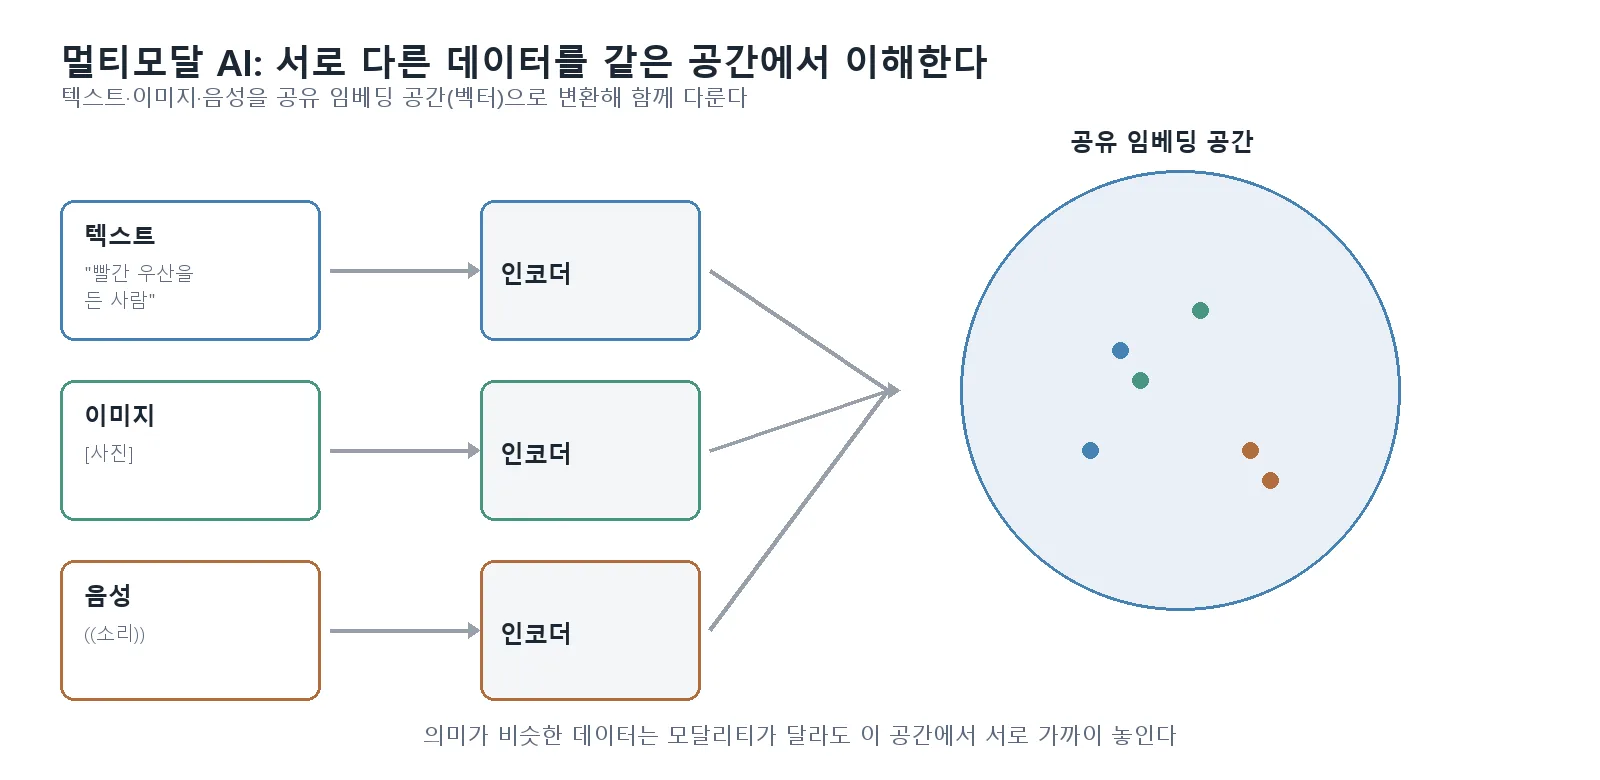
하나의 모델이 텍스트·이미지·음성·영상을 동시에 이해하고 넘나들며 다루는 멀티모달 AI의 원리와, 이를 지탱하는 공유 임베딩 공간의 개념을 정리한다.
의미 기반으로 데이터를 검색하는 Vector Database가 일반 데이터베이스와 무엇이 다른지, Embedding·유사도 검색 원리를 중심으로 정리한다.
GPU 가격 폭등 속에서 대안으로 떠오른 GPU 대여(Cloud GPU) 서비스가 어떤 유형으로 나뉘고, 어떤 기술로 동작하며, 실제로 어떻게 활용할 수 있는지 정리한다.
Black Forest Labs가 공개한 FLUX.2가 캐릭터·스타일 일관성과 텍스트 렌더링에서 어떤 개선을 이뤘는지 정리한다.
Google DeepMind의 Gemini Robotics 2가 휴머노이드 로봇의 전신 동작과 다중 로봇 협업까지 지원하게 된 방식을 정리한다.
Google DeepMind의 World Model Genie 3가 텍스트 프롬프트만으로 실시간 탐험이 가능한 3D 환경을 생성하는 방식과 의미를 정리한다.
AI 음악 생성 서비스 Suno의 v5 모델이 이전 버전 대비 어떤 점이 개선됐는지, 보컬 품질과 v5.5의 개인화 기능을 중심으로 정리한다.
Google DeepMind의 영상 생성 모델 Veo 3.1이 이전 버전 대비 어떤 점이 달라졌는지, 오디오·해상도·일관성 개선을 중심으로 정리한다.
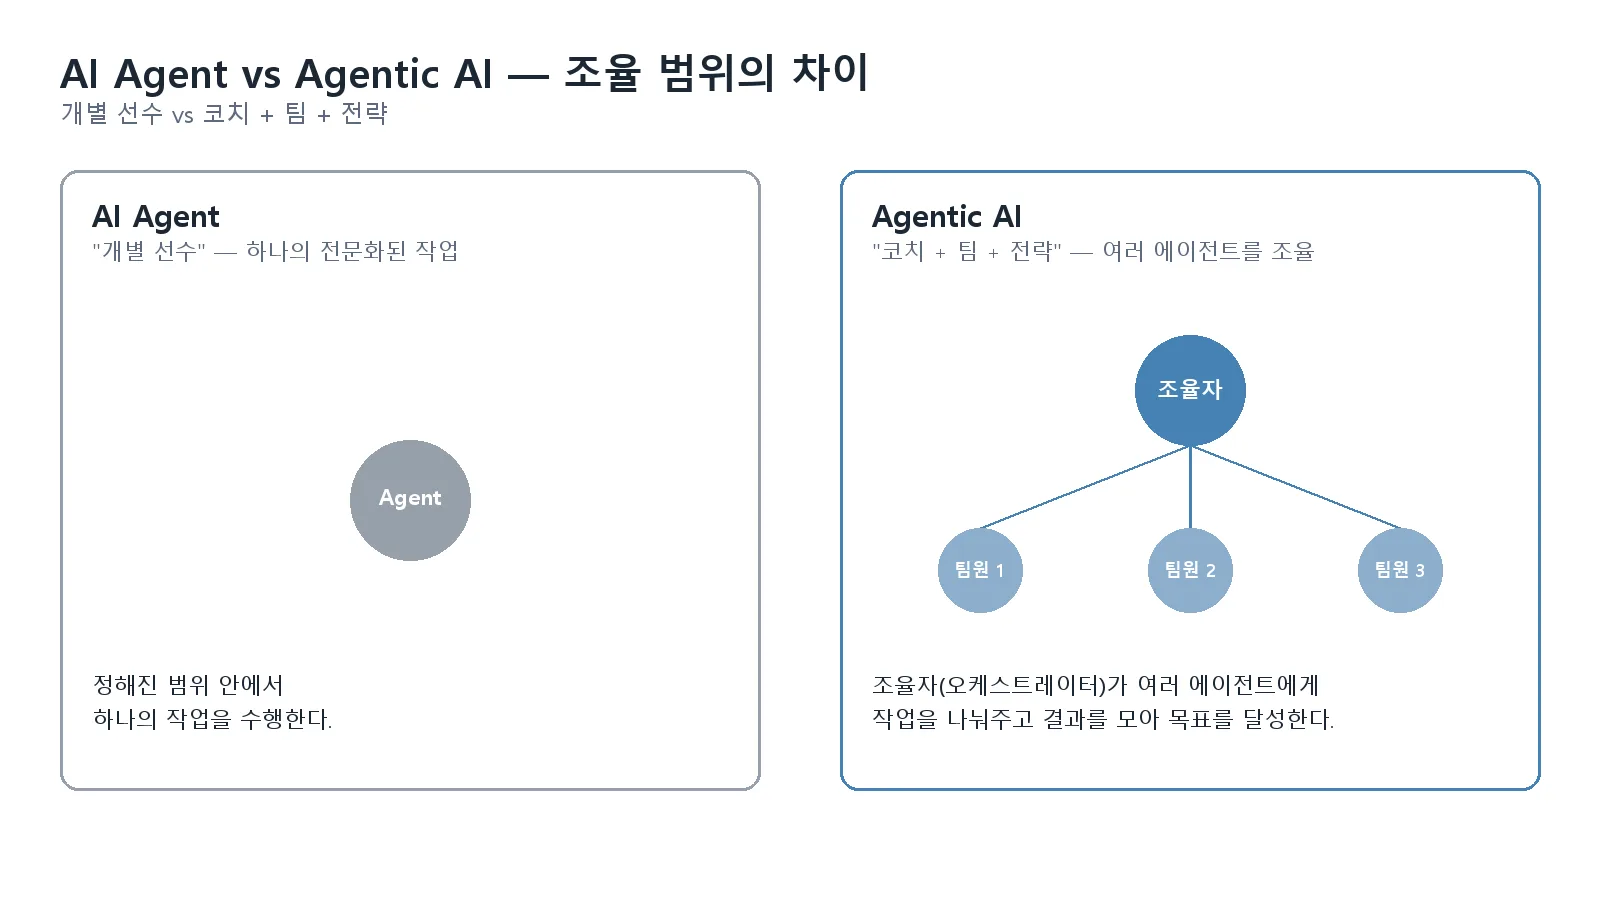
Agentic AI와 AI Agent라는 두 용어가 실제로 어떻게 다르게 쓰이는지, 왜 이 구분이 실무에서 중요한지 정리한다.
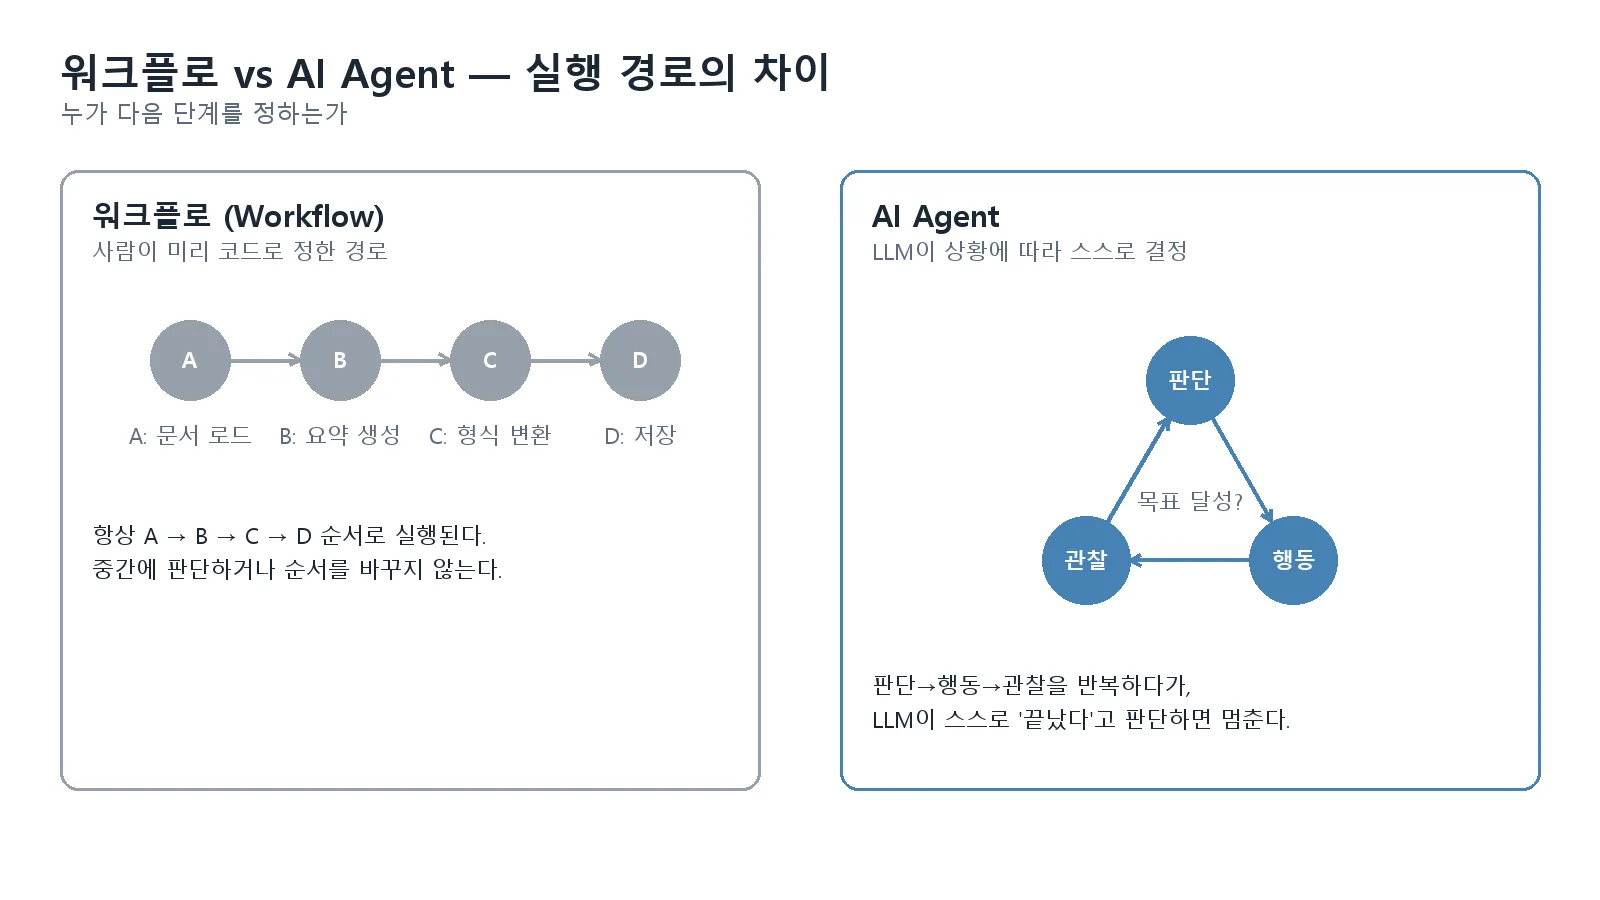
AI Agent가 일반 챗봇·LLM 호출과 무엇이 다른지 Anthropic의 공식 정의를 기준으로 정리하고, 언제 에이전트가 필요한지 설명한다.
LLM을 GPU에서 돌릴 때 VRAM이 병목이 되는 이유와, 파라미터 수·양자화 수준에 따라 VRAM 사용량이 어떻게 달라지는지 정리한다.
Anthropic의 에이전틱 코딩 도구 Claude Code의 개념, 운영체제별 설치 방법, 핵심 기능, 요금제를 공식 문서를 기준으로 정리한다.
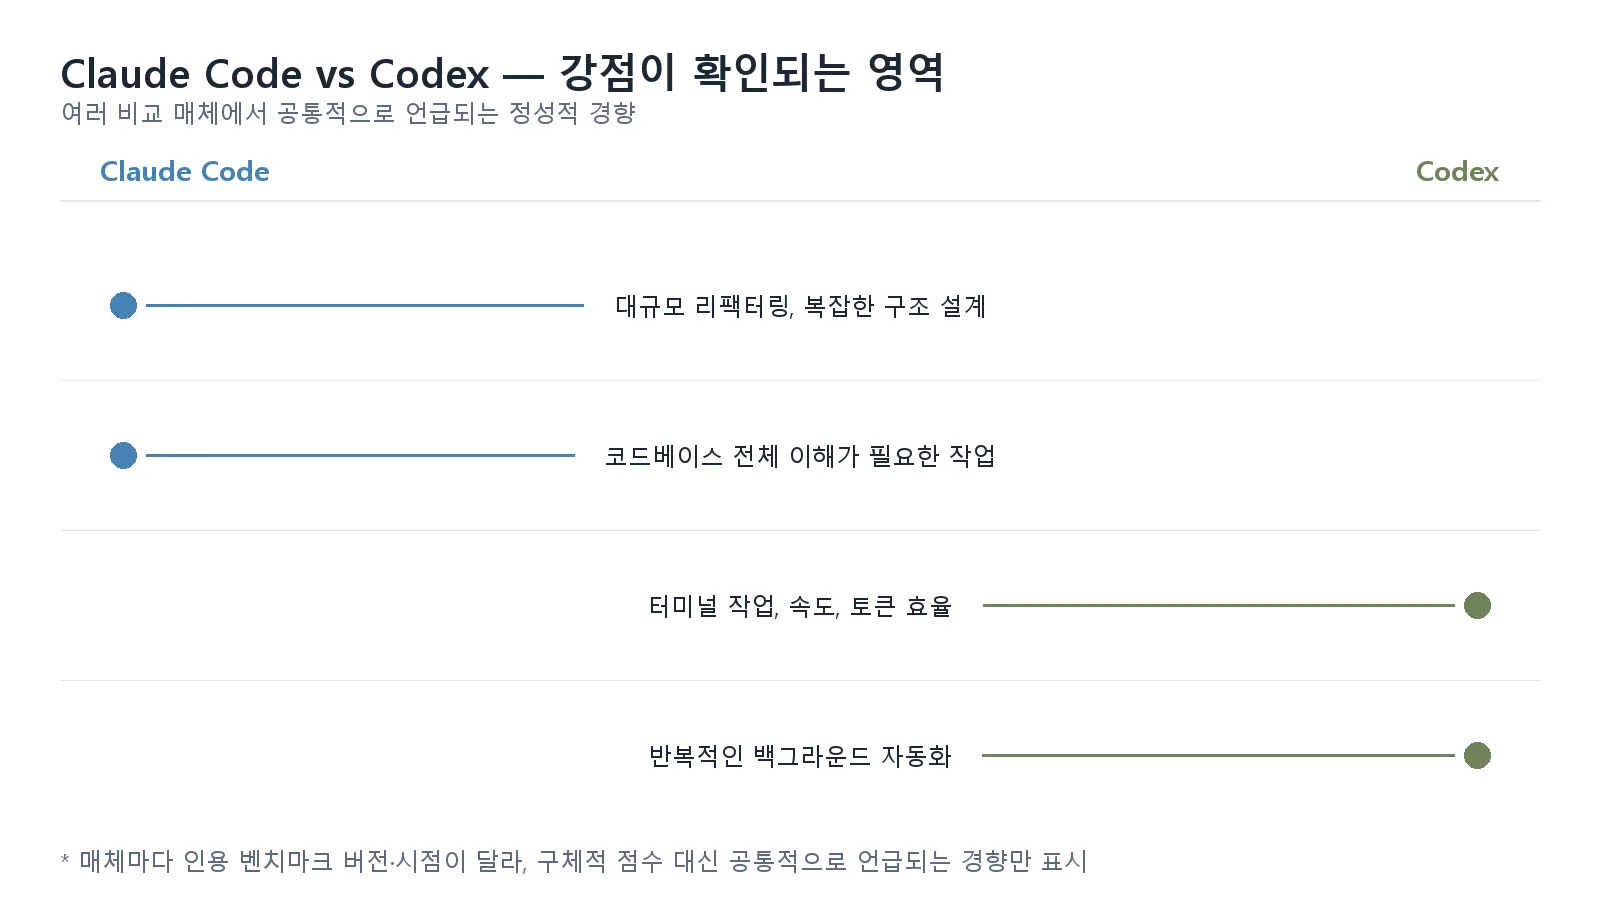
Anthropic의 Claude Code와 OpenAI의 코딩 에이전트 Codex를 모델 기반·요금제·기능·벤치마크 기준으로 비교한다.
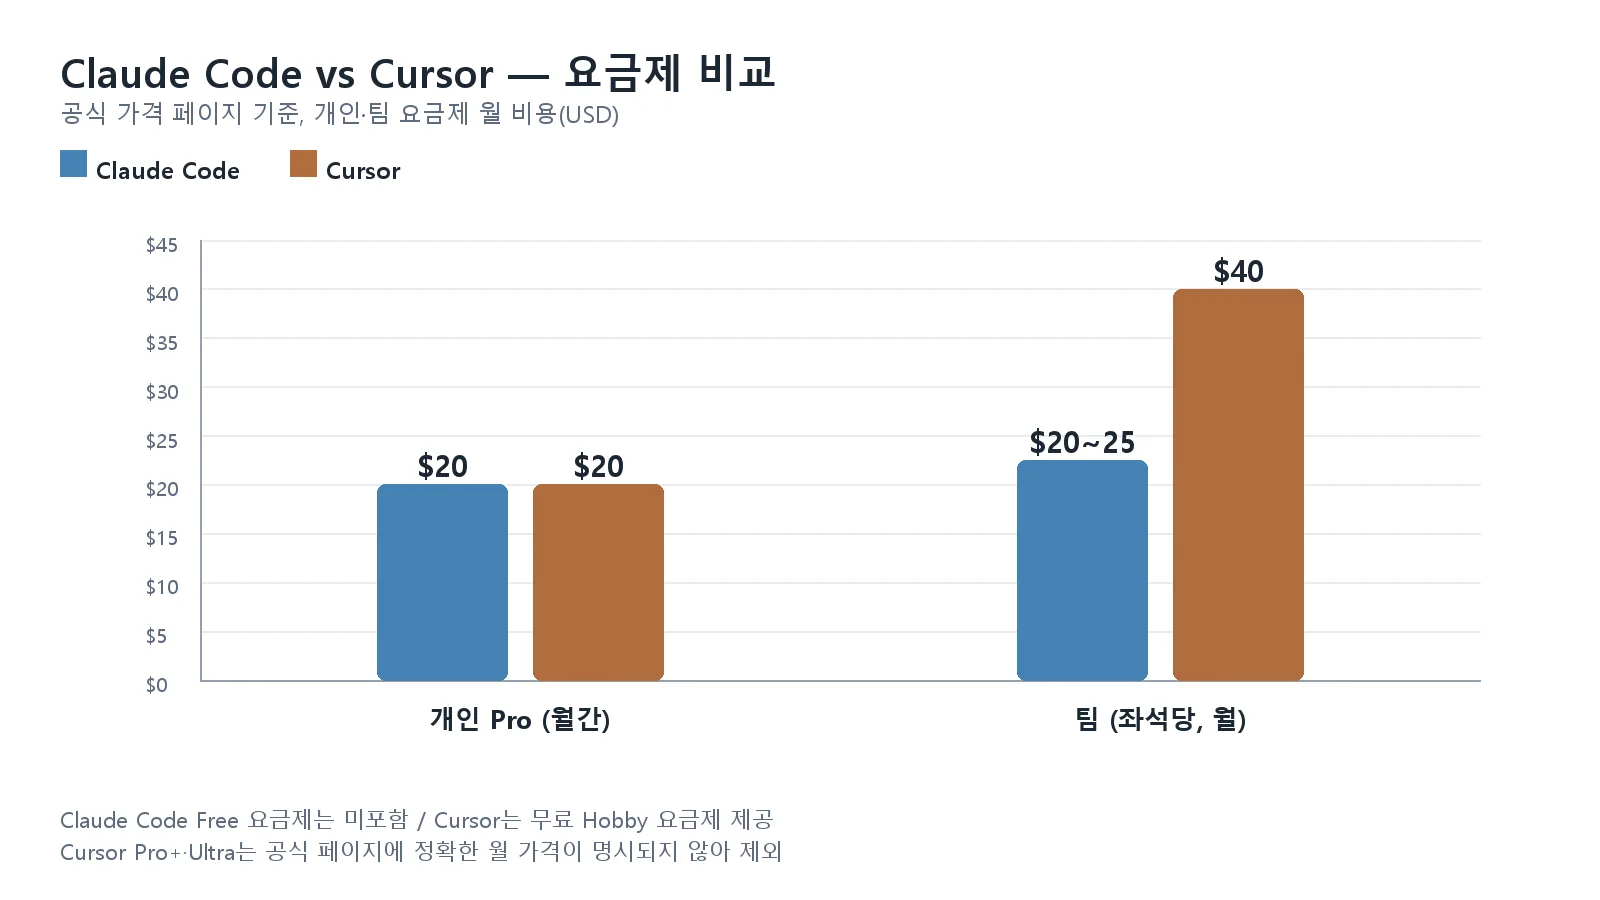
터미널 기반 에이전트 Claude Code와 IDE 기반 자동완성 도구 Cursor를 요금제·작업 방식·적합한 상황 기준으로 비교한다.
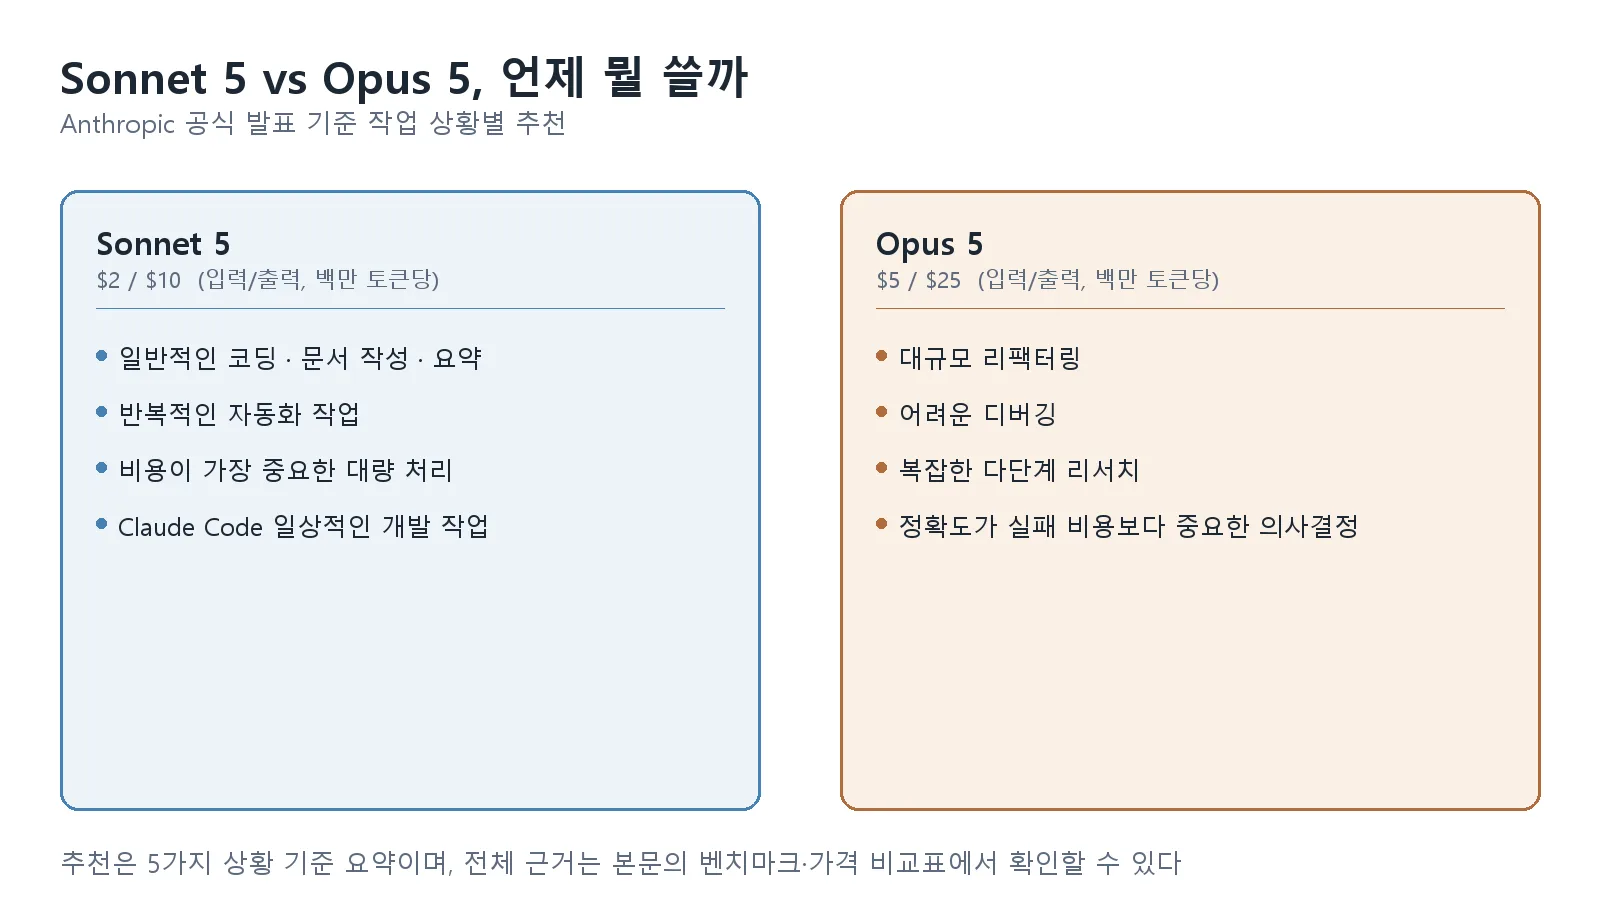
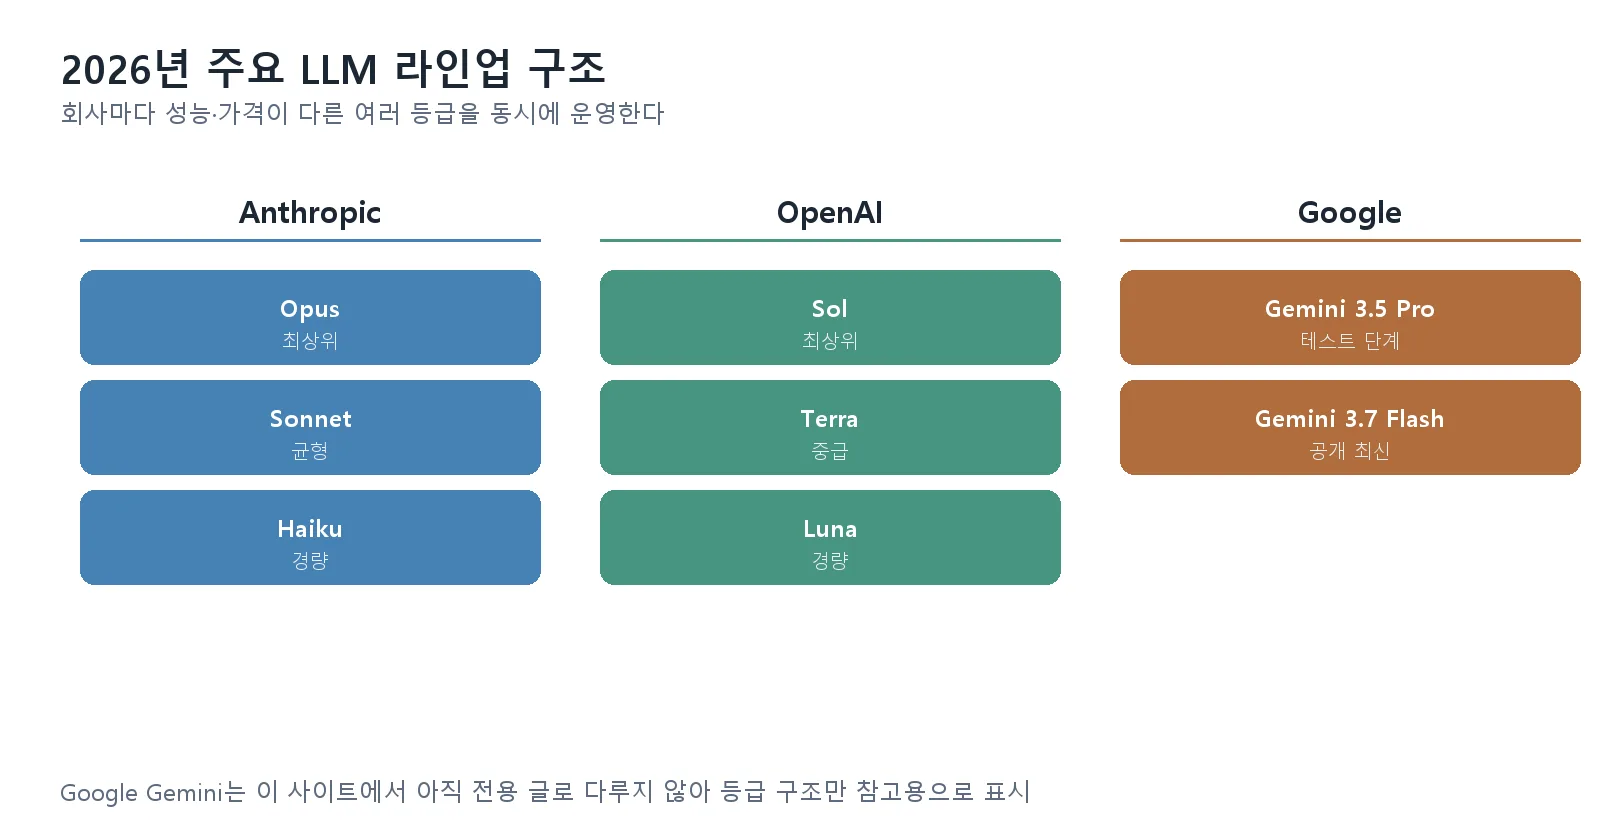
Anthropic의 최상위 모델 Opus 5와 중급 모델 Sonnet 5를 가격·성능·용도 기준으로 비교하고, 어떤 작업에 어떤 모델이 적합한지 정리한다.
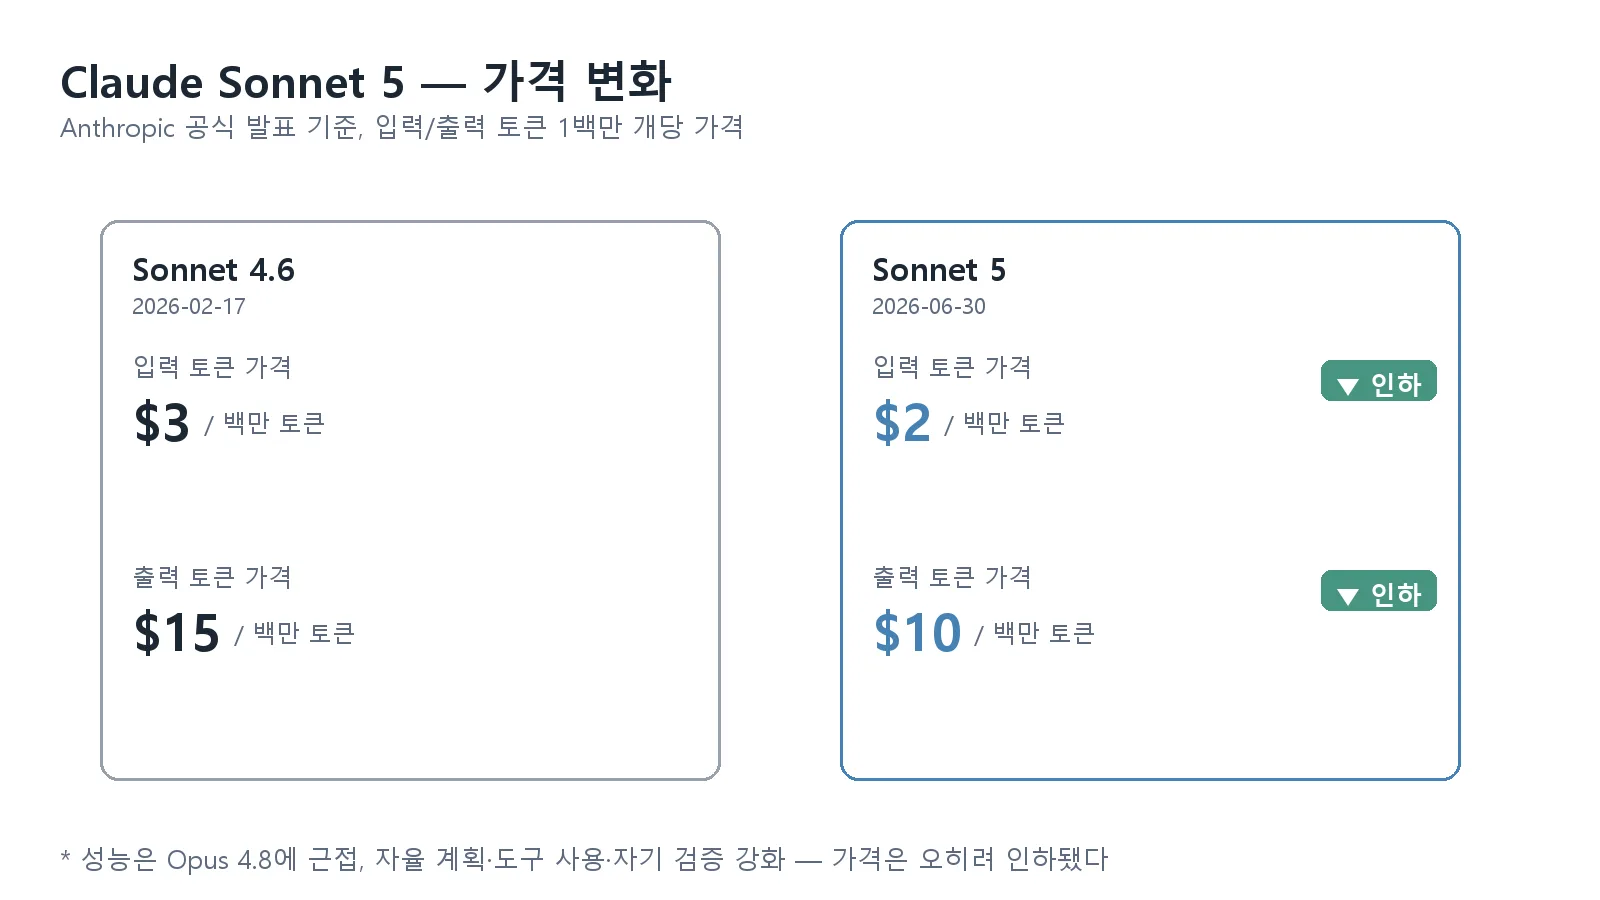
Anthropic이 2026년 6월 출시한 Claude Sonnet 5가 이전 모델 Sonnet 4.6과 가격·성능·기능 면에서 어떻게 다른지 공식 발표를 기준으로 정리한다.
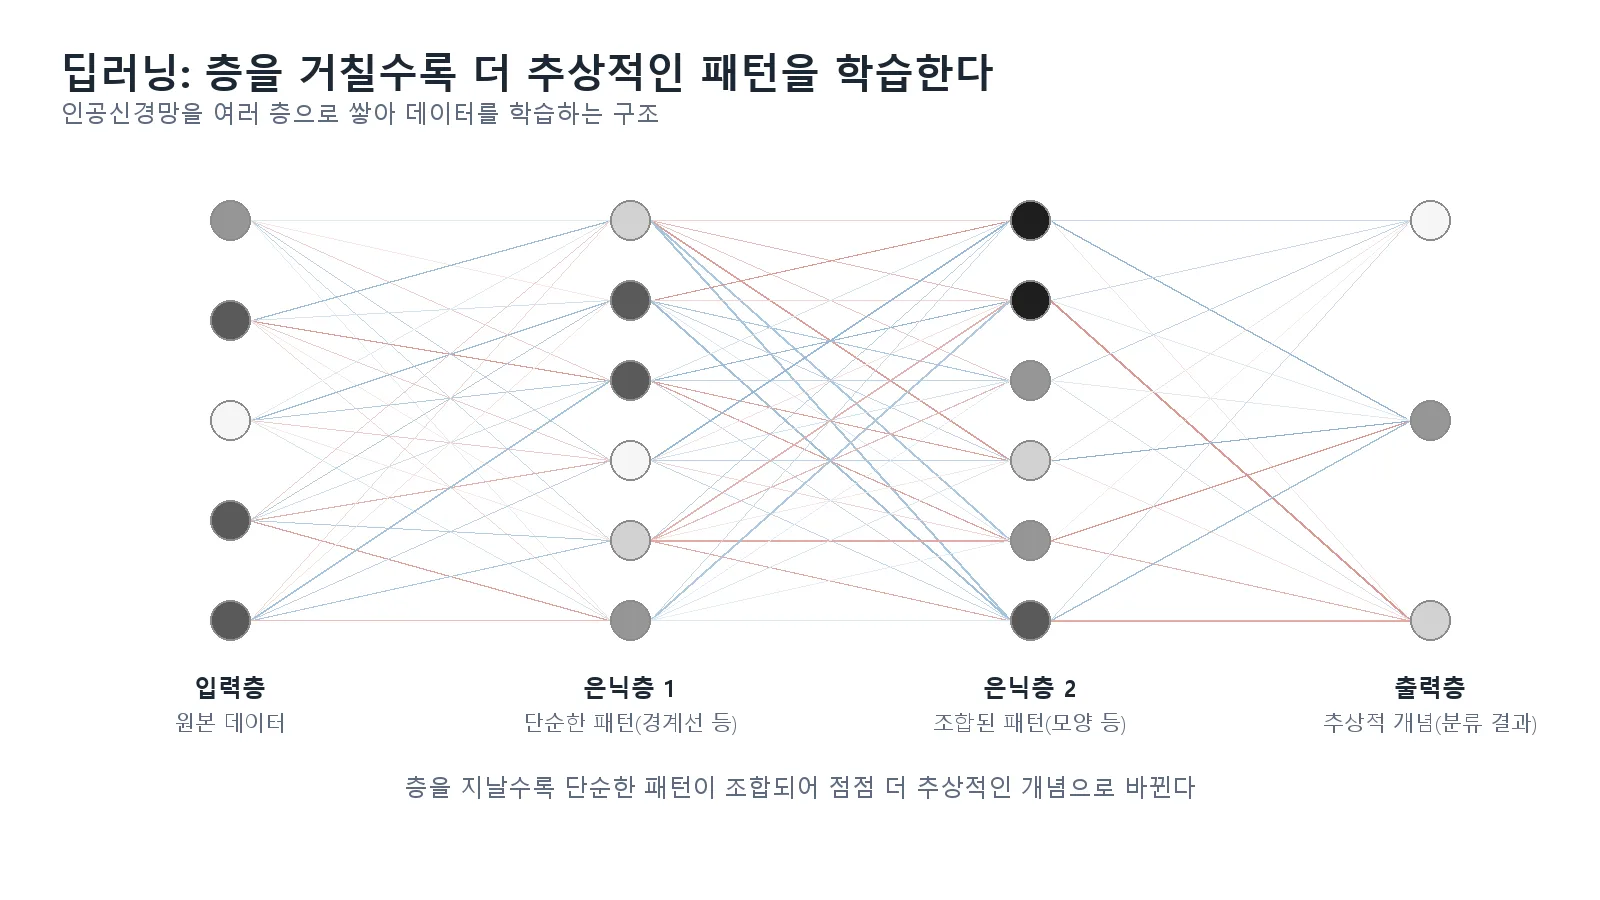
인공신경망을 여러 층으로 쌓아 이미지·텍스트 같은 비정형 데이터를 학습하는 딥러닝의 원리와, 머신러닝과의 실질적 차이를 정리한다.
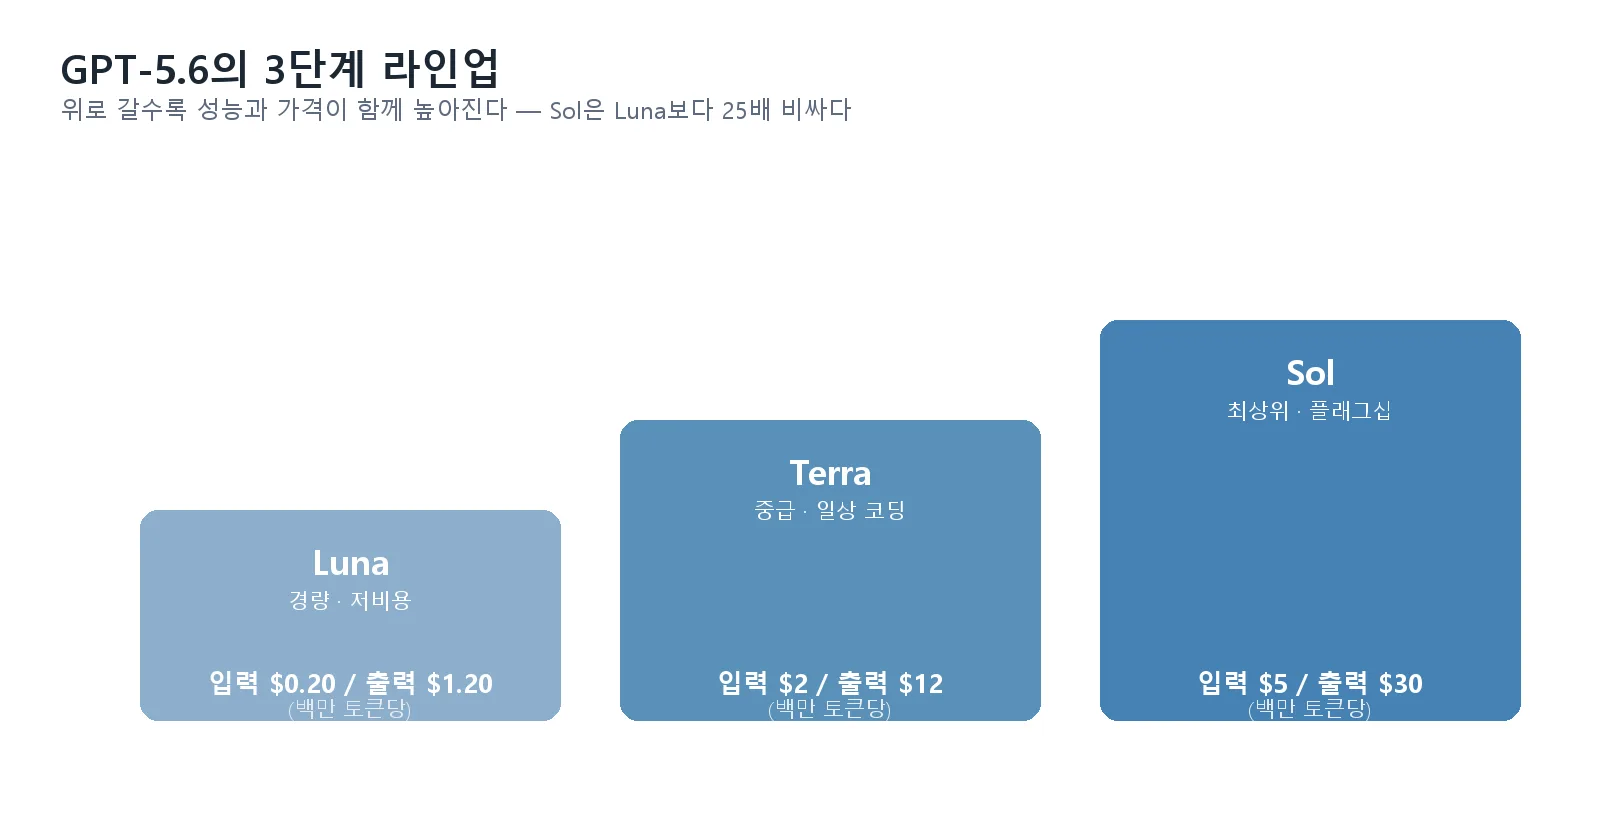
OpenAI가 2026년 7월 공개한 GPT-5.6의 3단계 라인업(Luna·Terra·Sol)과 가격, 핵심 성능 개선 내용을 정리한다.
Anthropic Claude, OpenAI GPT, Google Gemini 등 주요 LLM 계열을 한 곳에 정리하고, 이 사이트에서 다룬 각 모델별 상세 글로 연결한다.
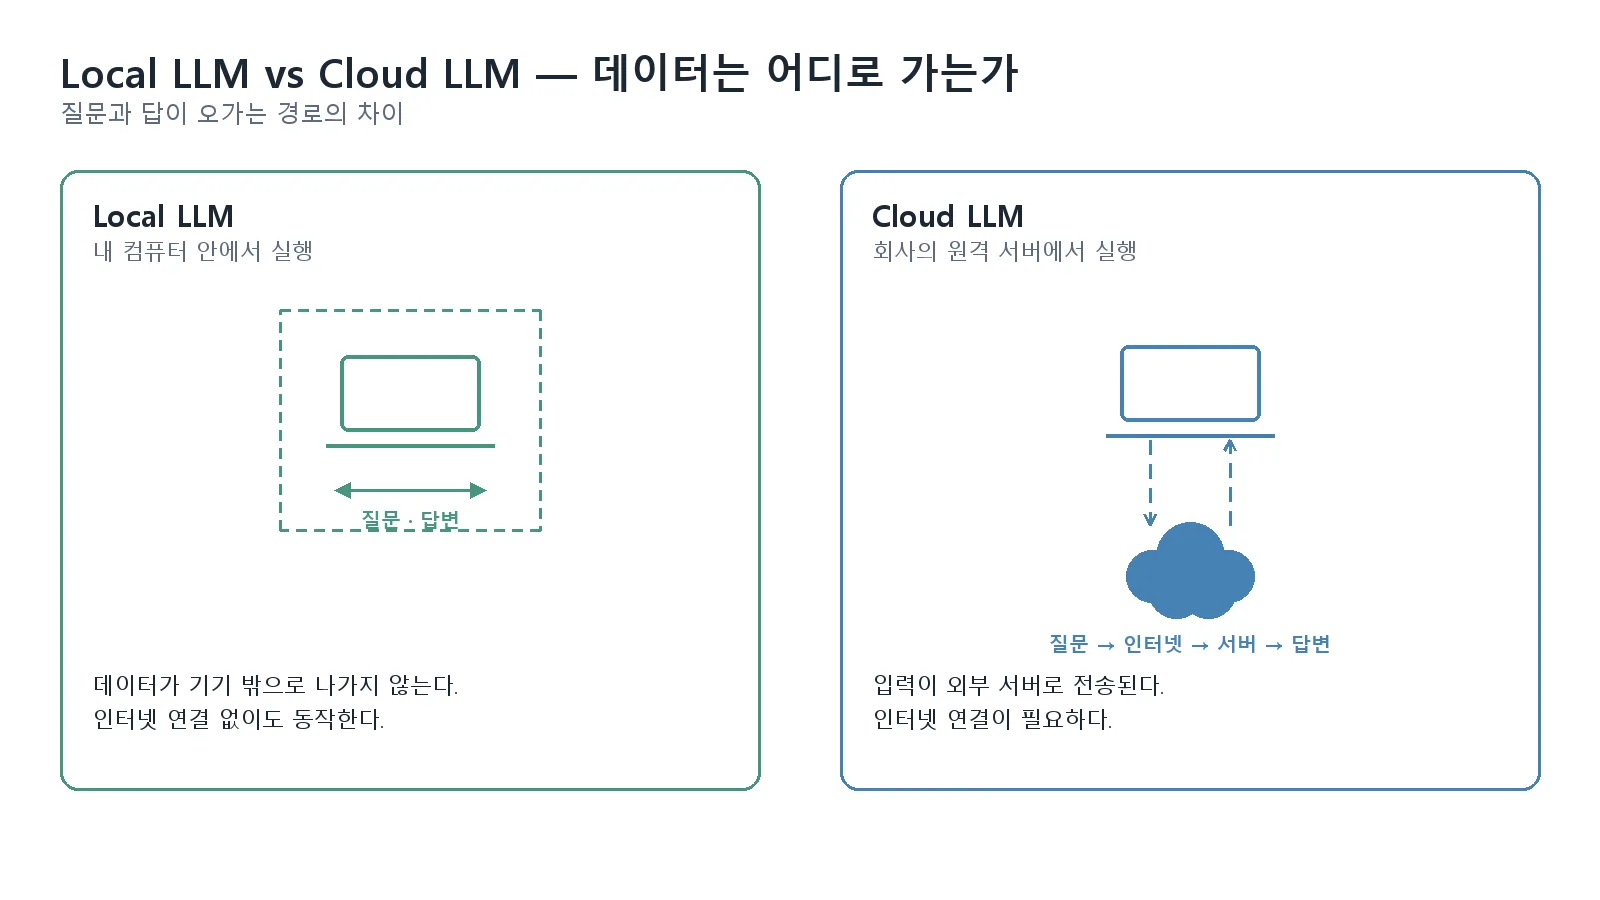
내 컴퓨터에서 직접 실행하는 Local LLM이 ChatGPT·Claude 같은 Cloud LLM과 무엇이 다른지, 언제 유리한지 정리한다.
LM Studio, Ollama로 로컬 LLM을 돌릴 때 모델 크기별로 어느 정도 VRAM의 GPU가 필요한지, 예산별 선택 기준을 정리한다.
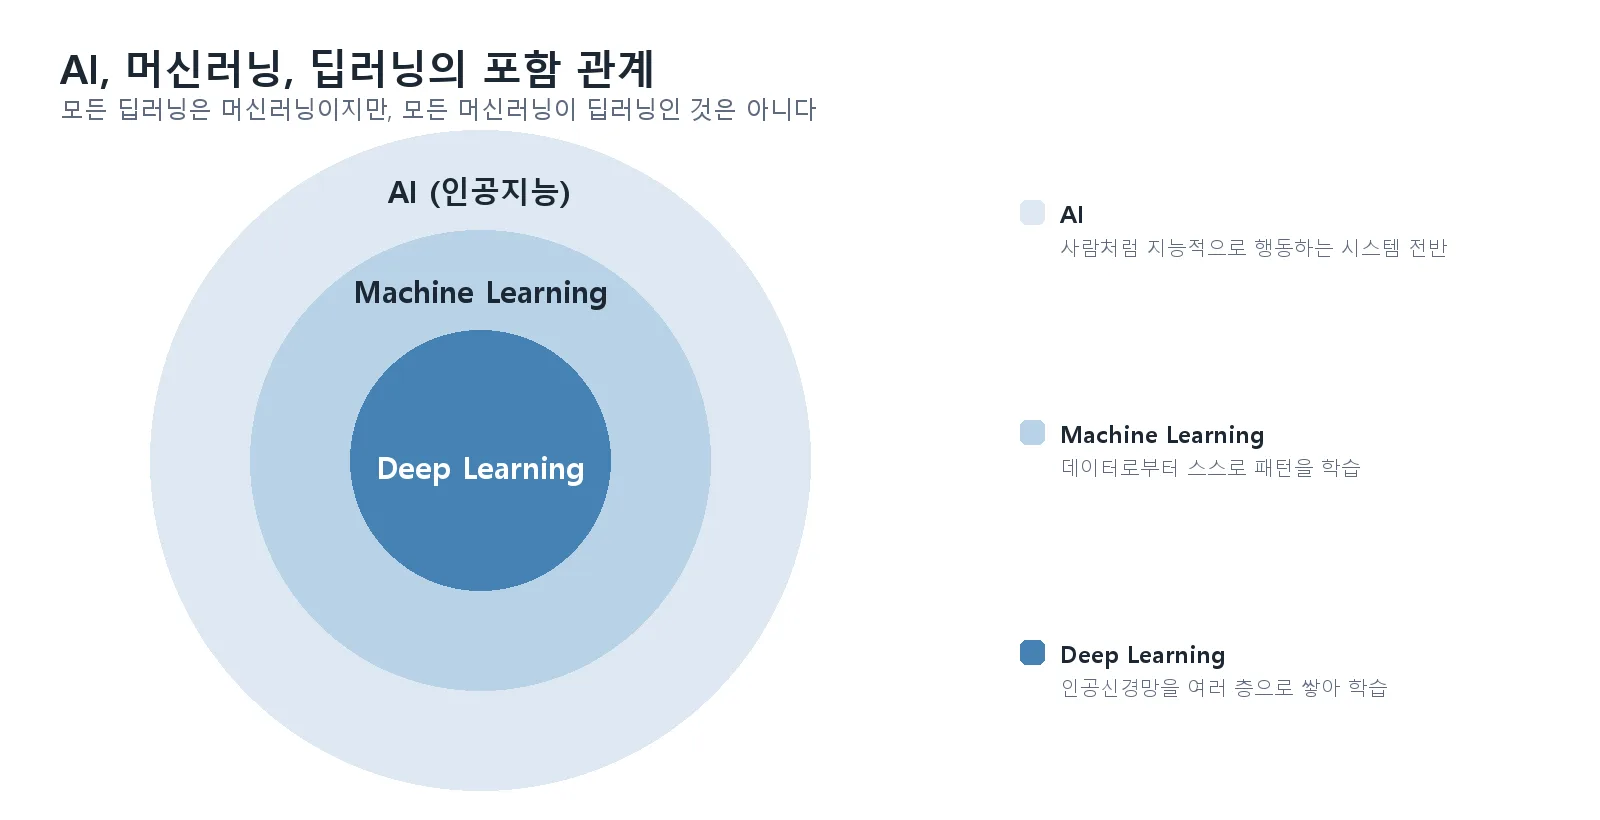
AI, 머신러닝, 딥러닝의 관계를 정리하고, 머신러닝이 데이터를 통해 스스로 규칙을 학습하는 방식을 설명한다.
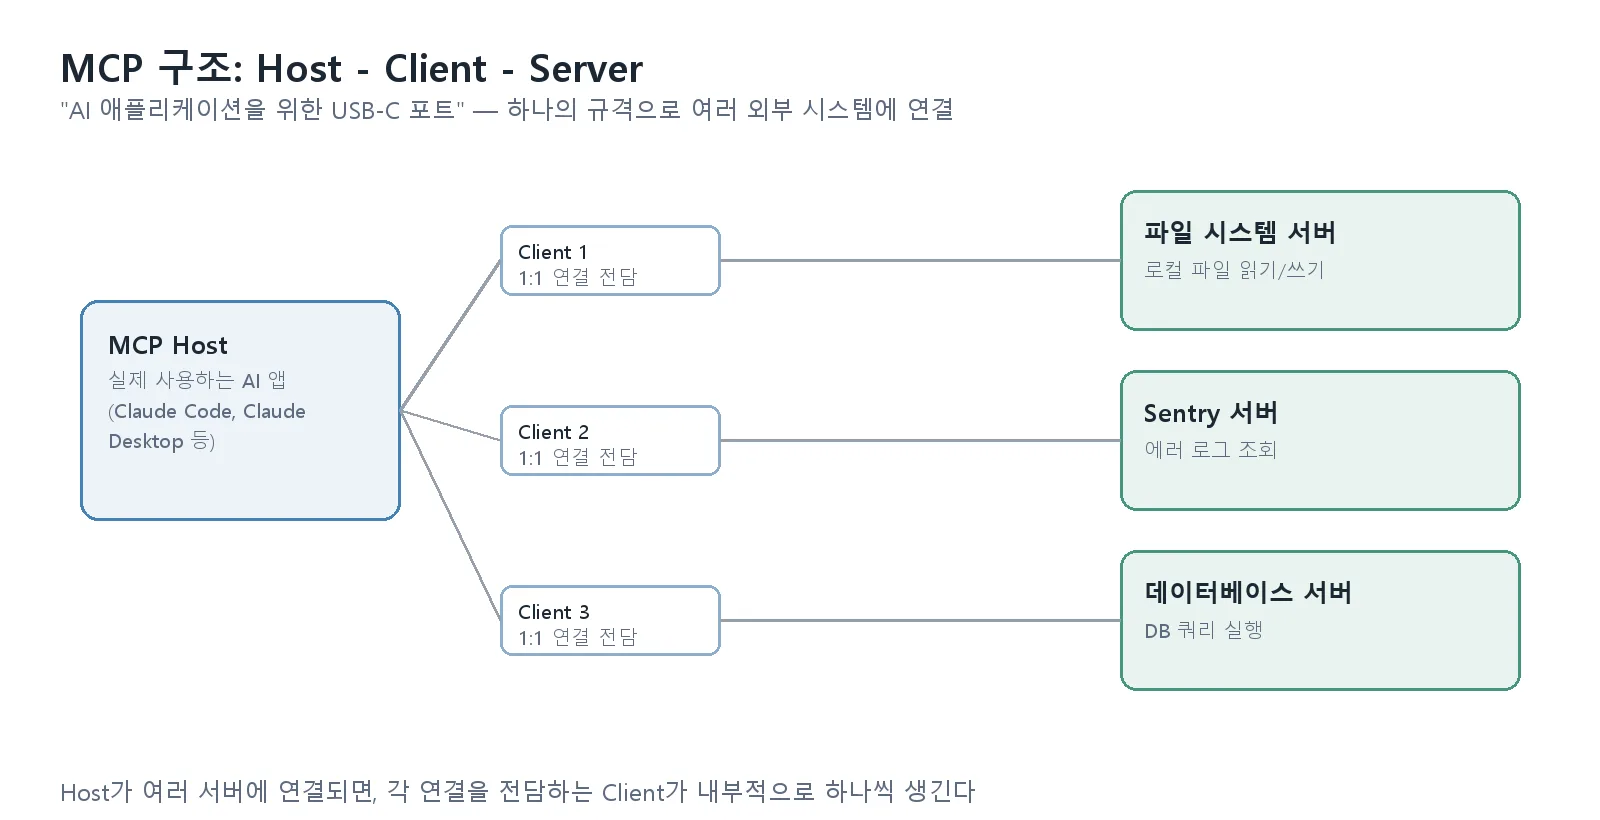
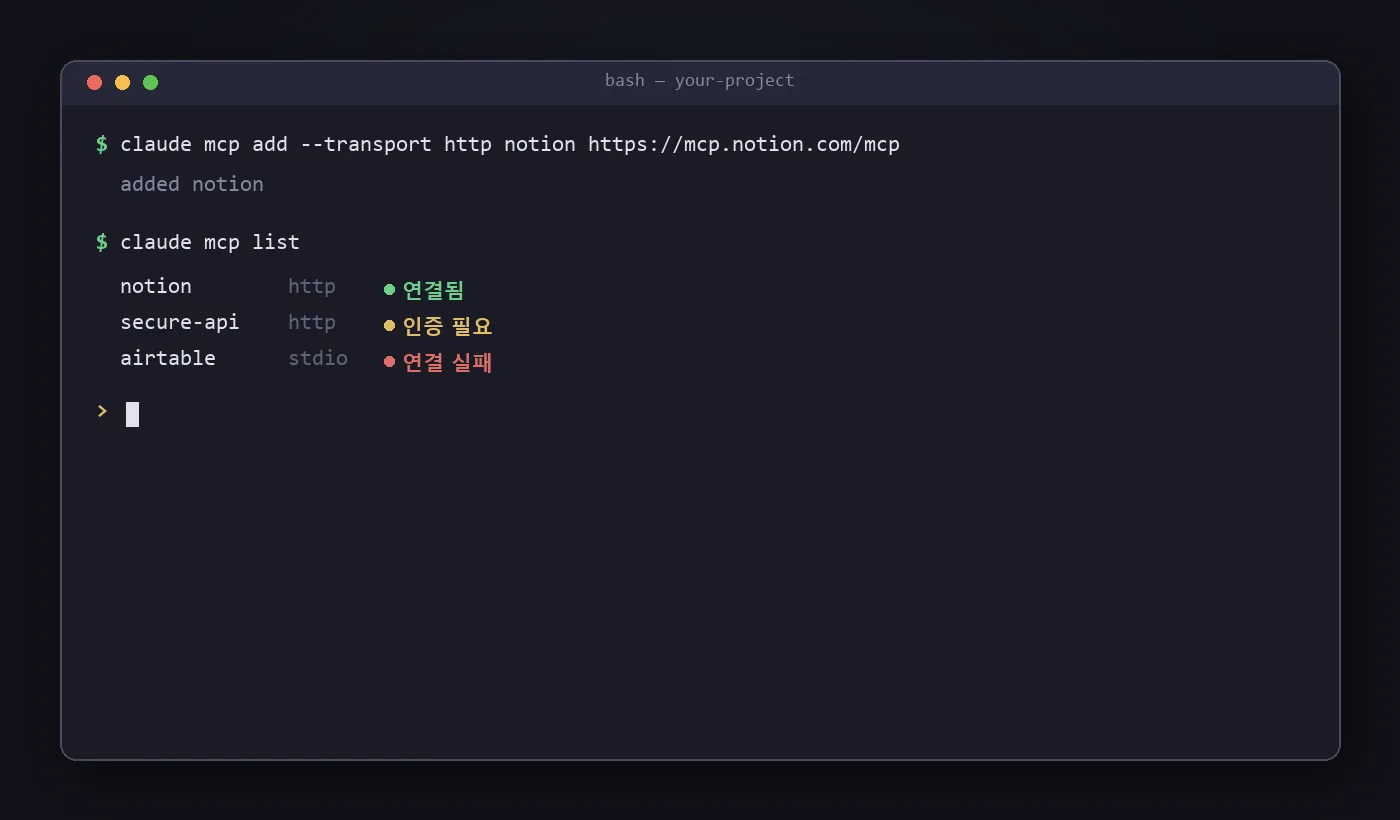
AI 애플리케이션을 외부 도구·데이터와 연결하는 개방형 표준 MCP(Model Context Protocol)의 개념과 구조, 등장 배경을 정리한다.
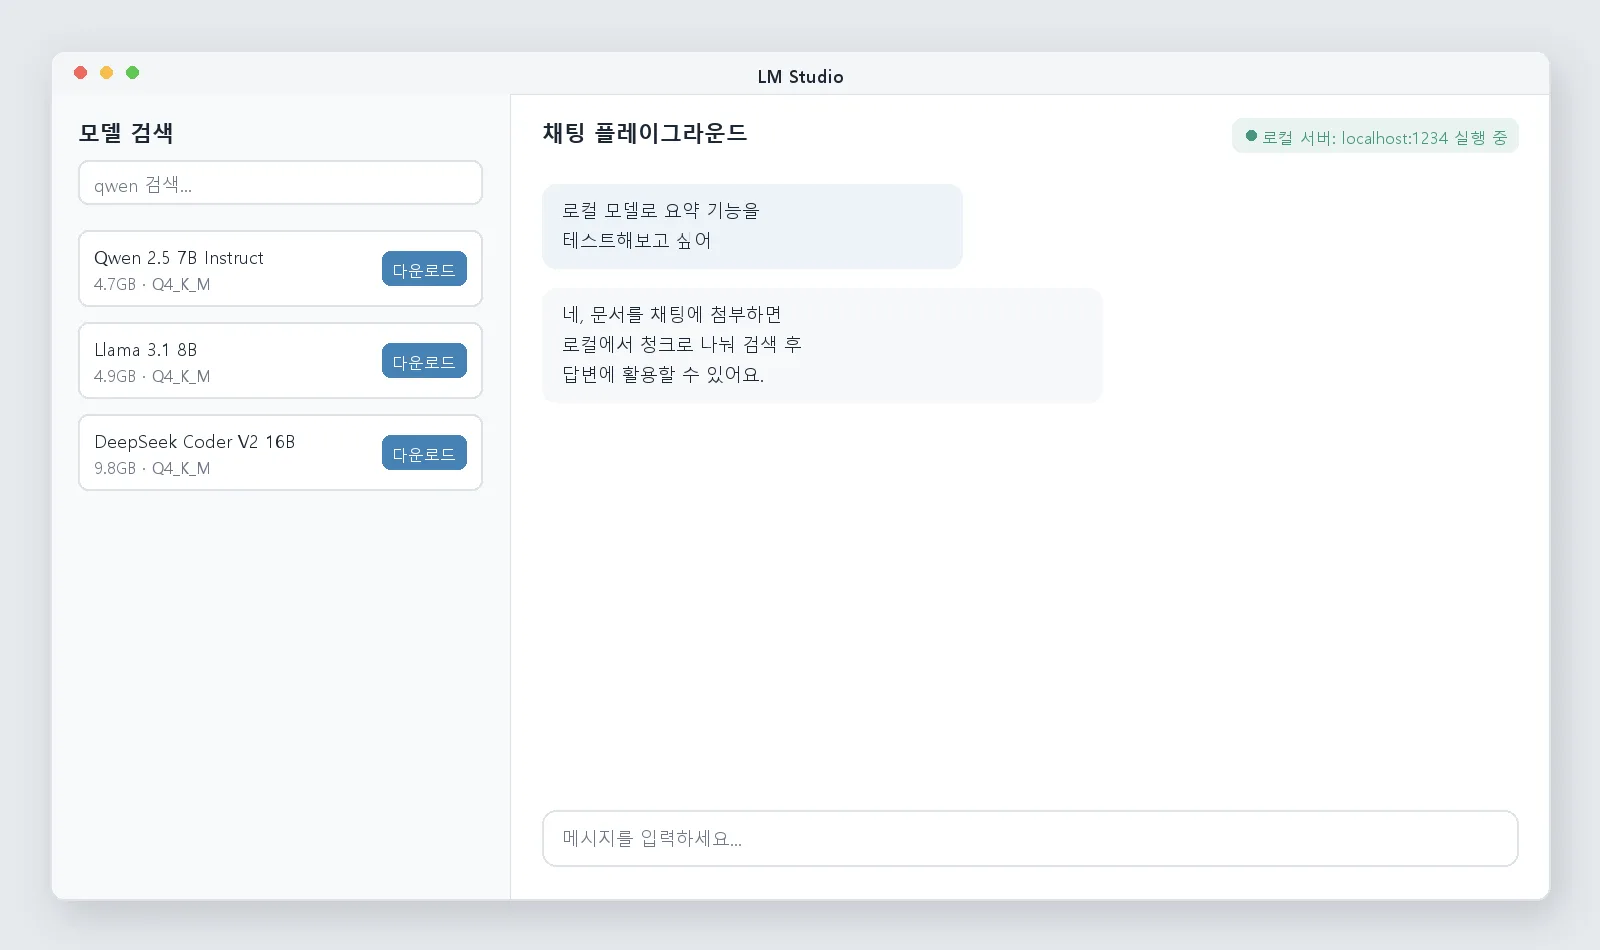
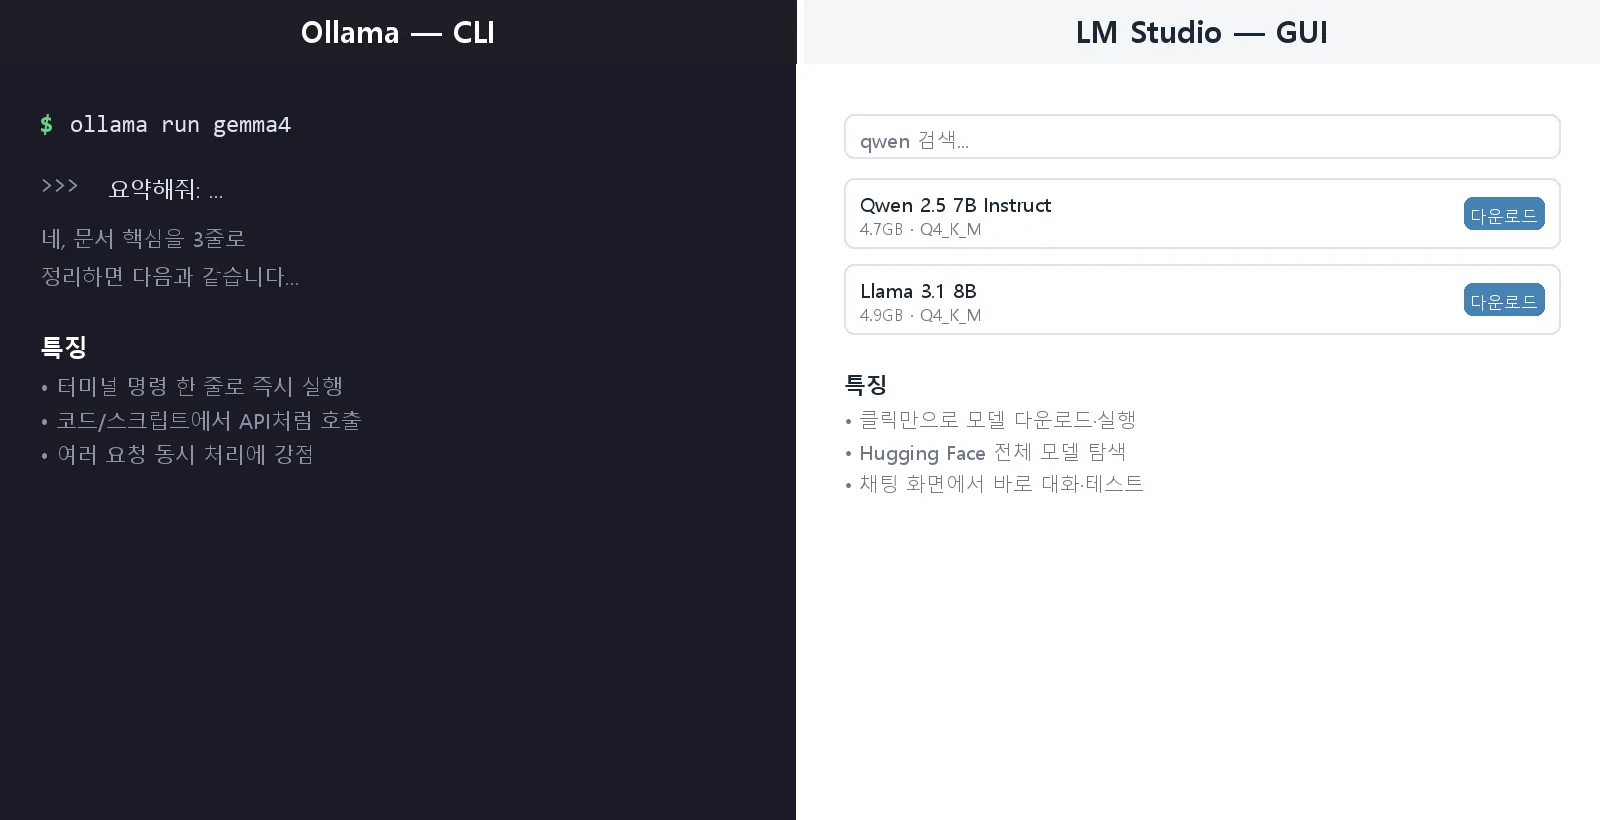
CLI 중심의 Ollama와 GUI 중심의 LM Studio를 설치 난이도·성능·용도 기준으로 비교한다.
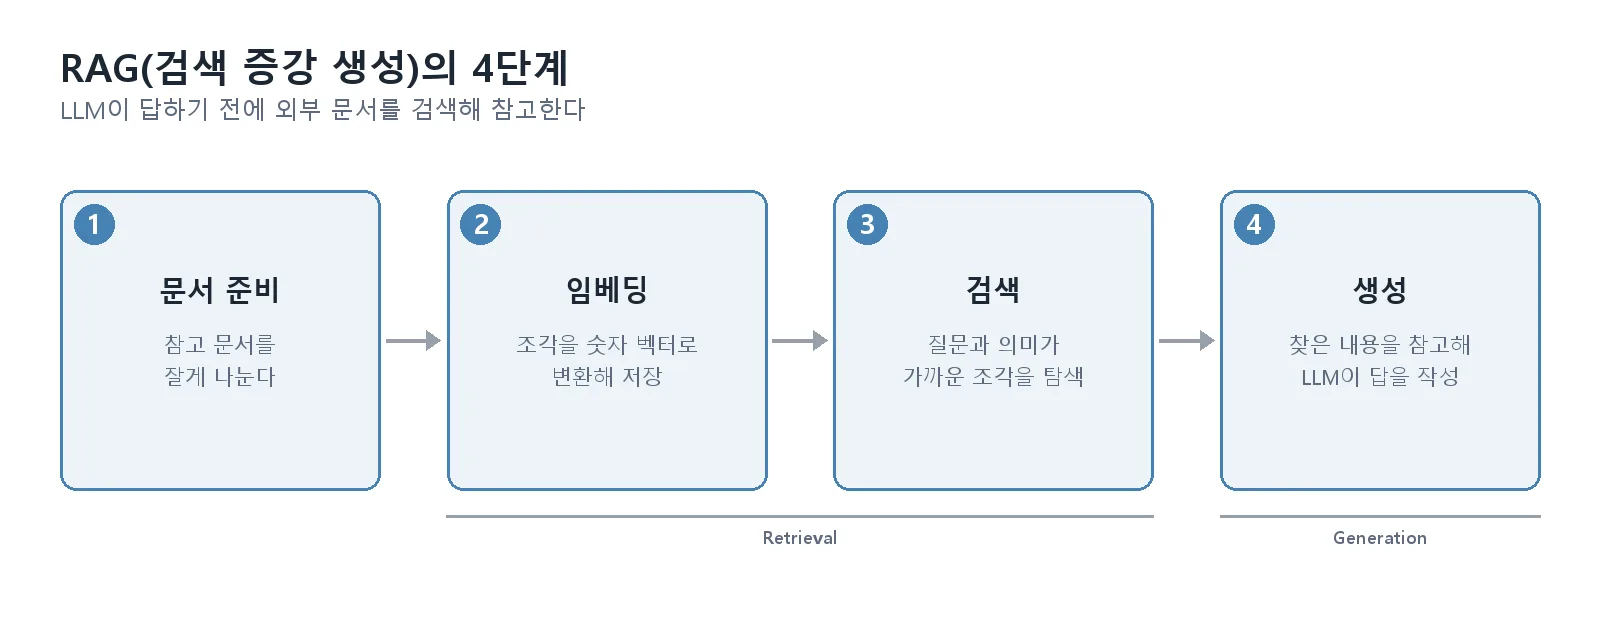
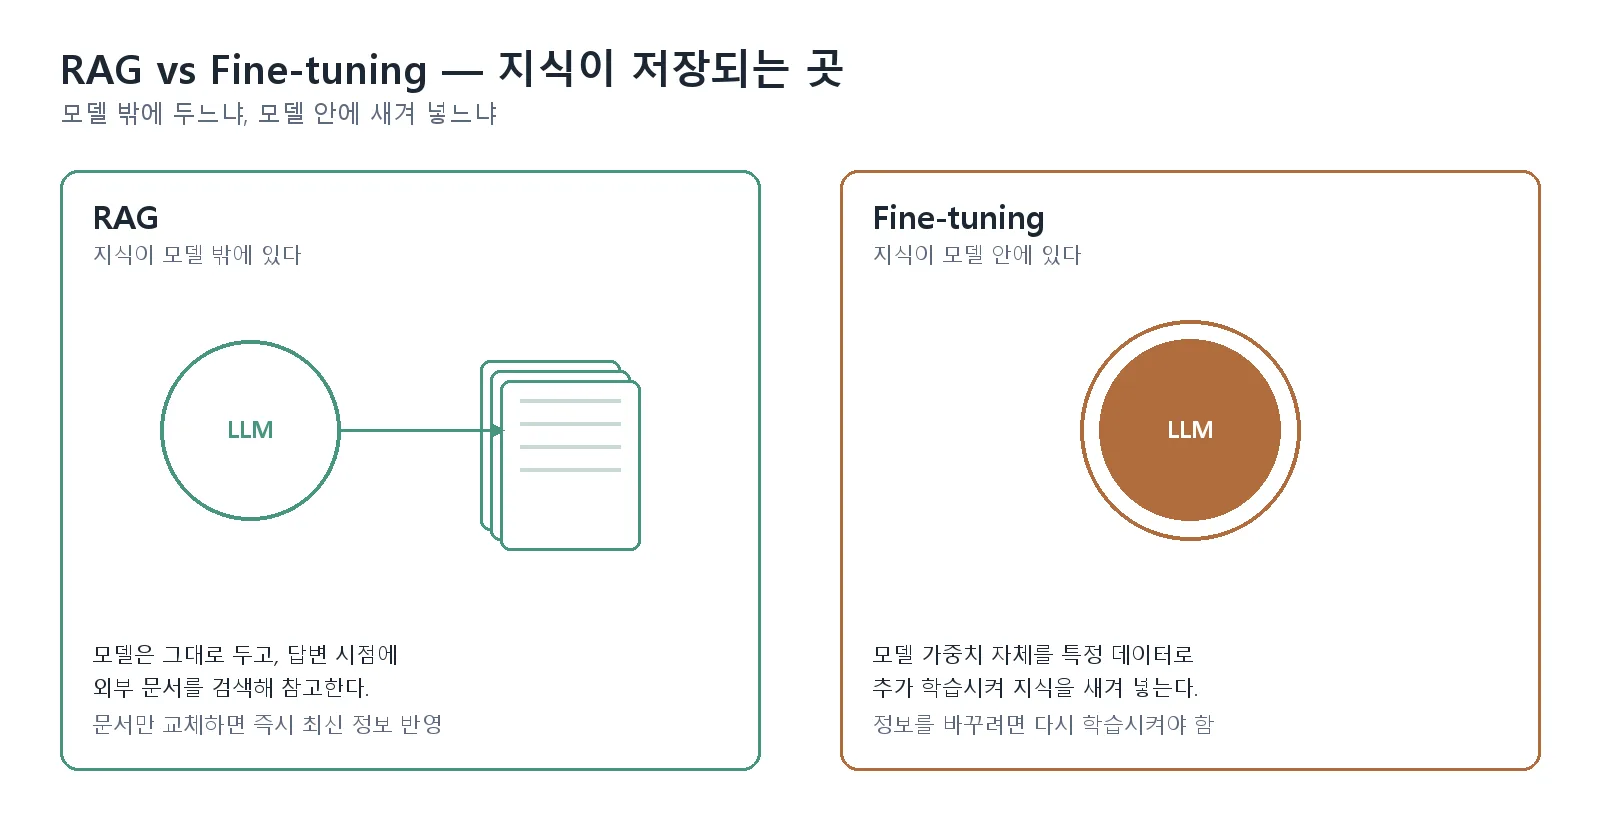
LLM을 특정 목적에 맞게 보강하는 두 가지 방법, RAG와 Fine-tuning의 차이와 각각 적합한 상황을 정리한다.
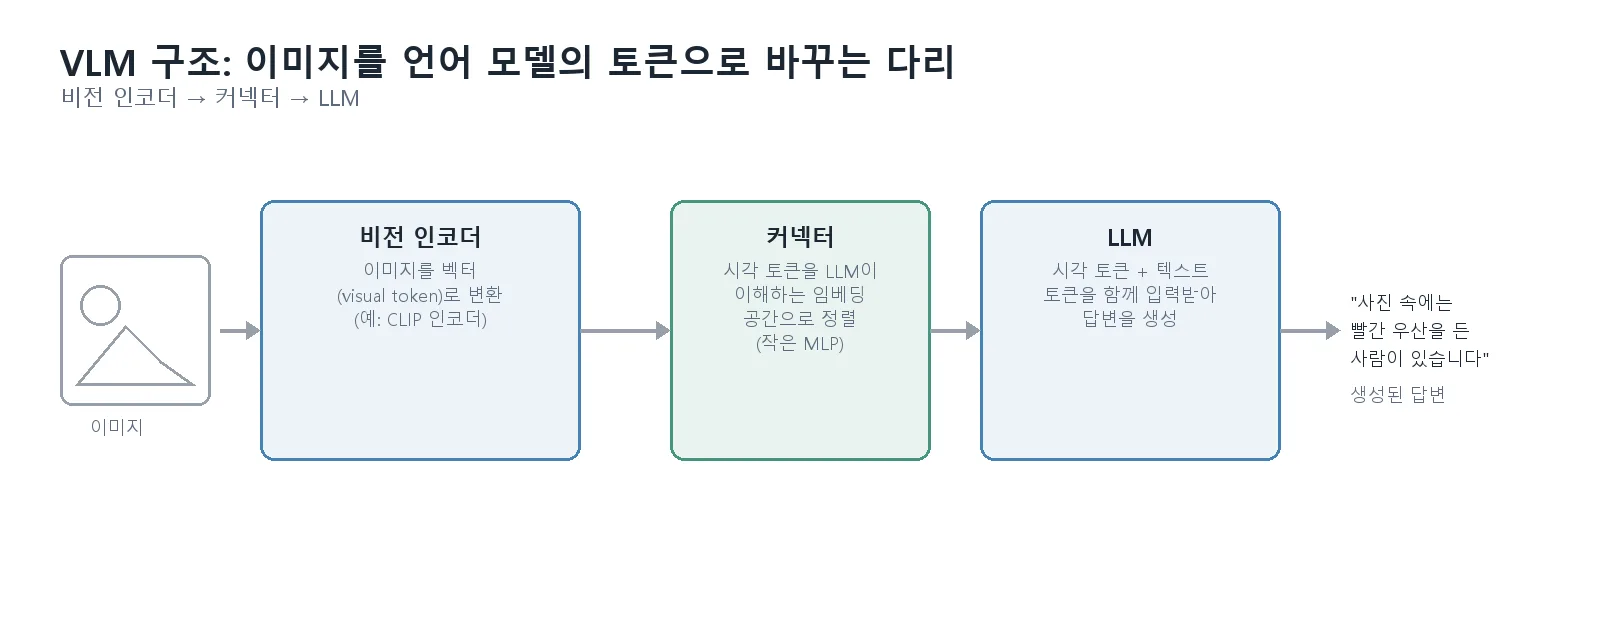
이미지와 텍스트를 함께 이해하는 Vision Language Model(VLM)이 CLIP, LLaVA 같은 구조로 어떻게 동작하는지 정리한다.
Physical AI가 기존 생성형 AI와 어떻게 다른지, 로봇·자율주행 등에서 어떻게 활용되는지 핵심 개념을 정리한다.