AI 작업에서 GPU VRAM이 중요한 이유
LLM을 GPU에서 돌릴 때 VRAM이 병목이 되는 이유와, 파라미터 수·양자화 수준에 따라 VRAM 사용량이 어떻게 달라지는지 정리한다.
GPU에서 LLM을 실행할 때 가장 먼저 막히는 자원은 연산 속도가 아니라 VRAM(그래픽 메모리) 용량이다. 모델 파라미터, 실행 중 계산 결과(KV 캐시), 중간 활성값(activation)이 전부 VRAM에 올라가야 하므로, VRAM이 부족하면 아예 모델을 로드하지 못하거나 속도가 크게 떨어진다.
VRAM을 채우는 세 가지 요소
- 모델 가중치(weights) — 파라미터 수와 정밀도(precision)에 의해 크기가 결정된다.
- KV 캐시(key-value cache) — 응답을 생성하는 동안 이전 토큰들의 attention 정보를 저장하는 공간으로, 대화가 길어지고 context 길이가 늘어날수록 커진다.
- 활성값·오버헤드 — 추론 과정에서 생기는 중간 계산값과 프레임워크 자체가 사용하는 여분의 메모리.
파라미터 수 × 정밀도로 계산하는 법
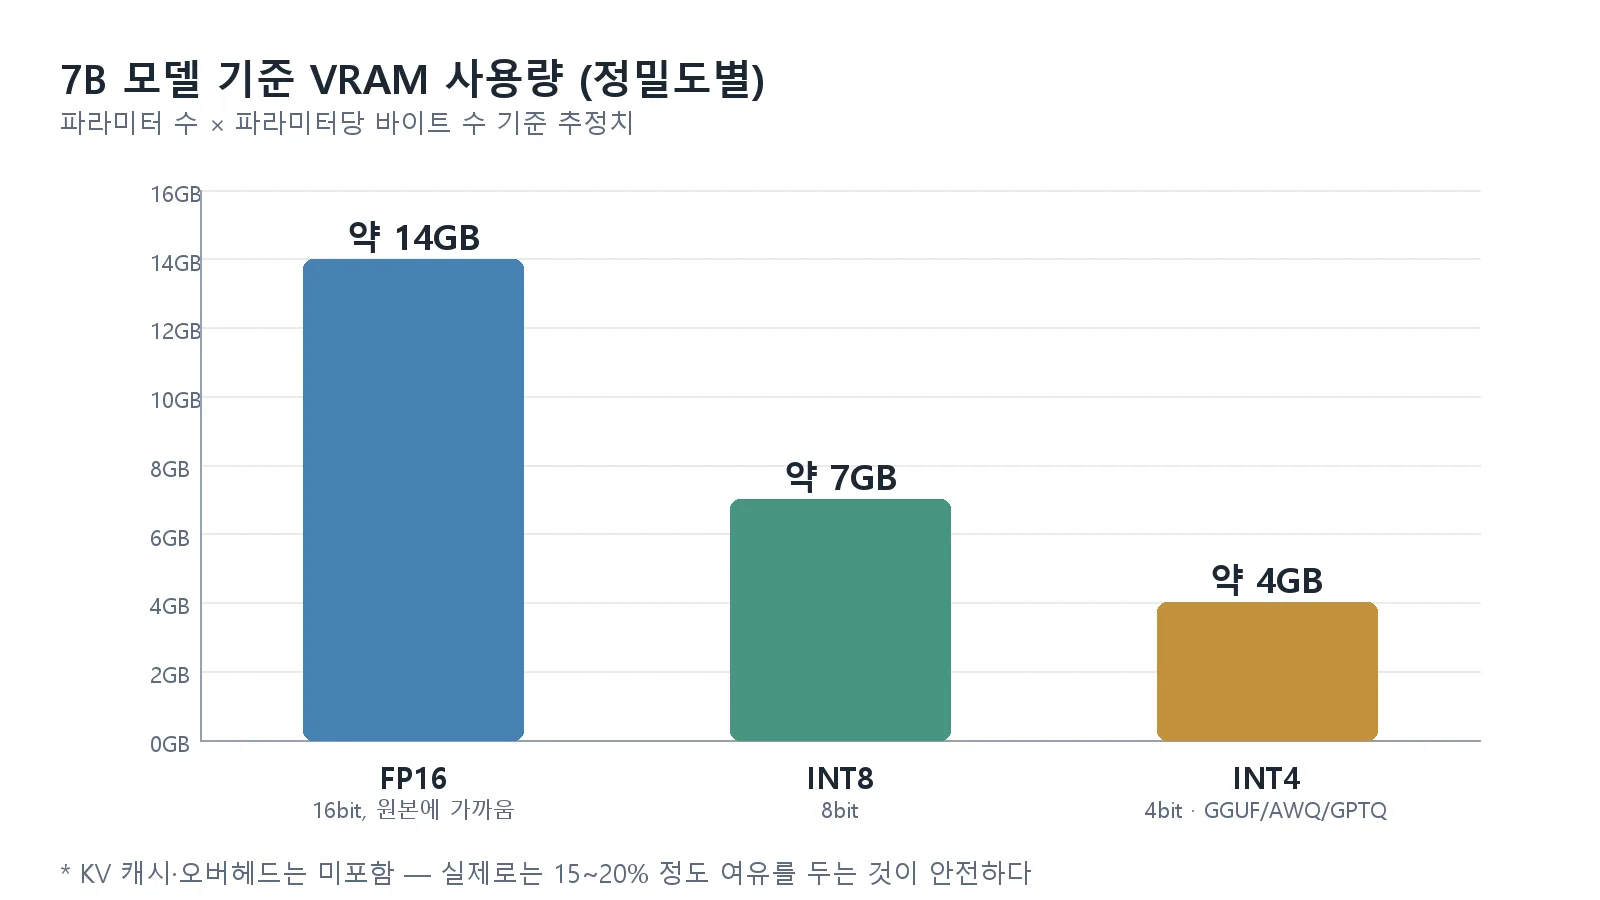
가중치가 차지하는 VRAM은 대략 “파라미터 수 × 파라미터당 바이트 수”로 추정할 수 있다.
| 정밀도(Quantization) | 파라미터당 용량 | 70억(7B) 모델 기준 |
|---|---|---|
| FP16(16bit, 원본에 가까움) | 약 2GB / 10억 파라미터 | 약 14GB |
| INT8(8bit) | 약 1GB / 10억 파라미터 | 약 7GB |
| INT4(4bit, GGUF/AWQ/GPTQ 등) | 약 0.5GB / 10억 파라미터 | 약 4GB |
여기에 KV 캐시와 오버헤드로 보통 15~20% 정도를 더 여유 있게 잡는 것이 안전하다. 즉 “모델 크기만 보고 딱 맞춰서” GPU를 고르면 대화가 길어졌을 때 VRAM이 부족해질 수 있다.
아래는 70억(7B) 파라미터 모델을 기준으로, 정밀도를 FP16 → INT8 → INT4로 낮출 때 가중치가 차지하는 VRAM이 어떻게 줄어드는지를 위 표와 동일한 수치로 그래프화한 것이다. 정밀도를 한 단계 낮출 때마다 용량이 대략 절반씩 줄어드는 것을 한눈에 볼 수 있다.
모델 크기별 대략적인 VRAM 기준 (4bit 양자화 기준)
| 파라미터 수 | 필요 VRAM(대략) |
|---|---|
| 7B | 약 8GB |
| 13B | 약 12~16GB |
| 70B | 약 40~48GB |
이 수치는 4bit 양자화, 일반적인 context 길이를 가정한 대략적인 값이며, 실제 필요량은 context 길이, 사용하는 추론 엔진(llama.cpp, vLLM 등), 배치 크기에 따라 달라진다. 정확한 값이 필요하다면 Hugging Face의 VRAM 계산 도구로 실제 모델과 조건을 넣어 확인하는 것이 안전하다.
양자화는 왜 VRAM을 줄여줄까
양자화는 모델 가중치를 표현하는 데 사용하는 비트 수를 줄이는 기법이다. FP16에서 INT4로 줄이면 이론상 가중치 용량이 1/4로 줄어든다. 최근의 GGUF, AWQ, GPTQ 같은 4bit 양자화 방식은 품질 저하를 최소화하면서도 큰 폭의 메모리 절감을 제공해, 소비자용 GPU로도 상당히 큰 모델을 실행할 수 있게 해준다. VRAM이 부족할 때 모델의 일부를 시스템 RAM으로 offload하는 방법도 있지만, 속도가 크게 느려지는 trade-off가 있다.
결론
GPU에서 AI 모델을 돌릴 때 VRAM은 단순한 “많으면 좋은 자원”이 아니라 모델을 실행할 수 있는지 없는지를 가르는 기준선이다. 파라미터 수와 양자화 수준으로 대략적인 VRAM 요구량을 먼저 가늠하고, 실제 사용할 context 길이를 고려해 여유를 두고 GPU를 선택하는 것이 안전하다. 실제로 어떤 GPU를 골라야 하는지는 로컬 LLM용 GPU는 VRAM이 얼마나 필요할까?에서 이어서 다룬다.