멀티모달 AI란? 텍스트·이미지·음성을 함께 이해하는 원리
하나의 모델이 텍스트·이미지·음성·영상을 동시에 이해하고 넘나들며 다루는 멀티모달 AI의 원리와, 이를 지탱하는 공유 임베딩 공간의 개념을 정리한다.
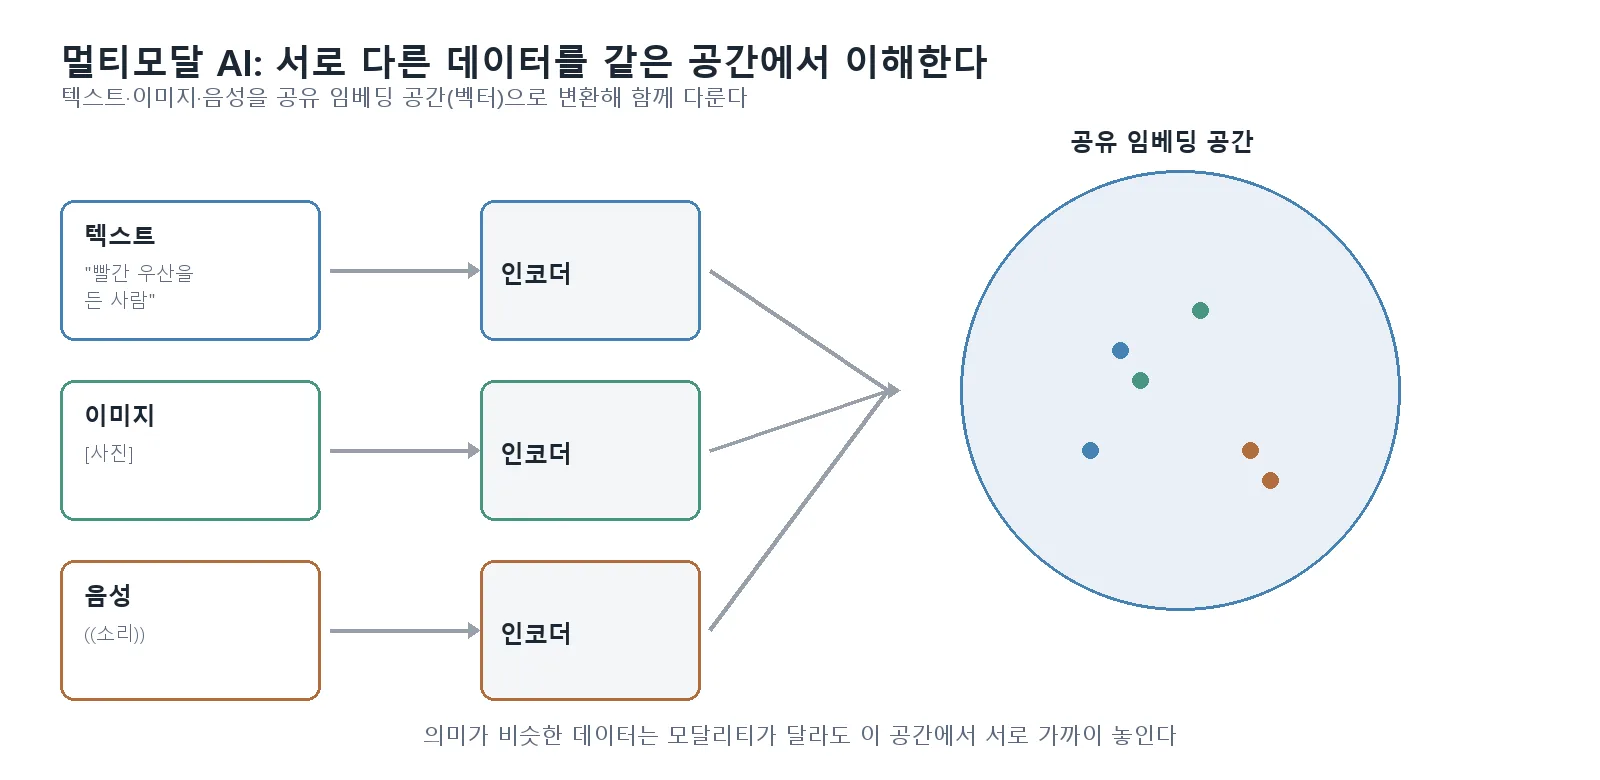
멀티모달 AI(Multimodal AI)는 텍스트·이미지·음성·영상처럼 서로 다른 종류(모달리티)의 데이터를 하나의 모델이 함께 이해하고, 필요하면 한 형태에서 다른 형태로 넘나들며 다루는 AI를 가리킨다. 사진 한 장을 보여주면 글로 설명하거나, 반대로 글로 된 설명을 보고 이미지를 만들어내는 식이다. Vision Language Model(VLM)이 “이미지+텍스트”라는 두 모달리티 조합에 초점을 맞춘 구체적인 모델 종류라면, 멀티모달 AI는 음성·영상까지 포함하는 더 넓은 개념이다.
기존 AI와 무엇이 다른가
과거 AI 모델 대부분은 텍스트면 텍스트, 이미지면 이미지 하나의 모달리티만 처리하도록 따로 만들어졌다. 멀티모달 AI는 이런 모델들을 이어 붙이는 대신, 서로 다른 종류의 데이터를 같은 방식으로 이해할 수 있게 만드는 것이 핵심이다.
어떻게 함께 이해하나: 공유 임베딩 공간
멀티모달 AI가 여러 데이터 종류를 동시에 다룰 수 있는 이유는, 텍스트·이미지·음성처럼 서로 다른 형태의 데이터를 모두 같은 숫자 벡터 공간(공유 임베딩 공간) 으로 변환하기 때문이다.
- 각 모달리티 전용 인코더(encoder)가 텍스트·이미지·음성을 각각 벡터로 바꾼다.
- 이 벡터들이 하나의 공유된 공간에 함께 놓이도록 학습된다 — 비슷한 의미를 가리키는 텍스트와 이미지는 이 공간에서 서로 가까운 위치에 놓인다.
- 어텐션(attention) 메커니즘이 한 모달리티의 토큰과 다른 모달리티의 토큰을 서로 비교해, 모달리티 간 관계를 연결한다.
이 구조 덕분에 “빨간 우산을 든 사람” 같은 텍스트와, 실제로 그런 장면이 담긴 이미지가 벡터 공간 안에서 자연스럽게 연결된다.
어디에 쓰이나
- 이미지 설명·검색: 사진을 보고 설명을 생성하거나, 텍스트로 원하는 이미지를 검색
- 음성 비서: 음성으로 질문하면 텍스트·이미지가 섞인 답변을 생성
- 문서·차트 이해: 표·그래프가 포함된 문서를 이미지 그대로 읽고 내용을 요약
- Physical AI: 로봇이 카메라(시각)와 마이크(청각) 입력을 함께 이해해 상황에 맞게 행동
멀티모달 AI와 관련 개념의 관계
| 개념 | 범위 |
|---|---|
| 멀티모달 AI | 텍스트·이미지·음성·영상 등 여러 모달리티를 함께 다루는 AI 전반 |
| Vision Language Model(VLM) | 이미지와 텍스트, 두 모달리티 조합에 특화된 모델 |
| RAG | 외부 문서를 검색해 답변에 활용하는 방식 — 최근에는 이미지·표가 섞인 문서까지 다루는 멀티모달 RAG로 확장되는 추세 |
한계와 주의할 점
- 모달리티가 늘어날수록 학습에 필요한 데이터 양과 연산 자원도 함께 늘어난다.
- 한 모달리티에서는 정확해 보이는 답변이 다른 모달리티와 결합될 때 부정확해지는(예: 이미지는 맞게 인식했지만 설명 문장이 틀리는) 경우가 있어, 모달리티 간 정합성 검증이 중요하다.
- 이 글은 개념 이해를 위한 입문 수준 설명이며, 특정 멀티모달 모델의 구체적인 벤치마크 성능은 다루지 않는다.
결론
멀티모달 AI는 서로 다른 종류의 데이터를 하나의 공유된 벡터 공간으로 연결해, 텍스트·이미지·음성을 넘나들며 이해하고 생성하는 AI다. VLM이 그중 이미지-텍스트 조합에 특화된 대표적인 사례이며, 앞으로 음성·영상까지 포함하는 범위로 계속 확장되는 흐름이다.