Computer Vision
Image Classification이란? CNN과 ImageNet이 연 딥러닝 비전의 시작
이미지 전체에 하나의 라벨을 붙이는 Image Classification의 개념과, CNN·ImageNet이 오늘날 Computer Vision 발전에 미친 영향을 정리한다.
Object Detection, Segmentation, Depth Estimation, 3D Reconstruction 등 비전 기술의 원리와 활용을 다룹니다.
AI와 Computer Vision을 다루는 기술 지식 허브
카메라 한 대로 찍은 이미지 한 장만으로 픽셀별 상대적 거리(깊이)를 예측하는 모노큘러 뎁스 추정 모델 Depth Anything의 원리와 구조를 정리한다.
이미지 전체에 하나의 라벨을 붙이는 Image Classification의 개념과, CNN·ImageNet이 오늘날 Computer Vision 발전에 미친 영향을 정리한다.
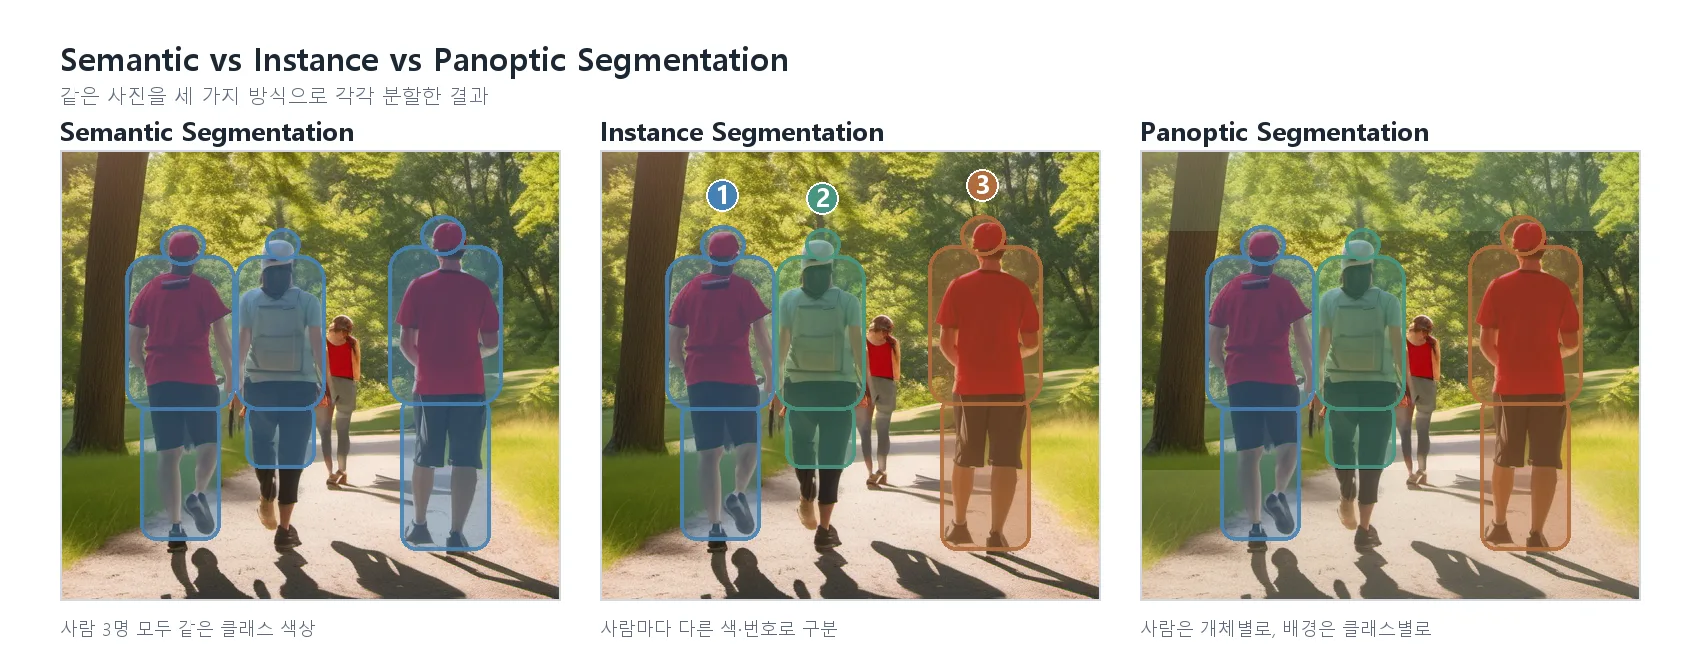
픽셀 단위로 이미지를 나누는 세 가지 Segmentation 방식 — Semantic, Instance, Panoptic — 이 각각 무엇을 구분하고 어떻게 다른지 비교한다.
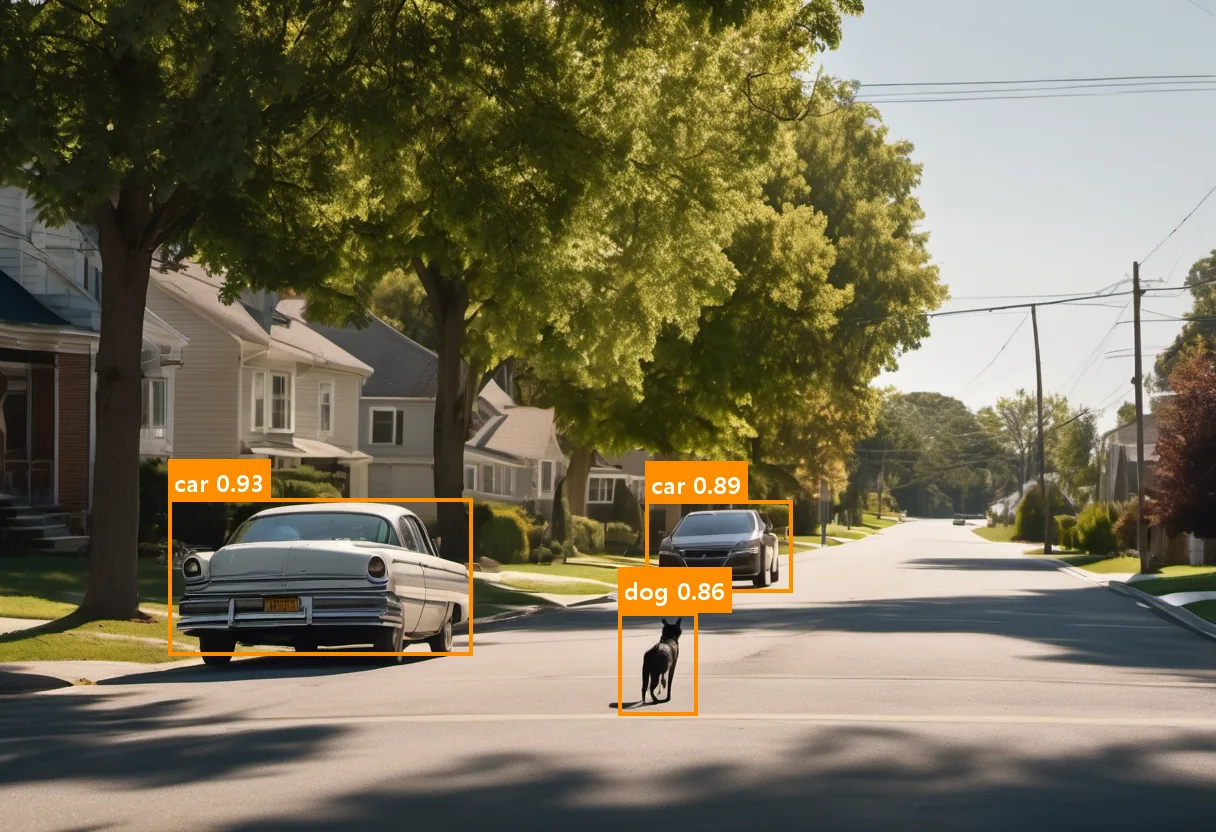
이미지 속 물체가 무엇인지(분류)와 어디에 있는지(위치 추정)를 동시에 예측하는 Object Detection의 개념과 대표 알고리즘 계열을 정리한다.
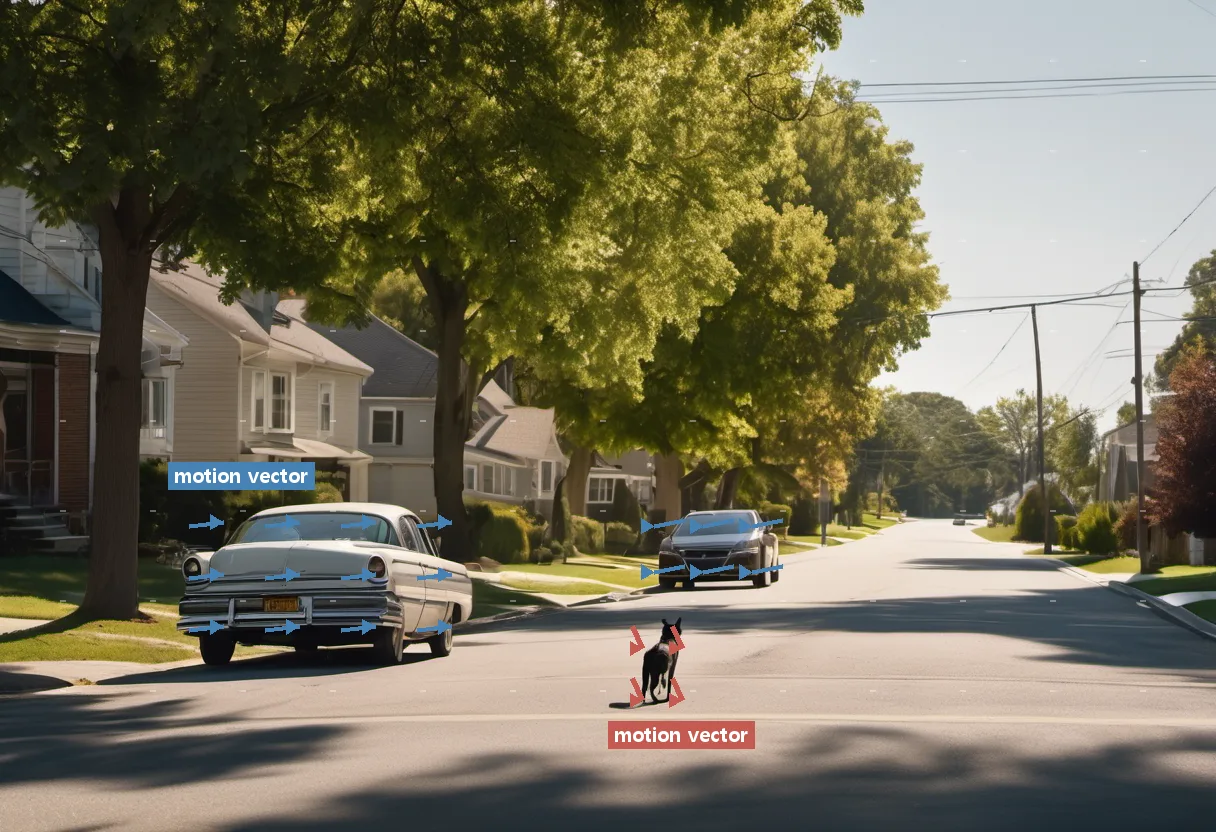
영상의 연속된 두 프레임 사이 픽셀 이동을 벡터로 표현하는 Optical Flow의 원리와, Sparse·Dense 방식의 차이를 정리한다.
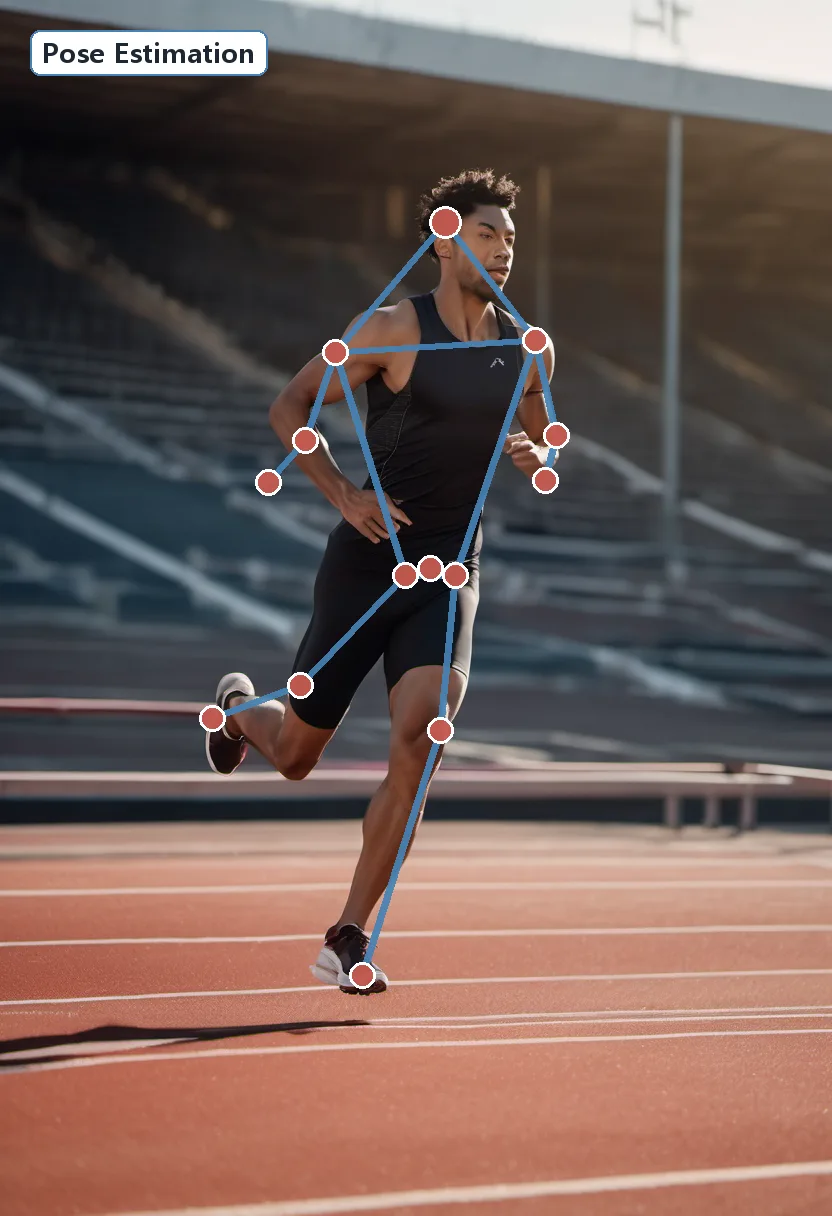
사람이나 동물의 관절 위치(키포인트)를 찾아 자세를 인식하는 Pose Estimation의 원리와 OpenPose 같은 대표 접근법을 정리한다.
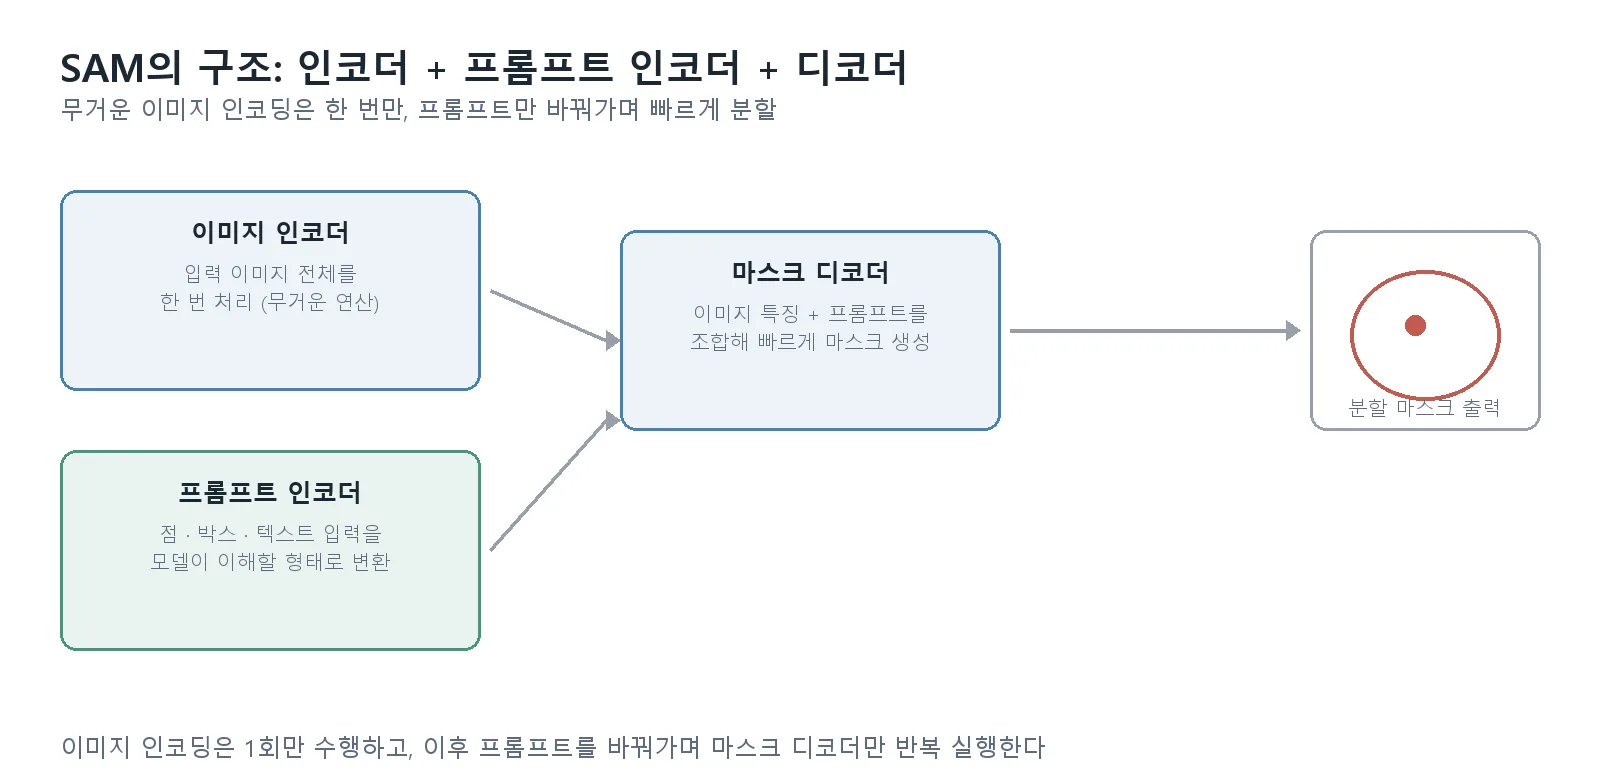
Meta AI가 공개한 범용 Segmentation 모델 SAM의 인코더-디코더 구조와 프롬프트 방식, SAM 2·SAM 3로 이어진 발전 과정을 정리한다.
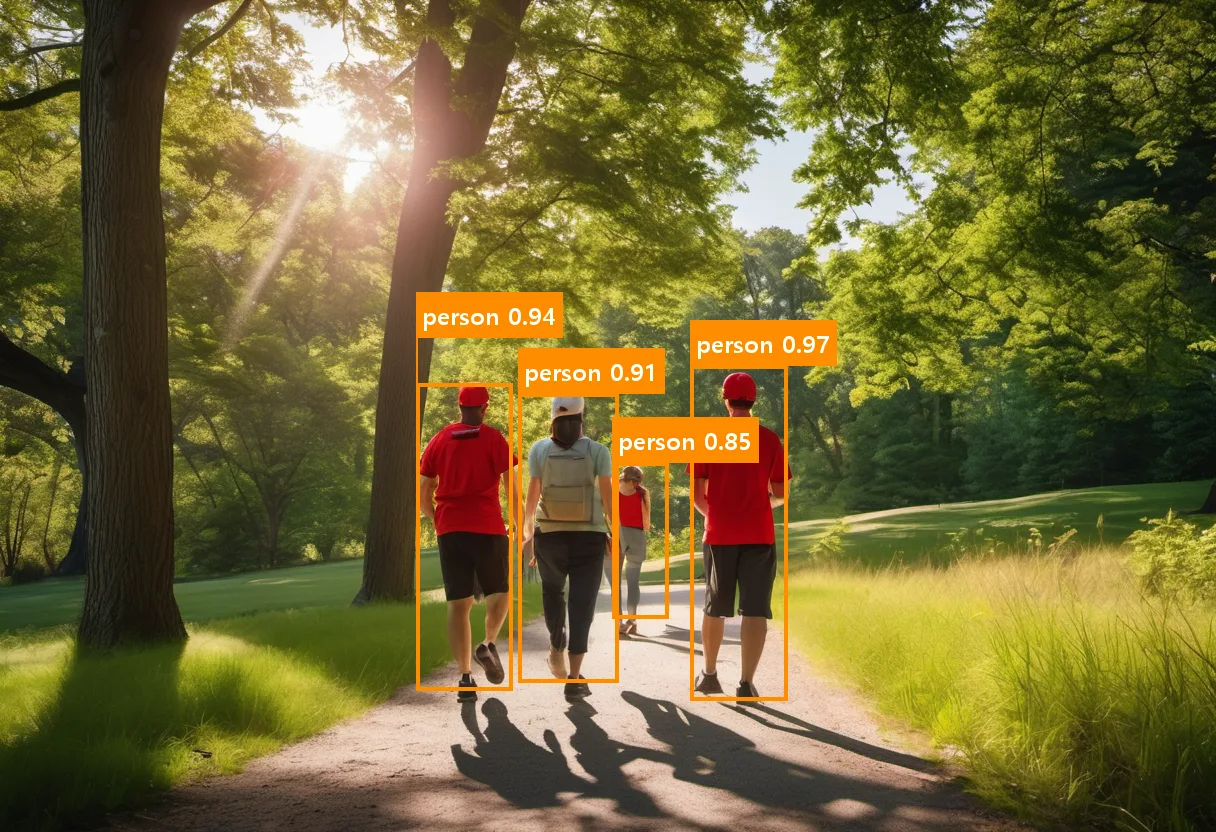
이미지를 한 번의 순전파로 처리해 물체 위치와 클래스를 동시에 예측하는 YOLO의 기본 원리와 최신 YOLO26의 구조 변화를 정리한다.
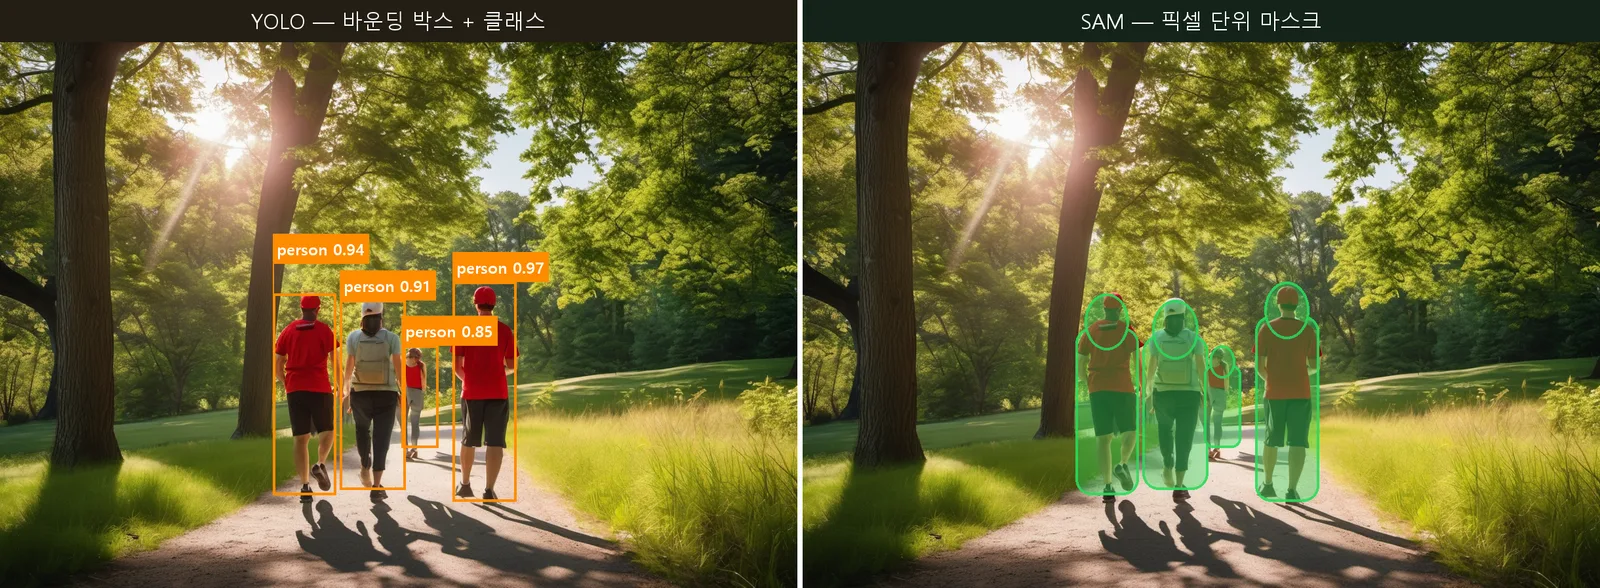
Object Detection의 대표 모델 YOLO와 Segmentation 모델 SAM이 어떤 문제를 풀고, 언제 어떤 것을 선택해야 하는지 비교한다.
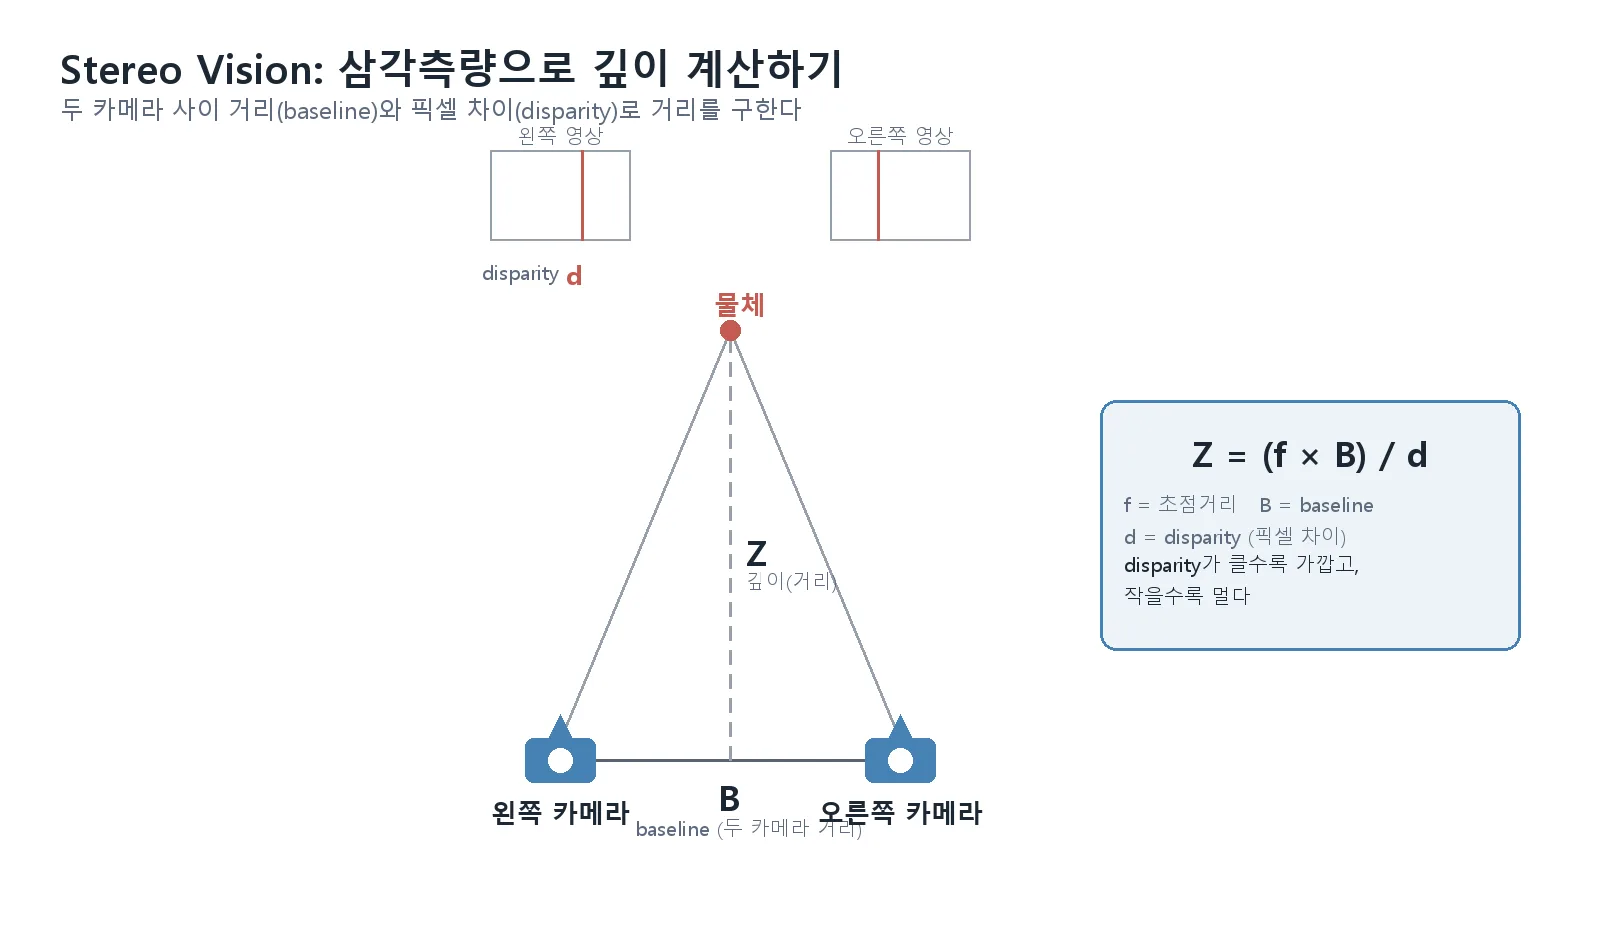
두 대의 카메라 영상만으로 물체까지의 거리를 계산하는 Stereo Vision의 삼각측량 원리와 기본 구현 흐름을 정리한다.