Segment Anything Model(SAM)이란? 이미지 분할 원리와 활용
Meta AI가 공개한 범용 Segmentation 모델 SAM의 인코더-디코더 구조와 프롬프트 방식, SAM 2·SAM 3로 이어진 발전 과정을 정리한다.
SAM(Segment Anything Model)은 Meta AI Research가 공개한 범용 Segmentation 모델로, 점이나 박스 같은 간단한 프롬프트만 주면 특정 클래스를 미리 학습하지 않아도 이미지 속 물체의 픽셀 단위 경계(mask)를 찾아낸다. SAM과 YOLO의 차이에서 다룬 것처럼, SAM은 “무엇인지 분류”하기보다 “어디까지가 이 물체인지 정확히 나누는” 문제를 푸는 모델이다.
SAM의 구조: 인코더 + 프롬프트 인코더 + 디코더
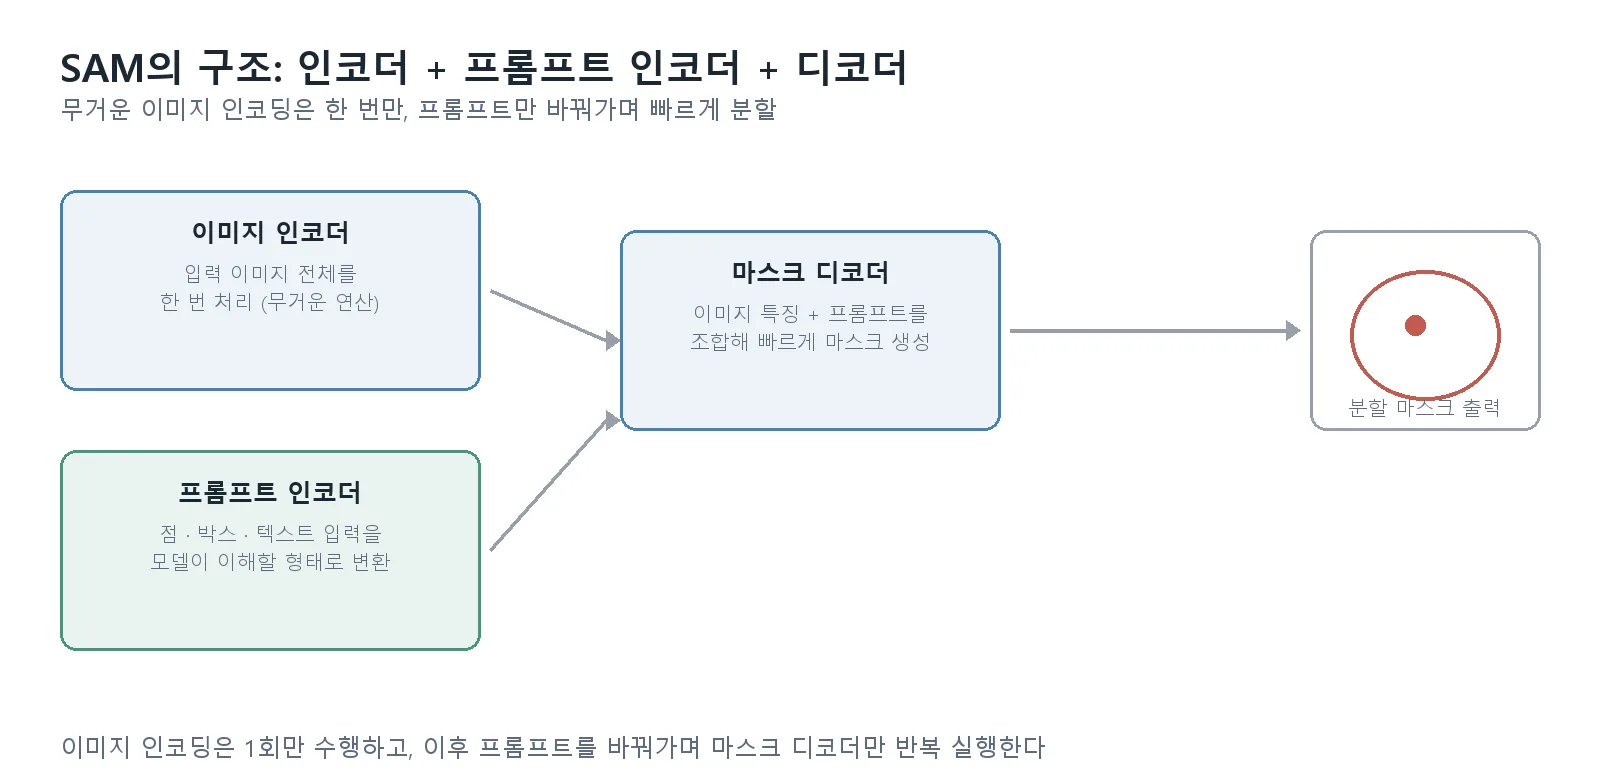
SAM은 세 부분으로 이루어져 있다.
- 이미지 인코더(image encoder) — 입력 이미지 전체를 한 번 처리해 특징(feature)을 추출하는, 상대적으로 무거운 연산을 담당하는 부분이다.
- 프롬프트 인코더(prompt encoder) — 점, 박스, 텍스트 같은 사용자 입력(프롬프트)을 모델이 이해할 수 있는 형태로 인코딩한다.
- 마스크 디코더(mask decoder) — 이미지 특징과 프롬프트 정보를 조합해, 빠른 속도로 분할 마스크를 생성하는 가벼운 디코더다.
이 구조 덕분에 무거운 이미지 인코딩은 한 번만 수행하고, 이후 프롬프트를 바꿔가며 마스크 디코더만 반복 실행해 다양한 물체를 빠르게 분할할 수 있다.
SA-1B: 대규모 분할 데이터셋
SAM은 1,100만 장의 다양한 고해상도 이미지와 11억 개의 분할 마스크로 이루어진 SA-1B 데이터셋으로 학습됐다. 이렇게 방대하고 다양한 데이터로 학습된 덕분에, 특정 클래스에 대해 별도로 미세조정하지 않아도 다양한 물체를 분할하는 zero-shot 성능을 보인다.
SAM → SAM 2 → SAM 3로 이어진 발전
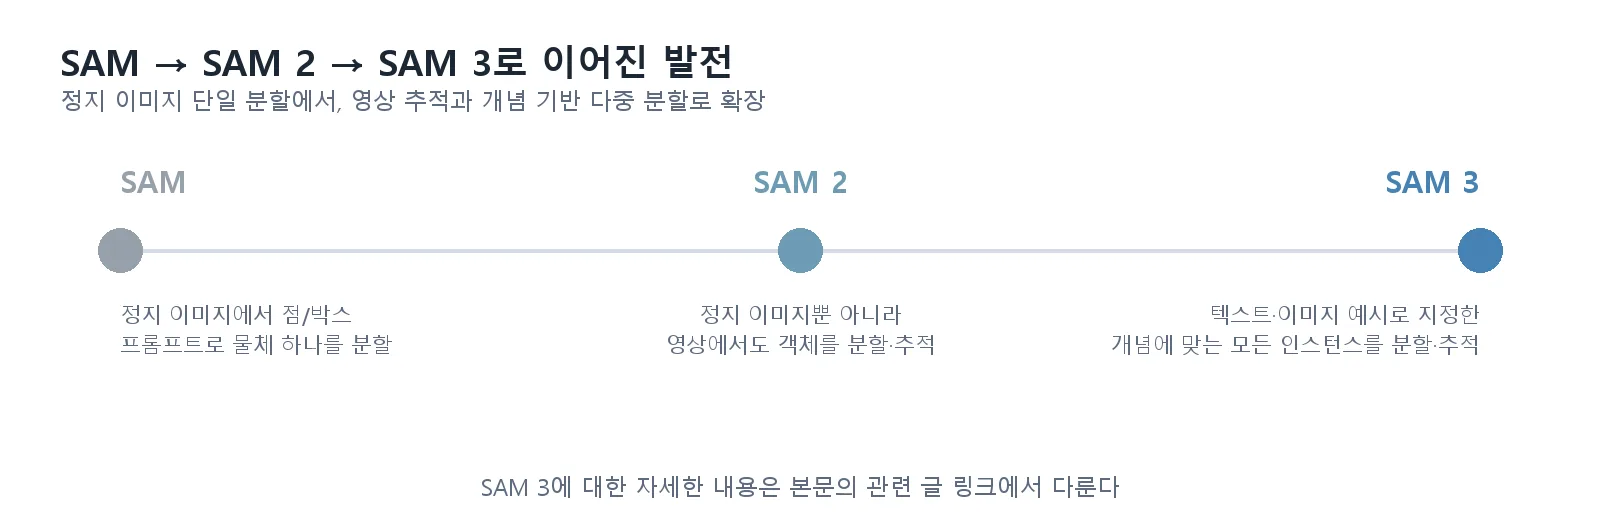
SAM 2(흔히 SAM2로도 표기), SAM 3(SAM3)로 이어지며 다음과 같이 능력이 확장됐다.
| 버전 | 핵심 능력 |
|---|---|
| SAM | 정지 이미지에서 점/박스 프롬프트로 물체 하나를 분할 |
| SAM 2 | 정지 이미지뿐 아니라 영상(video)에서도 객체를 분할·추적 |
| SAM 3 | 텍스트·이미지 예시로 “개념(concept)“을 지정하면 해당 개념에 맞는 모든 인스턴스를 이미지·영상 전체에서 분할·추적 |
SAM 3에 대한 자세한 내용은 Meta, 개념 기반 분할 모델 SAM 3 공개에서 다룬다.
모델 크기와 실무 활용
Ultralytics 문서 기준으로 SAM base 모델(sam_b.pt)은 약 375MB, 9,370만 개 파라미터 규모다. SAM 계열은 정확한 분할 마스크가 필요한 데이터 라벨링, 이미지·영상 편집 도구, 정밀한 영역 추출이 필요한 산업 검사 등에 쓰인다. 다만 SAM 자체는 물체를 “무엇인지” 분류하지 않으므로, 클래스 인식이 필요하면 YOLO 같은 탐지 모델이나 별도의 분류기와 함께 사용해야 한다.
결론
SAM은 이미지 인코더·프롬프트 인코더·마스크 디코더로 이루어진 구조를 통해, 특정 클래스 학습 없이도 다양한 물체를 정확하게 분할하는 범용 Segmentation 모델이다. 정지 이미지에서 시작해 영상 추적(SAM 2), 개념 기반 다중 인스턴스 분할(SAM 3)로 능력이 계속 확장되고 있다.