Image Classification이란? CNN과 ImageNet이 연 딥러닝 비전의 시작
이미지 전체에 하나의 라벨을 붙이는 Image Classification의 개념과, CNN·ImageNet이 오늘날 Computer Vision 발전에 미친 영향을 정리한다.
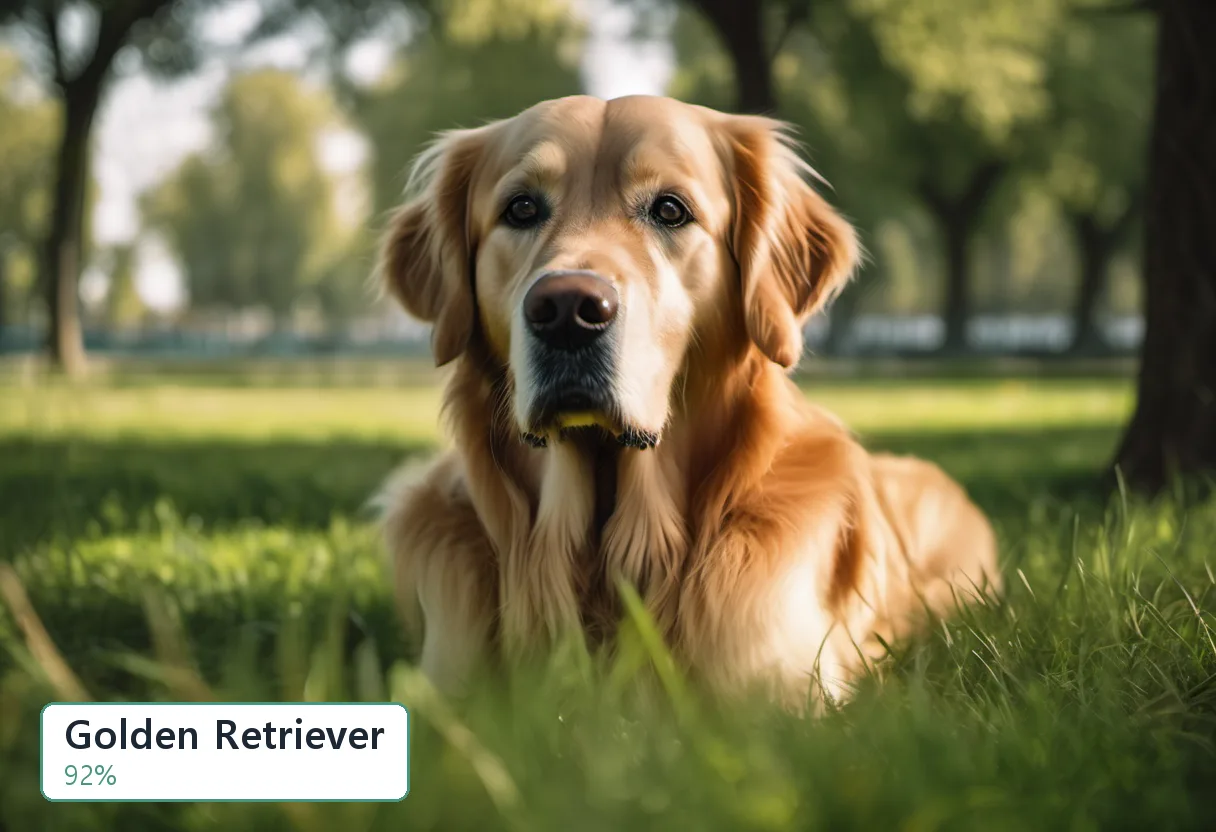
Image Classification(이미지 분류)은 입력 이미지 전체를 보고 미리 정의된 클래스 중 하나(또는 여러 개)의 라벨을 붙이는 Computer Vision의 가장 기본적인 과제다. “이 사진에 무엇이 있는가”라는 질문에 이미지 전체 단위로 답한다는 점에서, 물체마다 위치까지 찾아내는 Object Detection보다 단순하지만, 딥러닝 기반 Computer Vision 전체의 출발점이 된 과제다.
CNN: 이미지 분류의 표준 구조
Image Classification에 가장 널리 쓰여온 구조는 CNN(Convolutional Neural Network, 합성곱 신경망) 이다. CNN은 크게 두 종류의 층으로 이루어진다.
- 합성곱 층(convolutional layer): 작은 필터(커널)를 이미지 위에서 이동시키며 경계선·질감 같은 지역적 패턴을 추출해 특징 맵(feature map)을 만든다.
- 풀링 층(pooling layer): 특징 맵의 크기를 줄여 연산량을 낮추고, 이미지가 약간 이동하거나 변형돼도 같은 특징을 인식하도록 돕는다.
이 층들을 여러 겹 쌓으면 앞쪽 층은 경계선 같은 단순한 패턴을, 뒤쪽 층은 더 추상적인 형태(눈, 바퀴, 얼굴 등)를 인식하게 된다 — 딥러닝이 층을 거칠수록 더 추상적인 특징을 학습하는 원리가 이미지 분류에도 그대로 적용된다.
ImageNet: 딥러닝 비전 붐의 기폭제
ImageNet은 WordNet의 계층 구조를 바탕으로 만든 대규모 이미지 데이터셋으로, ImageNet-1k 기준 1,000개 클래스에 걸쳐 클래스당 평균 1,200장, 총 120만 장의 라벨링된 학습 이미지를 포함한다. 매년 이 데이터셋으로 모델 성능을 겨루는 ImageNet Large Scale Visual Recognition Challenge(ILSVRC)는 2012년 CNN 기반 모델(AlexNet)이 압도적인 성능 차이로 우승하면서, 이후 Computer Vision 연구가 딥러닝 중심으로 재편되는 계기가 됐다. ImageNet으로 사전 학습(pretrain)된 모델은 분류뿐 아니라 물체 인식, Segmentation 등 다른 Computer Vision 과제의 출발점(backbone)으로도 널리 재사용된다.
어디에 쓰이나
- 스팸·부적절 이미지 자동 분류, 콘텐츠 모더레이션
- 의료 영상에서 병변 유무 1차 판별(정밀 진단은 별도 검증 필요)
- 제조업 품질 검사에서 양품/불량 1차 분류
- 다른 Computer Vision 모델의 사전 학습된 백본(backbone)으로 재사용
Object Detection·Segmentation과의 관계
Image Classification은 “이미지 전체 = 클래스 1개”라는 가장 단순한 형태의 과제이지만, 여기서 학습된 특징 추출 능력은 더 복잡한 과제의 토대가 된다.
| 과제 | 출력 단위 |
|---|---|
| Image Classification | 이미지 전체에 클래스 1개(또는 여러 개) |
| Object Detection | 물체마다 바운딩 박스 + 클래스 |
| Segmentation | 픽셀마다 클래스(또는 인스턴스 구분) |
한계와 주의할 점
- 이미지 안에 여러 물체가 있어도 대표 라벨 하나(또는 정해진 개수)만 출력하므로, 물체의 개수나 위치는 알 수 없다.
- 학습 데이터의 클래스 분포에 편향이 있으면 실제 환경에서 오분류가 늘어날 수 있다.
- ImageNet 같은 벤치마크 성능이 높다고 해서 실제 도메인(예: 의료 영상, 위성 사진)에서도 같은 성능이 보장되지는 않는다 — 도메인에 맞는 데이터로 추가 검증이 필요하다.
결론
Image Classification은 이미지 전체에 하나의 라벨을 붙이는 가장 단순한 형태의 Computer Vision 과제이지만, CNN과 ImageNet이라는 두 축을 통해 오늘날 딥러닝 기반 비전 기술 전체의 토대를 놓았다. 여기서 검증된 특징 추출 방식은 이후 Object Detection, Segmentation 같은 더 정교한 과제로 자연스럽게 확장된다.