딥러닝(Deep Learning)이란? 머신러닝과 무엇이 다른가
인공신경망을 여러 층으로 쌓아 이미지·텍스트 같은 비정형 데이터를 학습하는 딥러닝의 원리와, 머신러닝과의 실질적 차이를 정리한다.
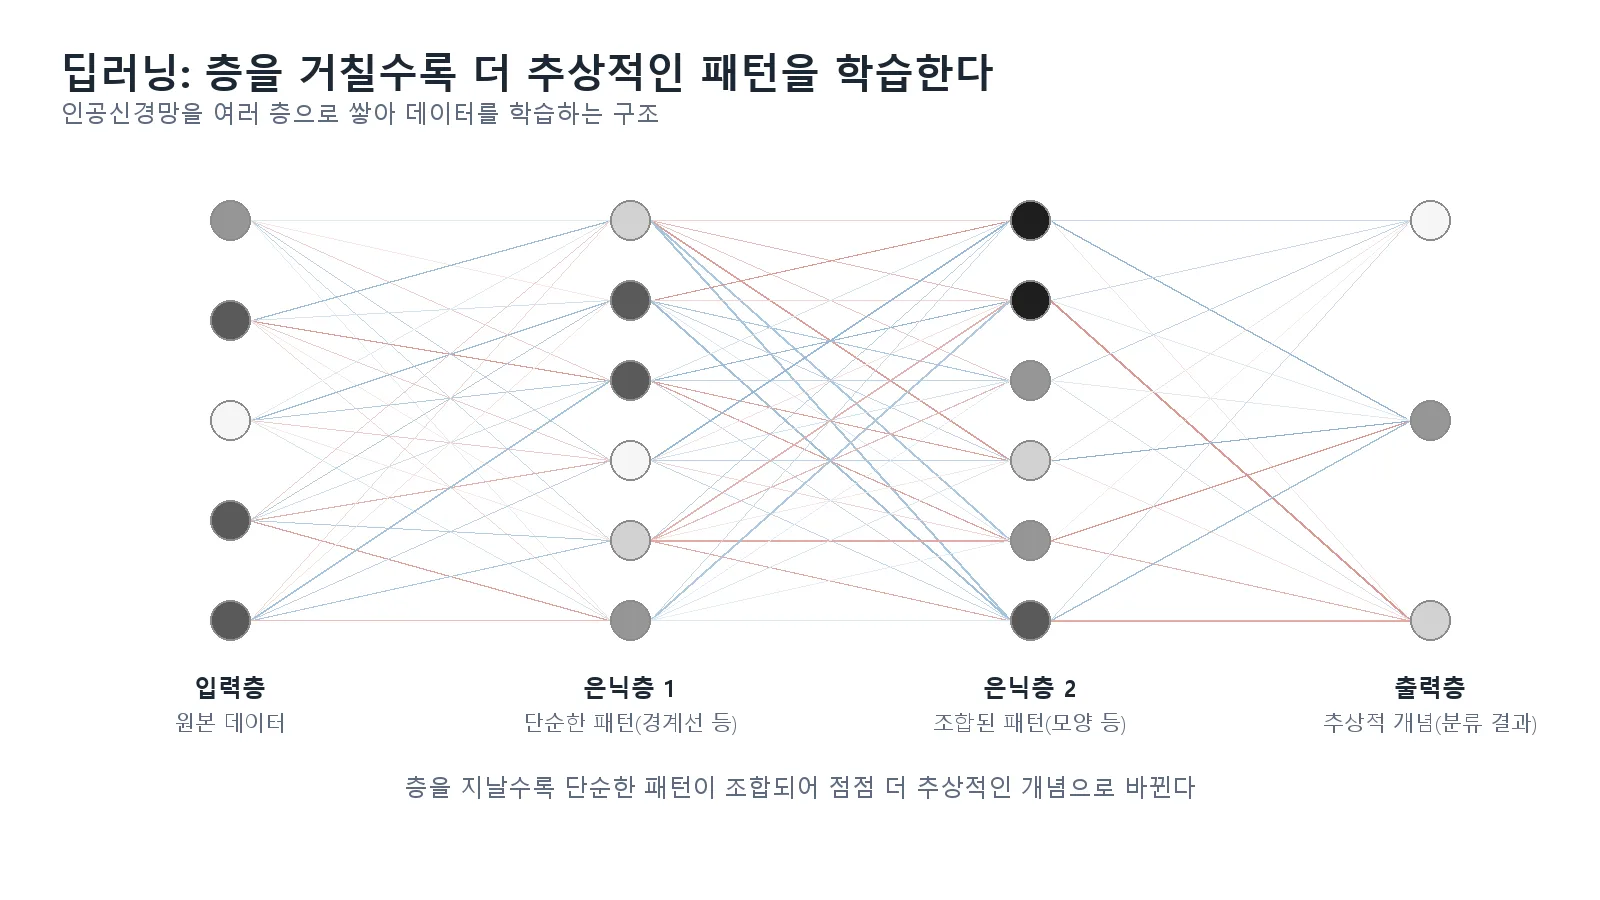
딥러닝(Deep Learning)은 머신러닝의 한 갈래로, 사람 뇌의 뉴런 연결 구조를 본뜬 인공신경망(Neural Network)을 여러 층(layer)으로 깊게 쌓아 데이터를 학습하는 방식이다. “딥(Deep)“이라는 이름은 이 층이 여러 겹으로 깊다는 데서 왔다. 오늘날 이 사이트에서 다루는 LLM이나 Object Detection·Segmentation 모델은 대부분 딥러닝을 기반으로 한다.
머신러닝과의 실질적 차이
| 구분 | 머신러닝 | 딥러닝 |
|---|---|---|
| 잘 다루는 데이터 | 작은~중간 규모의 정형 데이터(표) | 대량의 비정형 데이터(이미지, 텍스트, 음성) |
| 특징 추출(feature engineering) | 사람이 직접 설계하는 경우가 많음 | 신경망이 자동으로 특징을 학습 |
| 필요 연산 자원 | 일반 CPU로도 충분한 경우가 많음 | 대부분 GPU/TPU 같은 고성능 연산 장치 필요 |
| 학습 시간 | 상대적으로 빠름 | 신경망 구조가 복잡할수록 오래 걸림 |
| 결과 해석 | 상대적으로 해석하기 쉬움 | “왜 그렇게 판단했는지” 설명이 어려운 경우가 많음(블랙박스 성격) |
왜 딥러닝이 이미지·텍스트에 강한가
전통적인 머신러닝은 사람이 “이 이미지에서 어떤 특징을 볼 것인가”를 직접 설계해야 했다. 딥러닝은 이 과정을 신경망이 스스로 학습한다 — 첫 번째 층은 아주 단순한 패턴(경계선 등)을, 다음 층은 그것들을 조합한 조금 더 복잡한 패턴(모양)을, 그다음 층은 더 추상적인 개념(물체 종류)을 인식하는 식으로 층을 거칠수록 점점 더 추상적인 특징을 자동으로 뽑아낸다. 이 자동화 덕분에 이미지나 자연어처럼 사람이 일일이 규칙을 정하기 어려운 복잡한 데이터에서 강점을 보인다.
이 사이트에서 다루는 딥러닝 응용 사례
- LLM (거대 언어 모델): Claude Sonnet 5, GPT-5.6 같은 모델은 트랜스포머(Transformer)라는 딥러닝 구조를 기반으로 한다.
- Object Detection·Segmentation: YOLO와 SAM은 이미지 속 물체를 찾고 경계를 구분하는 데 딥러닝 신경망을 사용한다.
- Physical AI: 로봇이 카메라로 주변을 인식하는 과정도 대부분 딥러닝 기반 컴퓨터 비전 모델에 의존한다.
대표적인 신경망 구조 (용어만 소개)
- CNN(합성곱 신경망): 이미지 처리에 강한 구조. 물체 인식, 이미지 분류 등에 쓰인다.
- Transformer(트랜스포머): 문장 속 단어 간 관계를 병렬로 처리하는 구조로, 현재 대부분의 LLM이 이 구조를 기반으로 한다.
각 구조의 세부 원리는 별도 글에서 더 깊이 다룰 수 있다.
한계와 주의할 점
- 딥러닝은 학습에 많은 데이터와 연산 자원(GPU)이 필요해, 데이터가 적거나 설명 가능성이 중요한 문제에는 오히려 전통적 머신러닝이 더 적합할 수 있다.
- “블랙박스” 성격 때문에 왜 특정 결과가 나왔는지 설명하기 어려운 경우가 많다 — 의료·금융처럼 판단 근거가 중요한 분야에서는 이 점이 실무적 제약이 된다.
- 이 글은 개념 이해를 위한 입문 수준 설명이며, 실제 구현에 필요한 수학적 세부사항(역전파, 손실함수 등)은 다루지 않는다.
결론
딥러닝은 인공신경망을 깊게 쌓아 이미지·텍스트 같은 복잡한 비정형 데이터에서 사람이 직접 규칙을 정하지 않아도 패턴을 학습하는 머신러닝의 한 갈래다. 이 사이트에서 다루는 LLM과 Computer Vision 모델 대부분이 이 딥러닝을 기반으로 하고 있어, 다른 글들을 더 깊이 이해하는 데 이 개념이 출발점이 된다.