Vector Database란? 일반 데이터베이스와 다른 점
의미 기반으로 데이터를 검색하는 Vector Database가 일반 데이터베이스와 무엇이 다른지, Embedding·유사도 검색 원리를 중심으로 정리한다.
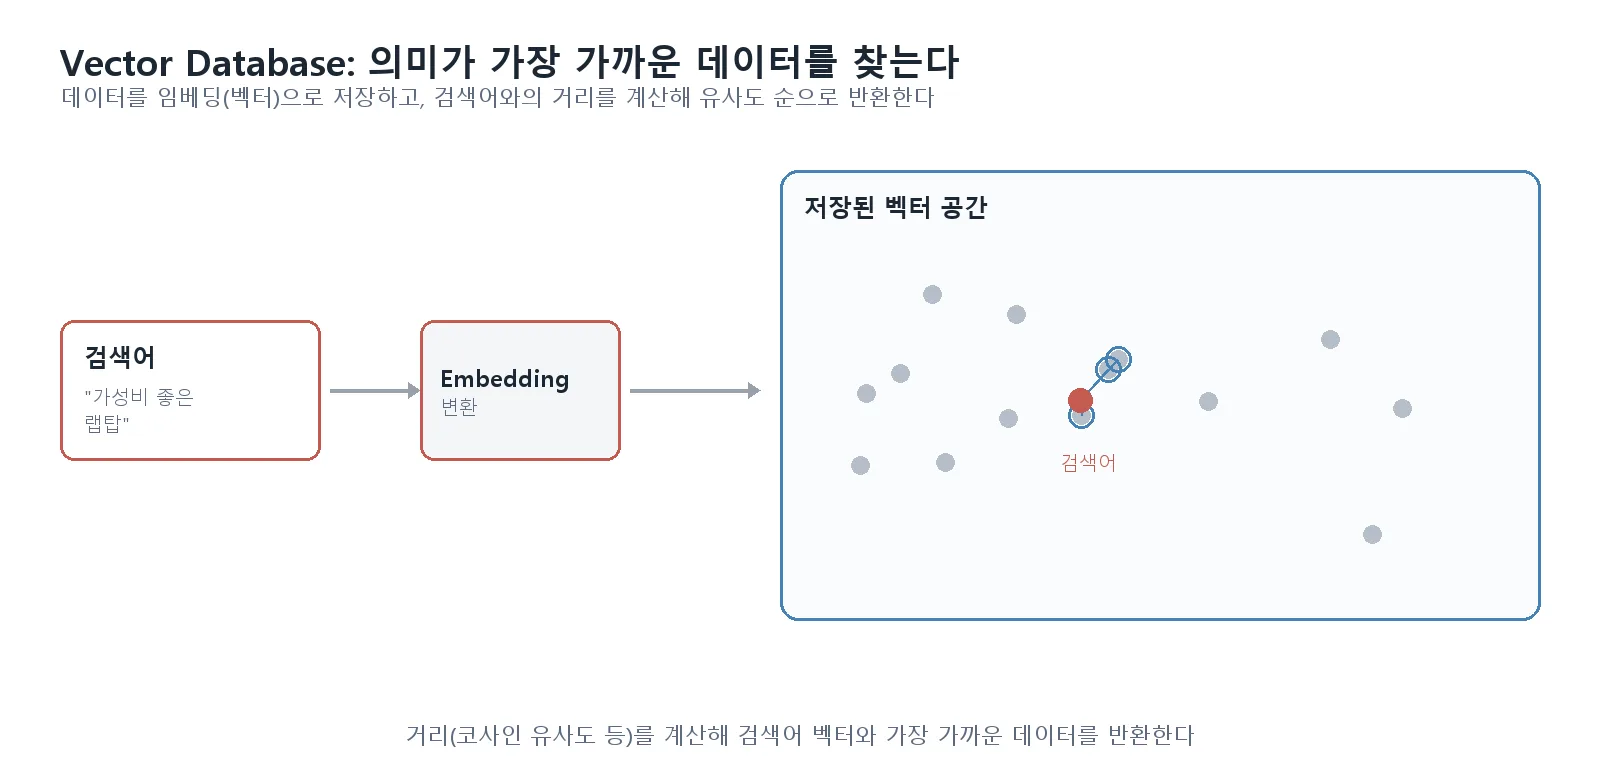
Vector Database(벡터 데이터베이스)는 텍스트·이미지 같은 데이터를 숫자 벡터(embedding, 임베딩)로 변환해 저장하고, “정확히 일치하는 값”이 아니라 “의미상 가장 비슷한 값”을 찾아주는 데이터베이스다. RAG가 외부 문서를 검색해 LLM의 답변에 활용하는 구조에서, 그 “검색”을 실제로 담당하는 저장소가 바로 Vector Database다.
일반 데이터베이스와 무엇이 다른가
| 일반 데이터베이스 | Vector Database | |
|---|---|---|
| 검색 방식 | 정확히 일치하는 값 조회(exact match) | 의미상 가장 가까운 값 검색(유사도 검색) |
| 저장하는 것 | 정형화된 값(숫자, 문자열 등) | 데이터의 의미를 담은 임베딩 벡터 |
| 적합한 질문 | “이 ID의 레코드는?” | “이 문장과 의미가 가장 비슷한 문서는?” |
예를 들어 “저렴한 노트북 추천”이라는 검색어를 일반 데이터베이스에 넣으면 이 문구가 정확히 포함된 레코드만 찾는다. Vector Database는 이 문장을 임베딩으로 바꾼 뒤, “가성비 좋은 랩탑”처럼 표현은 다르지만 의미가 비슷한 데이터도 함께 찾아낸다.
Embedding: 의미를 숫자로 바꾸는 과정
Embedding은 텍스트·이미지·음성 같은 데이터를 고차원 공간의 좌표(숫자 벡터)로 변환한 것이다. 의미가 비슷한 데이터일수록 이 공간에서 서로 가까운 위치에 놓인다. Vector Database는 이렇게 만들어진 벡터들을 저장해두고, 검색 시점에 입력값도 같은 방식으로 벡터로 바꿔 저장된 벡터들과 거리를 비교한다.
유사도 검색은 어떻게 이뤄지나
Vector Database는 코사인 유사도(cosine similarity)·유클리드 거리(Euclidean distance) 같은 거리 계산법으로 벡터 간 가까운 정도를 측정한다. 저장된 벡터 수가 많아지면 모든 벡터와 일일이 거리를 계산하는 방식은 느려지기 때문에, 실제로는 HNSW·IVF 같은 근사 최근접 이웃(ANN, Approximate Nearest Neighbor) 알고리즘으로 정확도를 약간 희생하는 대신 검색 속도를 크게 높인다.
어디에 쓰이나
- RAG: 질문과 의미가 비슷한 문서 조각을 찾아 LLM에 함께 전달
- 추천 시스템: “이 상품과 비슷한 상품” 추천
- 이미지·음성 검색: 텍스트로 원하는 이미지를 찾거나, 비슷한 소리를 찾는 검색
- 멀티모달 AI: 텍스트·이미지처럼 서로 다른 모달리티를 같은 벡터 공간에서 함께 검색
한계와 주의할 점
- 근사 최근접 이웃 알고리즘은 속도를 위해 정확도를 일부 희생하므로, 완벽하게 가장 가까운 결과만 반환한다고 보장하지는 않는다.
- Embedding 품질(어떤 모델로 벡터를 만들었는지)이 검색 결과의 질을 크게 좌우한다 — Vector Database 자체가 좋아도 Embedding이 부실하면 검색 결과도 부정확해진다.
- 저장하는 벡터 차원 수와 데이터 양이 늘어날수록 메모리·연산 비용이 함께 증가한다.
결론
Vector Database는 데이터를 “정확히 일치하는지”가 아니라 “의미가 얼마나 비슷한지”로 검색할 수 있게 해주는 저장소로, RAG를 비롯한 여러 AI 응용의 검색 단계를 실제로 담당하는 핵심 구성 요소다. Embedding으로 데이터를 벡터화하고, 유사도 검색으로 가장 가까운 결과를 찾아내는 두 단계가 이 기술의 핵심이다.