RAG란? LLM이 외부 문서를 활용하는 원리
LLM이 학습 당시 몰랐던 최신 정보나 사내 문서를 답변에 반영할 수 있게 해주는 RAG(검색 증강 생성)의 원리를 정리한다.
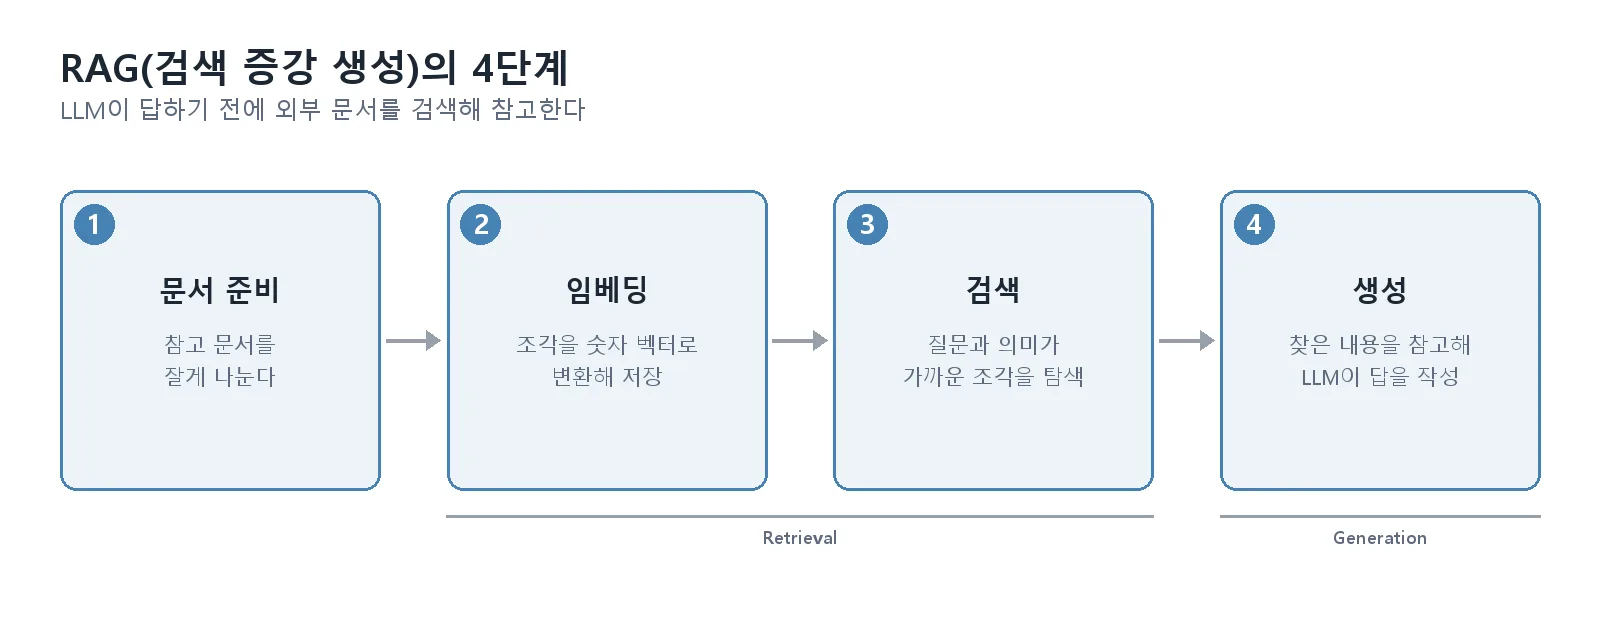
RAG(Retrieval-Augmented Generation, 검색 증강 생성)는 LLM이 답변을 생성하기 전에 외부 문서에서 관련 내용을 먼저 검색해, 그 내용을 참고해 답하게 하는 기법이다. LLM은 학습 시점까지의 정보만 알고 있는데, RAG를 쓰면 학습 이후에 나온 최신 정보나 회사 내부 문서처럼 애초에 학습되지 않은 정보도 답변에 반영할 수 있다.
왜 필요한가
LLM은 학습 데이터에 없는 내용은 모른다 — 그리고 모른다는 사실을 인정하는 대신 그럴듯하게 지어내는 “환각(hallucination)” 현상을 보이기도 한다. RAG는 이 문제를 상당히 줄여준다. 답을 LLM의 기억에만 의존하지 않고, 실제로 검색해 찾아낸 문서에 근거하게 만들기 때문이다.
기본 작동 원리
- 문서 준비: 참고할 문서(사내 위키, 매뉴얼, 최신 뉴스 등)를 잘게 나눈다.
- 임베딩(Embedding): 각 조각을 컴퓨터가 의미 유사도를 계산할 수 있는 숫자 벡터로 변환해 벡터 데이터베이스(Vector DB)에 저장해둔다.
- 검색(Retrieval): 사용자가 질문하면, 질문도 같은 방식으로 벡터로 변환해 저장된 문서 중 의미가 가장 가까운 조각들을 찾는다.
- 생성(Generation): 찾아낸 문서 조각을 질문과 함께 LLM에 넘겨, 그 내용을 참고해서 답을 작성하게 한다.
이 네 단계 중 2~3단계가 “검색(Retrieval)” 부분이고, 4단계가 일반적인 LLM의 “생성(Generation)” 부분이다 — 이 둘을 합친 것이 RAG라는 이름의 유래다.
어디에 쓰이나
- 사내 문서 기반 챗봇 (최신 정책·매뉴얼을 반영해 답변)
- 최신 뉴스나 시세처럼 계속 바뀌는 정보를 다루는 서비스
- AI Agent가 작업 중 필요한 정보를 스스로 찾아 활용하는 경우 — Anthropic은 검색(retrieval)을 도구·메모리와 함께 “증강된 LLM(augmented LLM)“을 구성하는 기본 요소 중 하나로 설명한다.
- LM Studio 같은 로컬 도구도 문서를 첨부하면 내부적으로 비슷한 방식(청크 분할 + 임베딩 검색)을 사용한다.
Fine-tuning과의 차이
RAG와 자주 비교되는 개념이 Fine-tuning(미세조정)이다. 둘 다 LLM을 특정 목적에 맞게 보강하는 방법이지만 접근 방식이 다르다 — 자세한 비교는 RAG vs Fine-tuning 글에서 다룬다.
한계와 주의할 점
- 검색이 부정확하면 답변도 부정확해진다 — RAG는 환각을 “줄이는” 기법이지 완전히 없애는 기법은 아니다.
- 문서를 얼마나 잘게 나눌지, 어떤 임베딩 모델을 쓸지 같은 세부 설계에 따라 품질 차이가 크게 난다.
- 검색된 문서량이 많아지면 LLM에 함께 넘기는 컨텍스트도 길어져 비용·속도에 영향을 줄 수 있다.
결론
RAG는 “LLM이 모르는 것을 검색해서 알려주고 답하게 하는” 구조다. 학습 시점에 갇혀 있는 LLM의 한계를 보완하는 가장 널리 쓰이는 방법 중 하나이며, 사내 문서 활용부터 AI Agent의 정보 수집까지 폭넓게 쓰인다.