AIML/DL Fundamentals
머신러닝(Machine Learning)이란? AI 안에서의 위치부터 이해하기
AI, 머신러닝, 딥러닝의 관계를 정리하고, 머신러닝이 데이터를 통해 스스로 규칙을 학습하는 방식을 설명한다.
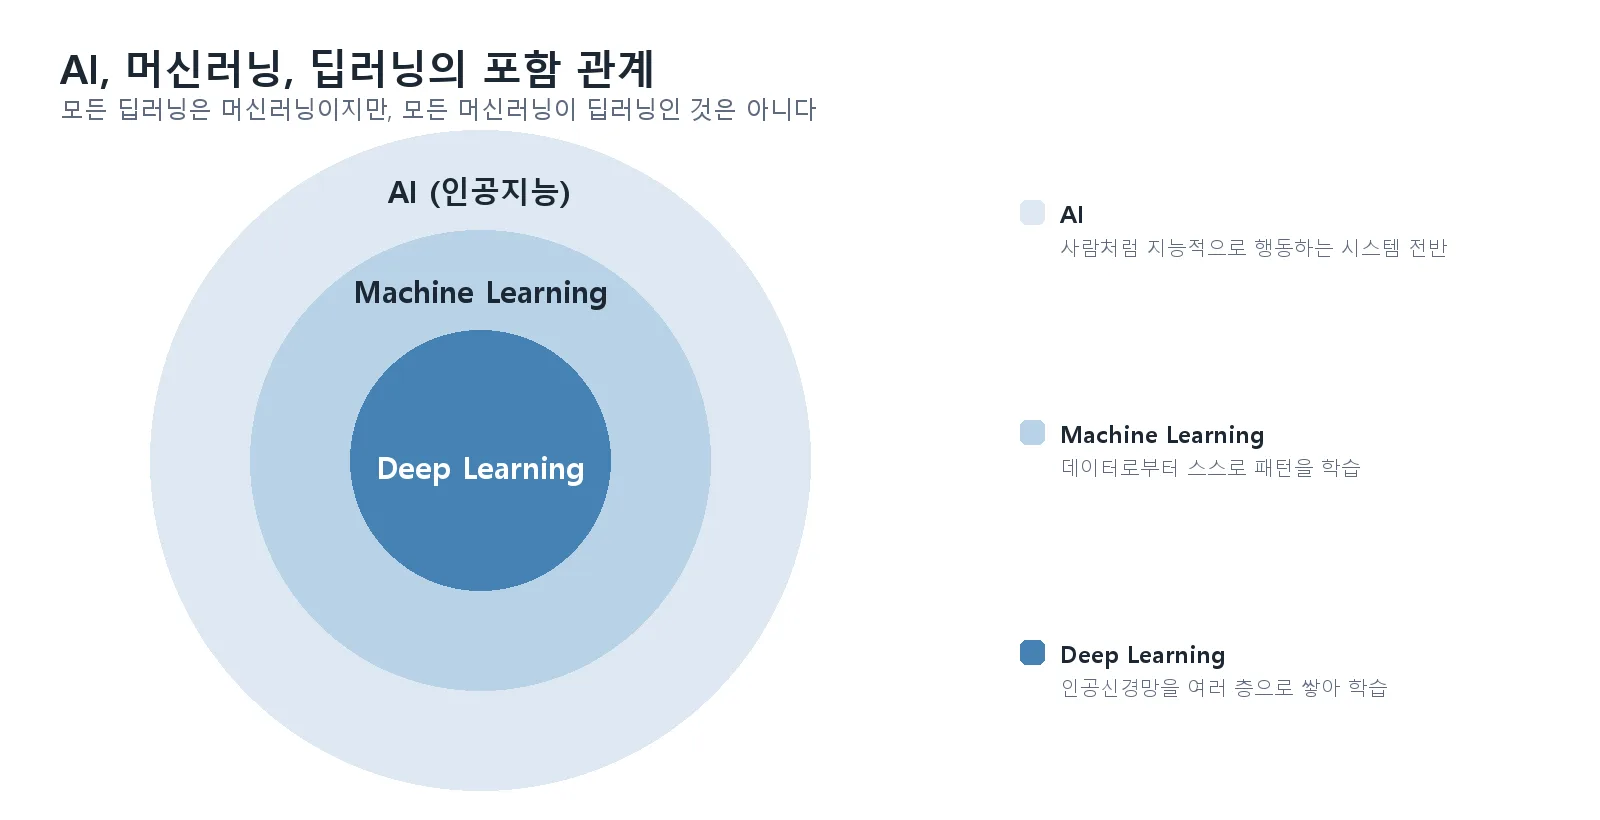
머신러닝(Machine Learning)은 사람이 규칙을 일일이 코드로 정해주지 않아도, 데이터를 통해 스스로 패턴을 학습해 예측·판단하는 인공지능(AI)의 한 분야다. “AI”가 가장 넓은 개념이고, 머신러닝은 그 안의 한 갈래이며, 딥러닝은 다시 머신러닝 안의 더 좁은 갈래다.
Advertisement
전통적인 프로그래밍과 무엇이 다른가
전통적인 프로그래밍은 사람이 “이런 입력이면 이렇게 처리하라”는 규칙을 직접 코드로 작성한다. 머신러닝은 반대다 — 사람이 규칙을 짜는 대신, 입력과 정답 데이터를 많이 보여주면 컴퓨터가 스스로 규칙(패턴)을 찾아낸다. 예를 들어 스팸 메일을 걸러내려면, 전통적 방식은 “이 단어가 포함되면 스팸”이라는 규칙을 하나하나 정해야 하지만, 머신러닝은 스팸/정상 메일 예시를 많이 학습시켜 컴퓨터가 스스로 판단 기준을 찾게 한다.
AI · 머신러닝 · 딥러닝의 관계
AI (인공지능)
 └─ Machine Learning (머신러닝)
└─ Deep Learning (딥러닝)- AI는 “사람처럼 지능적으로 행동하는 시스템”을 가리키는 가장 넓은 용어다.
- 머신러닝은 그중에서도 “데이터로부터 학습하는” 접근 방식을 가리킨다.
- 딥러닝은 머신러닝 중에서도 사람 뇌의 신경망 구조를 본뜬 인공신경망(Neural Network)을 여러 층으로 쌓아 학습하는 방식이다.
즉 모든 딥러닝은 머신러닝이지만, 모든 머신러닝이 딥러닝인 것은 아니다.
Advertisement
머신러닝의 특징
- 작은~중간 규모의 정형 데이터(표 형태 데이터)에서도 잘 작동한다.
- 일반적인 CPU에서도 비교적 적은 메모리로 학습할 수 있다.
- 학습 속도가 빨라 빠르게 반복 실험하기 좋다.
- 다만 어떤 특징(feature)이 예측에 중요한지 사람이 직접 골라 가공해줘야 하는 경우가 많다 (feature engineering).
- 결과를 해석하기 쉬운 경우가 많아, “왜 이렇게 판단했는지” 설명이 중요한 분야(신용평가, 이상거래 탐지 등)에 적합하다.
대표적인 활용 예
- 이상거래 탐지 (신용카드 부정사용 감지)
- 신용점수·대출 심사
- 수요·매출 예측
- 추천 시스템의 기초 알고리즘
이런 사례들은 비교적 정형화된 데이터를 다루고, 판단 근거를 설명할 수 있어야 하는 경우가 많아 머신러닝이 여전히 널리 쓰인다.
Advertisement
한계와 주의할 점
- “머신러닝”과 “딥러닝”이라는 용어가 실무에서는 종종 섞여 쓰이기도 한다. 이 글은 개념적 구분을 명확히 하기 위한 것이며, 모든 문헌이 이 구분을 엄격히 따르는 것은 아니다.
- 머신러닝은 이미지·텍스트·음성처럼 비정형 데이터가 크고 복잡할수록 딥러닝에 비해 상대적으로 성능이 떨어지는 경향이 있다.
결론
머신러닝은 “사람이 규칙을 정하는 대신 데이터로부터 스스로 배우게 하는” AI의 핵심 접근 방식이다. 정형 데이터와 설명 가능성이 중요한 문제에는 여전히 머신러닝이 강점을 갖고, 이미지·텍스트처럼 복잡한 비정형 데이터를 다루는 문제로 갈수록 다음 글에서 다룰 딥러닝이 주로 쓰인다.