Semantic·Instance·Panoptic Segmentation의 차이
픽셀 단위로 이미지를 나누는 세 가지 Segmentation 방식 — Semantic, Instance, Panoptic — 이 각각 무엇을 구분하고 어떻게 다른지 비교한다.
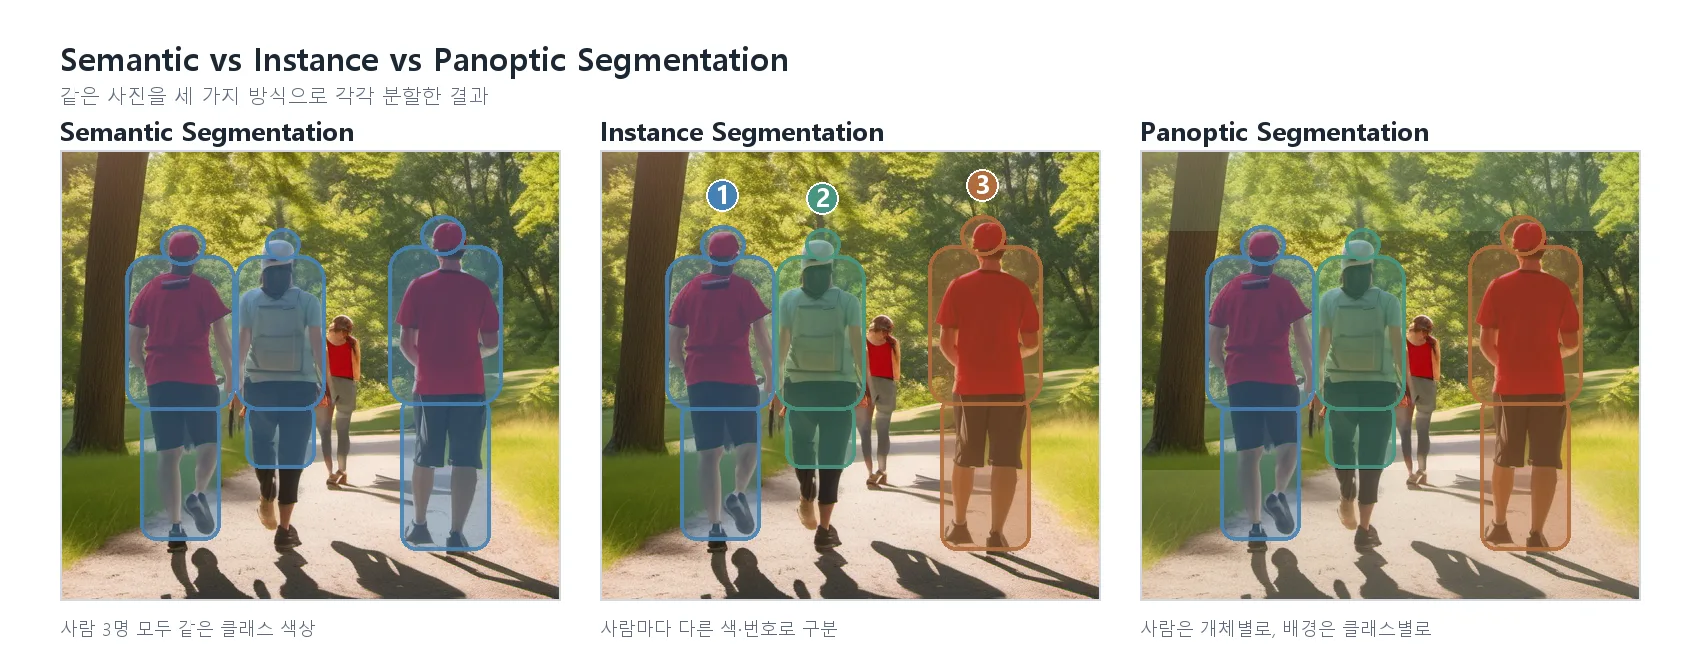
Segmentation(분할)은 이미지를 픽셀 단위로 나누는 Computer Vision 과제이며, “무엇을 어떻게 구분하는가”에 따라 Semantic·Instance·Panoptic 세 가지로 나뉜다. Object Detection이 물체를 사각형 박스로 대략적으로 위치 표시한다면, Segmentation은 물체의 정확한 픽셀 경계까지 표현한다는 점이 다르다.
세 가지 방식 비교
| 방식 | 구분 기준 | 개체 수 구분 | 예시 |
|---|---|---|---|
| Semantic Segmentation | 픽셀마다 클래스만 부여 | 구분하지 않음 | 자동차 3대가 있어도 모두 “자동차” 픽셀로 동일하게 표시 |
| Instance Segmentation | 클래스 + 개체마다 고유 ID 부여 | 개체별로 구분 | 자동차 3대를 각각 다른 색·ID로 구분 표시 |
| Panoptic Segmentation | Semantic + Instance를 결합 | 셀 수 있는 것(thing)은 구분, 셀 수 없는 것(stuff)은 클래스만 | 자동차는 개체별로, 하늘·도로 같은 배경은 클래스별로 표시 |
Semantic Segmentation은 하늘·도로·잔디처럼 “셀 수 없는” 배경(stuff)을 다루는 데 적합하고, Instance Segmentation은 사람·자동차처럼 “셀 수 있는” 개별 개체(thing)를 구분하는 데 적합하다. Panoptic Segmentation은 이미지의 모든 픽셀에 클래스 라벨과 인스턴스 번호를 동시에 부여해, 두 방식을 하나로 합친 결과를 낸다.
SAM은 어디에 속하나
SAM(Segment Anything Model)은 점·박스 같은 프롬프트로 지정한 대상 하나의 마스크를 만들어내는 방식이라, 엄밀히는 위 세 범주와 다른 “prompt 기반 Segmentation”에 가깝다. 다만 이미지 안의 모든 물체에 대해 반복적으로 프롬프트를 주면 사실상 Instance Segmentation과 유사한 결과를 얻을 수 있고, SAM 3는 “개념(concept)“을 지정해 해당하는 모든 인스턴스를 한 번에 분할·추적하는 방향으로 확장됐다.
어디에 쓰이나
- Semantic Segmentation: 자율주행에서 도로·인도·차선 영역 구분, 위성 사진의 토지 유형 분류
- Instance Segmentation: 의료 영상에서 개별 세포·병변 각각의 경계 추출, 재고 관리에서 겹쳐 쌓인 상품 개수 세기
- Panoptic Segmentation: 자율주행처럼 배경(도로·하늘)과 개별 물체(보행자·차량)를 동시에 정확히 이해해야 하는 상황
한계와 주의할 점
- 세 방식 모두 픽셀 단위로 라벨링된 학습 데이터가 필요한데, 이런 데이터를 만드는 비용이 Object Detection용 바운딩 박스 라벨보다 훨씬 크다.
- Panoptic Segmentation은 두 과제를 합친 만큼 모델 구조와 평가 지표(PQ, Panoptic Quality)도 더 복잡하다.
- 어떤 방식을 선택할지는 “개체를 셀 필요가 있는가”에 달려 있다 — 배경 구분만 필요하면 Semantic으로 충분하고, 개체 수까지 필요하면 Instance 이상이 필요하다.
결론
Semantic·Instance·Panoptic Segmentation은 모두 픽셀 단위로 이미지를 나누지만, “개체를 개별적으로 셀 것인가”라는 기준에서 갈린다. 배경과 개체를 동시에 정확히 이해해야 하는 자율주행 같은 응용에서는 Panoptic Segmentation처럼 두 방식을 결합한 접근이 늘어나는 추세다. 프롬프트 기반으로 유연하게 분할하는 방식은 SAM 글에서 더 자세히 다룬다.