Object Detection이란? 분류·위치 추정을 동시에 하는 방법
이미지 속 물체가 무엇인지(분류)와 어디에 있는지(위치 추정)를 동시에 예측하는 Object Detection의 개념과 대표 알고리즘 계열을 정리한다.
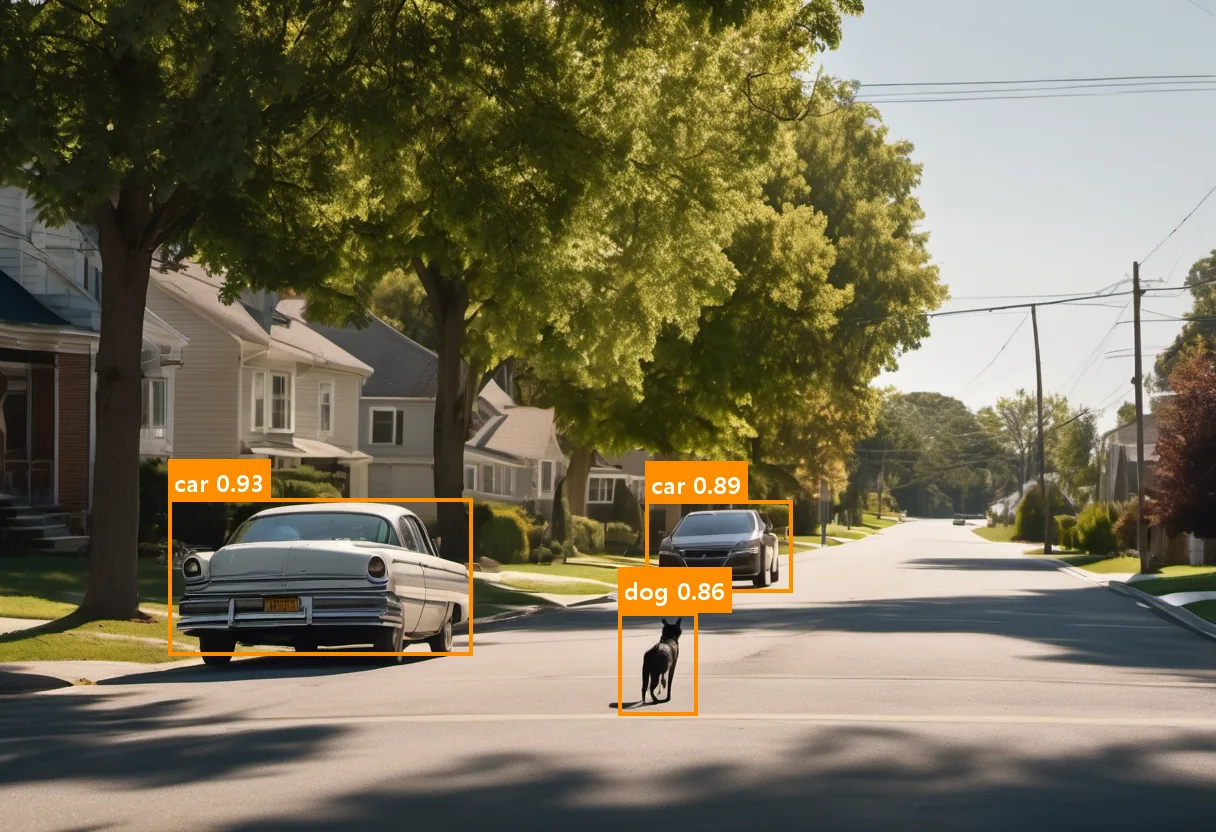
Object Detection(객체 탐지)은 이미지나 영상 속 물체가 “무엇인지”(분류, classification)와 “어디에 있는지”(위치 추정, localization)를 동시에 예측하는 Computer Vision 과제다. 결과물은 보통 물체를 감싸는 사각형인 바운딩 박스(bounding box)와, 그 물체의 클래스·신뢰도 점수(confidence score)로 표현된다. YOLO는 이 과제를 실시간으로 빠르게 푸는 대표적인 모델 계열이다.
Image Classification과 무엇이 다른가
Object Detection을 이해하는 가장 쉬운 방법은 Image Classification과 비교하는 것이다.
| 과제 | 질문 | 출력 |
|---|---|---|
| Image Classification | 이 이미지에 무엇이 있는가? | 이미지 전체에 대한 클래스 하나 |
| Object Detection | 무엇이, 어디에 몇 개나 있는가? | 물체마다 바운딩 박스 + 클래스 + 신뢰도 |
Image Classification은 이미지 전체를 하나의 라벨로 요약하지만, Object Detection은 이미지 안에 여러 물체가 동시에 있어도 각각을 개별적으로 찾아낸다.
두 갈래 접근: 2-stage vs 1-stage
Object Detection 알고리즘은 크게 두 갈래로 발전해왔다.
- 2-stage detector: 먼저 “물체가 있을 법한 후보 영역”을 제안(region proposal)한 뒤, 각 후보 영역이 실제로 어떤 물체인지 분류하는 2단계 과정을 거친다. R-CNN 계열(R-CNN, Fast R-CNN, Faster R-CNN)이 대표적이다. 정확도는 높지만 단계가 나뉘어 있어 상대적으로 느리다.
- 1-stage detector: 이미지 전체를 한 번의 신경망 연산으로 통과시켜 위치와 클래스를 동시에 예측한다. YOLO, SSD가 대표적이다. 속도가 빨라 실시간 처리에 적합하다.
최근에는 1-stage detector가 정확도 면에서도 2-stage detector에 근접하거나 특정 조건에서 앞서면서, 실무에서는 YOLO 계열 같은 1-stage 방식이 널리 쓰인다.
성능은 어떻게 측정하나
Object Detection 모델의 정확도는 보통 mAP(mean Average Precision) 로 측정한다. 예측한 바운딩 박스가 실제 정답 박스와 얼마나 겹치는지(IoU, Intersection over Union)를 기준으로, 각 클래스별 정밀도-재현율(precision-recall) 곡선의 면적을 계산하고 이를 전체 클래스에 대해 평균낸 값이다. mAP가 높을수록 물체의 위치와 클래스를 모두 정확히 맞혔다는 뜻이다.
어디에 쓰이나
- 자율주행 차량의 보행자·차량·신호등 인식
- 매장·물류센터의 실시간 재고·인원 카운팅
- 산업 현장의 불량품 탐지, 안전 장비 착용 확인
- 정밀한 픽셀 단위 경계까지 필요하다면 Object Detection 대신 SAM 같은 Segmentation 모델과 조합해야 한다
한계와 주의할 점
- 학습 데이터에 포함되지 않은 클래스는 기본적으로 탐지하지 못한다 (open-vocabulary 탐지를 지원하는 최신 모델은 예외).
- 물체가 서로 겹치거나 매우 작을 때는 탐지 정확도가 떨어질 수 있다.
- 바운딩 박스는 사각형이기 때문에 물체의 정확한 윤곽(픽셀 단위 경계)까지는 표현하지 못한다 — 이 부분은 Segmentation의 영역이다.
결론
Object Detection은 “무엇이 어디에 있는가”라는 질문에 바운딩 박스·클래스·신뢰도로 답하는 Computer Vision의 핵심 과제다. 2-stage와 1-stage라는 두 갈래로 발전해왔고, 오늘날 실시간 응용에서는 YOLO 같은 1-stage 계열이 널리 쓰인다. 더 정밀한 경계가 필요하면 Segmentation으로 넘어가는 것이 자연스러운 다음 단계다.