YOLO란? Object Detection이 실시간으로 가능한 이유
이미지를 한 번의 순전파로 처리해 물체 위치와 클래스를 동시에 예측하는 YOLO의 기본 원리와 최신 YOLO26의 구조 변화를 정리한다.
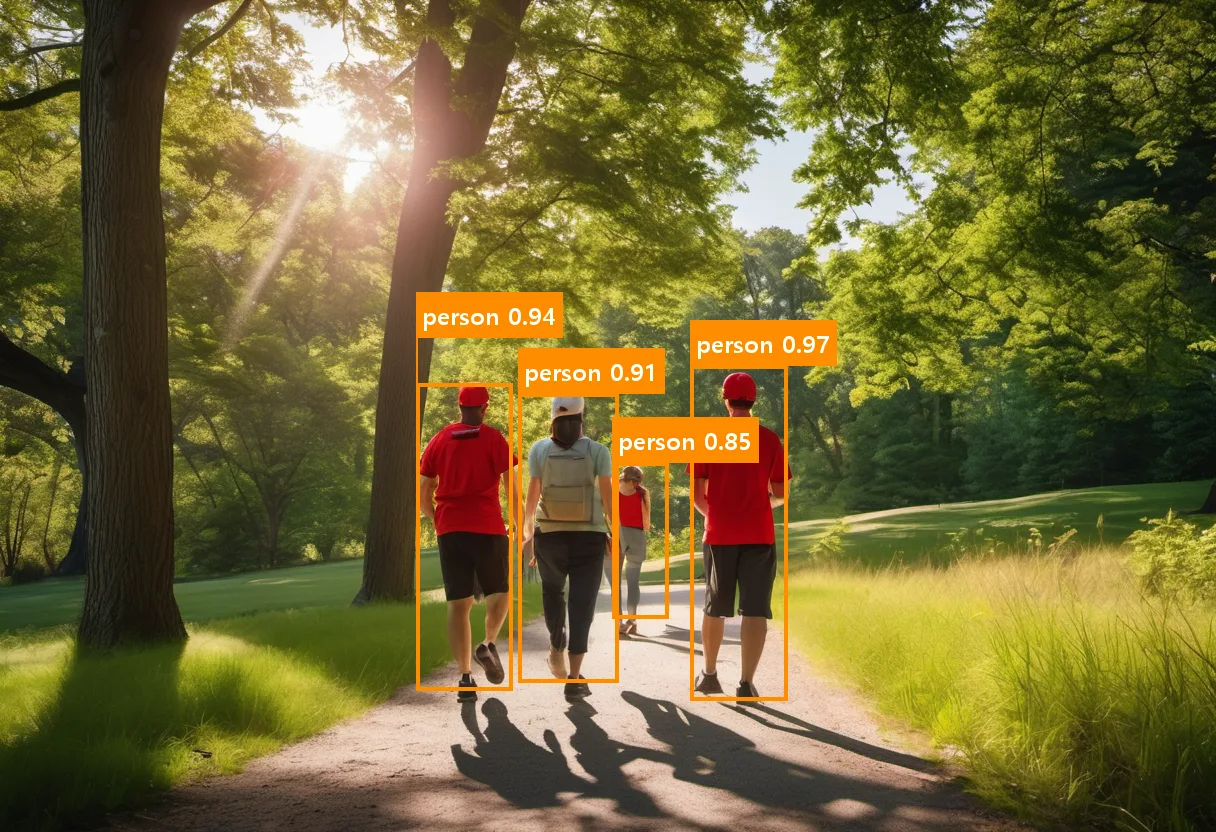
YOLO(You Only Look Once)는 이미지를 한 번의 순전파(forward pass)만으로 처리해, 물체의 위치(바운딩 박스)와 클래스(무엇인지)를 동시에 예측하는 실시간 Object Detection 모델 계열이다. SAM과 YOLO의 차이에서 설명했듯, YOLO는 “어디에 무엇이 있는가”를 빠르게 찾는 데 초점을 맞춘 모델이다.
“You Only Look Once”가 의미하는 것
이미지를 여러 영역으로 나눠 후보 영역을 순차적으로 검사하던 이전 방식(2-stage detector)과 달리, YOLO는 이미지 전체를 한 번의 신경망 연산으로 통과시켜 여러 물체의 위치와 클래스를 동시에 예측한다. 이 “한 번만 본다”는 접근 방식 덕분에 실시간에 가까운 처리 속도를 낼 수 있다.
최신 YOLO26의 구조 변화
Ultralytics 공식 문서 기준으로 YOLO26은 이전 세대 대비 다음과 같은 변화를 도입했다.
- NMS 없는 End-to-End 추론 — 여러 후보 박스 중 중복을 제거하는 후처리 단계(NMS, Non-Maximum Suppression)를 기본 파이프라인에서 제거해, 지연 시간과 배포 복잡도를 줄였다.
- 단순화된 탐지 헤드 — DFL(Distribution Focal Loss) 요소를 제거해 연산 부담을 줄이면서도 위치 예측 정확도를 유지했다.
- 새 학습 기법 — MuSGD(Muon과 SGD를 결합한 옵티마이저), Progressive Loss, 작은 물체 탐지를 돕는 STAL(Small-Target-Aware Label Assignment) 등을 도입했다.
- 작업 통합 헤드 — 탐지뿐 아니라 세그멘테이션, 자세 추정(pose), 분류, 회전된 박스 탐지(oriented detection)까지 하나의 아키텍처로 지원한다.
모델 크기와 성능
YOLO26은 nano(n)·small(s)·medium(m)·large(l)·extra-large(x) 5개 스케일로 제공되며, 파라미터 수는 240만~5,570만 개 범위다. Ultralytics 공식 수치 기준으로 COCO 데이터셋에서 40.9~57.5 mAP, T4 GPU(TensorRT) 기준 1.7~11.8ms의 지연 시간을 보인다. 가장 작은 YOLO26n 모델은 CPU(ONNX) 추론에서 이전 세대 YOLO11n 대비 최대 43% 빠른 것으로 보고됐다.
정확한 공개 일자는 출처마다 다르게 언급되고 있어(문서 생성 시점 vs. 보도 시점), 이 글에서는 특정 날짜를 단정하지 않는다. 실제 도입 시점의 최신 버전과 정확한 릴리스 정보는 Ultralytics 공식 문서에서 확인하는 것이 안전하다.
어디에 쓰이나
- CCTV·매장 영상 분석, 실시간 인원·차량 카운팅
- 자율주행 보조 시스템의 물체 탐지
- 산업 현장의 실시간 불량품 탐지, 안전 장비 착용 여부 확인
한계와 주의할 점
- YOLO는 학습 시 포함되지 않은 클래스는 기본적으로 탐지하지 못한다.
- 정밀한 픽셀 단위 경계가 필요하다면 YOLO 단독보다 SAM과 조합하는 방식이 적합하다.
- 버전마다 라이선스 조건이 다를 수 있으므로 상업적 이용 전 공식 저장소의 라이선스를 확인해야 한다.
결론
YOLO는 이미지를 한 번에 처리해 위치와 클래스를 동시에 예측하는 방식으로 실시간 Object Detection을 가능하게 한 모델 계열이다. 최신 YOLO26은 후처리 단계를 줄이고 학습 기법을 개선해 속도와 정확도를 함께 끌어올렸으며, 탐지 외에도 세그멘테이션·자세 추정 등 여러 작업을 하나의 구조로 지원한다.