VLM이란? Computer Vision과 LLM이 결합되는 방식
이미지와 텍스트를 함께 이해하는 Vision Language Model(VLM)이 CLIP, LLaVA 같은 구조로 어떻게 동작하는지 정리한다.
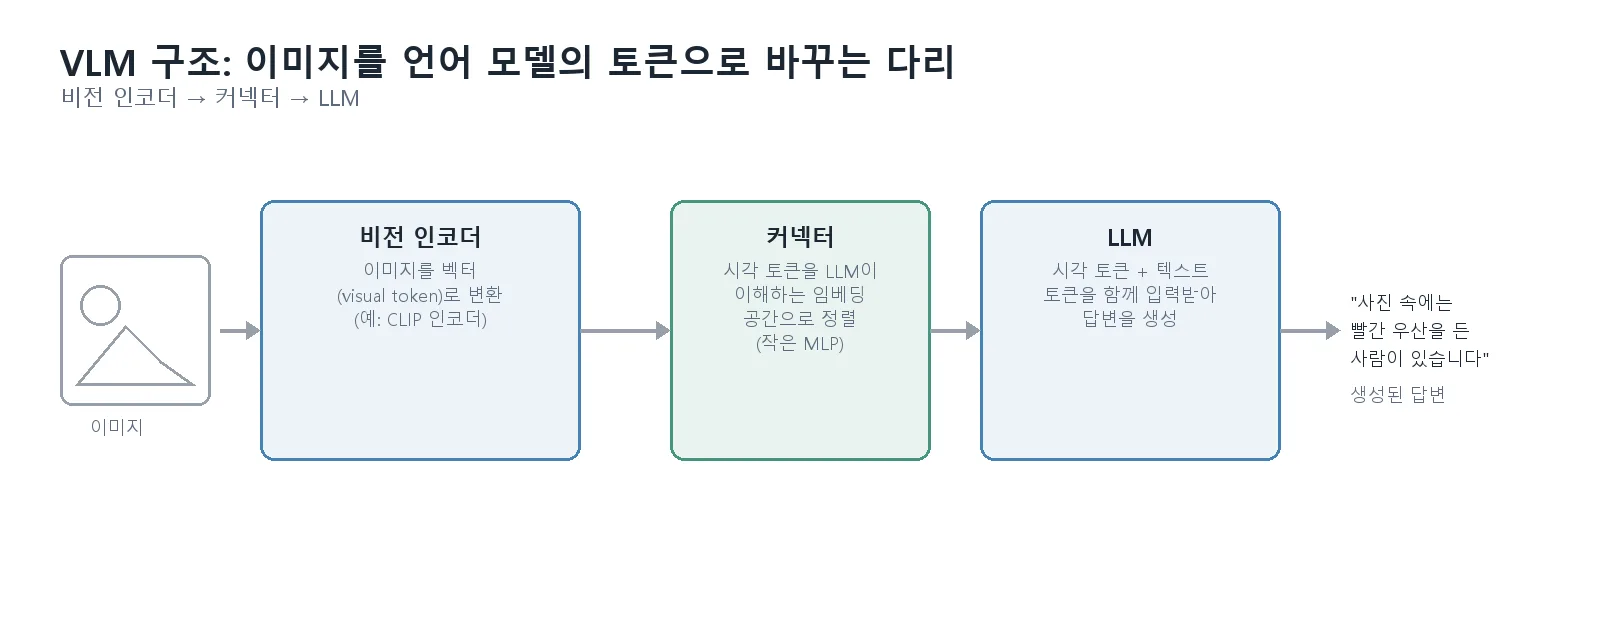
VLM(Vision Language Model, Vision-Language Model)은 이미지와 텍스트를 같은 표현 공간에서 함께 이해하도록 만든 AI 모델로, 사진을 보여주면 그 내용을 설명하거나 사진에 대한 질문에 답할 수 있다. 딥러닝이 이미지 처리와 언어 처리를 각각 따로 발전시켜온 것과 달리, VLM은 두 영역을 하나의 모델 안에서 연결한다는 점이 특징이다.
VLM의 기본 구조
일반적인 VLM은 세 부분으로 구성된다.
- 비전 인코더(vision encoder) — 이미지를 숫자로 이루어진 벡터(visual token)로 변환한다. CLIP 같은 모델의 이미지 인코더가 자주 재사용된다.
- 커넥터(connector / projection layer) — 비전 인코더가 만든 시각 토큰을, 언어 모델이 이해할 수 있는 임베딩 공간으로 변환(정렬)한다. 보통 비교적 단순한 선형 계층(MLP)으로 구현된다.
- LLM(대규모 언어 모델) — 변환된 시각 토큰과 텍스트 토큰을 함께 입력받아, 이미지에 대한 설명·답변 등 텍스트를 생성한다.
즉 VLM은 “이미지를 언어 모델이 읽을 수 있는 또 하나의 토큰 형태로 바꿔주는 다리(bridge)“를 만드는 방식으로 동작한다.
CLIP: 이미지와 텍스트를 나란히 놓는 학습 방식
CLIP(Contrastive Language-Image Pretraining)은 수억 개의 이미지-캡션 쌍을 이용해, 같은 내용을 가리키는 이미지와 텍스트가 벡터 공간에서 서로 가까워지도록 학습하는 대조 학습(contrastive learning) 방식의 모델이다. 이렇게 학습된 CLIP의 이미지 인코더는 이후 다양한 VLM에서 비전 인코더로 재사용되는 표준 구성 요소가 됐다.
LLaVA: 비전 인코더 + LLM을 연결하는 대표 사례
LLaVA는 고정된(freeze) CLIP 비전 인코더와 고정된 LLM을 작은 학습 가능한 MLP 커넥터로 연결하는 구조를 사용한다. 학습은 두 단계로 진행된다.
- 1단계 — 커넥터만 학습: 비전 인코더와 LLM은 그대로 두고, 이미지 토큰을 언어 모델이 이해할 수 있는 형태로 “번역”하는 커넥터만 먼저 학습한다.
- 2단계 — 커넥터 + LLM 함께 미세조정: instruction 데이터로 커넥터와 LLM을 함께 미세조정해, 이미지에 대한 질문에 자연스럽게 답하는 능력을 갖추게 한다.
이 방식은 이미지 인코더와 LLM을 처음부터 함께 학습하는 것보다 계산 비용이 훨씬 적다는 장점이 있다.
VLM은 어디에 쓰이나
- 이미지 설명 생성(캡셔닝), 시각 질의응답(사진을 보고 질문에 답하기)
- 문서·표·차트 이미지를 읽고 요약하는 작업
- Physical AI에서 로봇이 카메라로 본 장면을 이해하고 다음 행동을 결정하는 데 필요한 시각-언어 연결 고리
한계와 주의할 점
- VLM은 이미지에 없는 내용을 그럴듯하게 만들어내는 “환각(hallucination)” 문제에서 자유롭지 않다.
- 비전 인코더가 학습 데이터에 없던 종류의 이미지(예: 특수 센서 영상)에는 잘 대응하지 못할 수 있다.
- 모델마다 이미지 해상도, 처리 가능한 이미지 개수, 응답 정확도가 크게 다르므로 실제 도입 전 벤치마크와 공식 문서를 확인해야 한다.
결론
VLM은 이미지 인코더와 언어 모델을 커넥터로 연결해, 시각 정보를 언어 모델이 이해할 수 있는 토큰으로 바꾸는 방식으로 동작한다. CLIP이 이미지-텍스트를 정렬하는 표준 비전 인코더를 제공했다면, LLaVA 같은 모델은 이 인코더와 LLM을 효율적으로 연결하는 방법을 보여준 대표 사례다.