로컬 LLM용 GPU는 VRAM이 얼마나 필요할까?
LM Studio, Ollama로 로컬 LLM을 돌릴 때 모델 크기별로 어느 정도 VRAM의 GPU가 필요한지, 예산별 선택 기준을 정리한다.
로컬 LLM을 돌릴 GPU를 고를 때 가장 중요한 스펙은 연산 속도(FLOPS)가 아니라 VRAM 용량이다. AI 작업에서 GPU VRAM이 중요한 이유에서 설명한 것처럼, 모델이 VRAM에 다 올라가지 못하면 실행 자체가 안 되거나 CPU/RAM으로 넘어가면서 속도가 크게 느려진다. 이 글에서는 실제로 LM Studio나 Ollama로 어떤 크기의 모델을 돌리려면 GPU를 어떻게 골라야 하는지 정리한다.
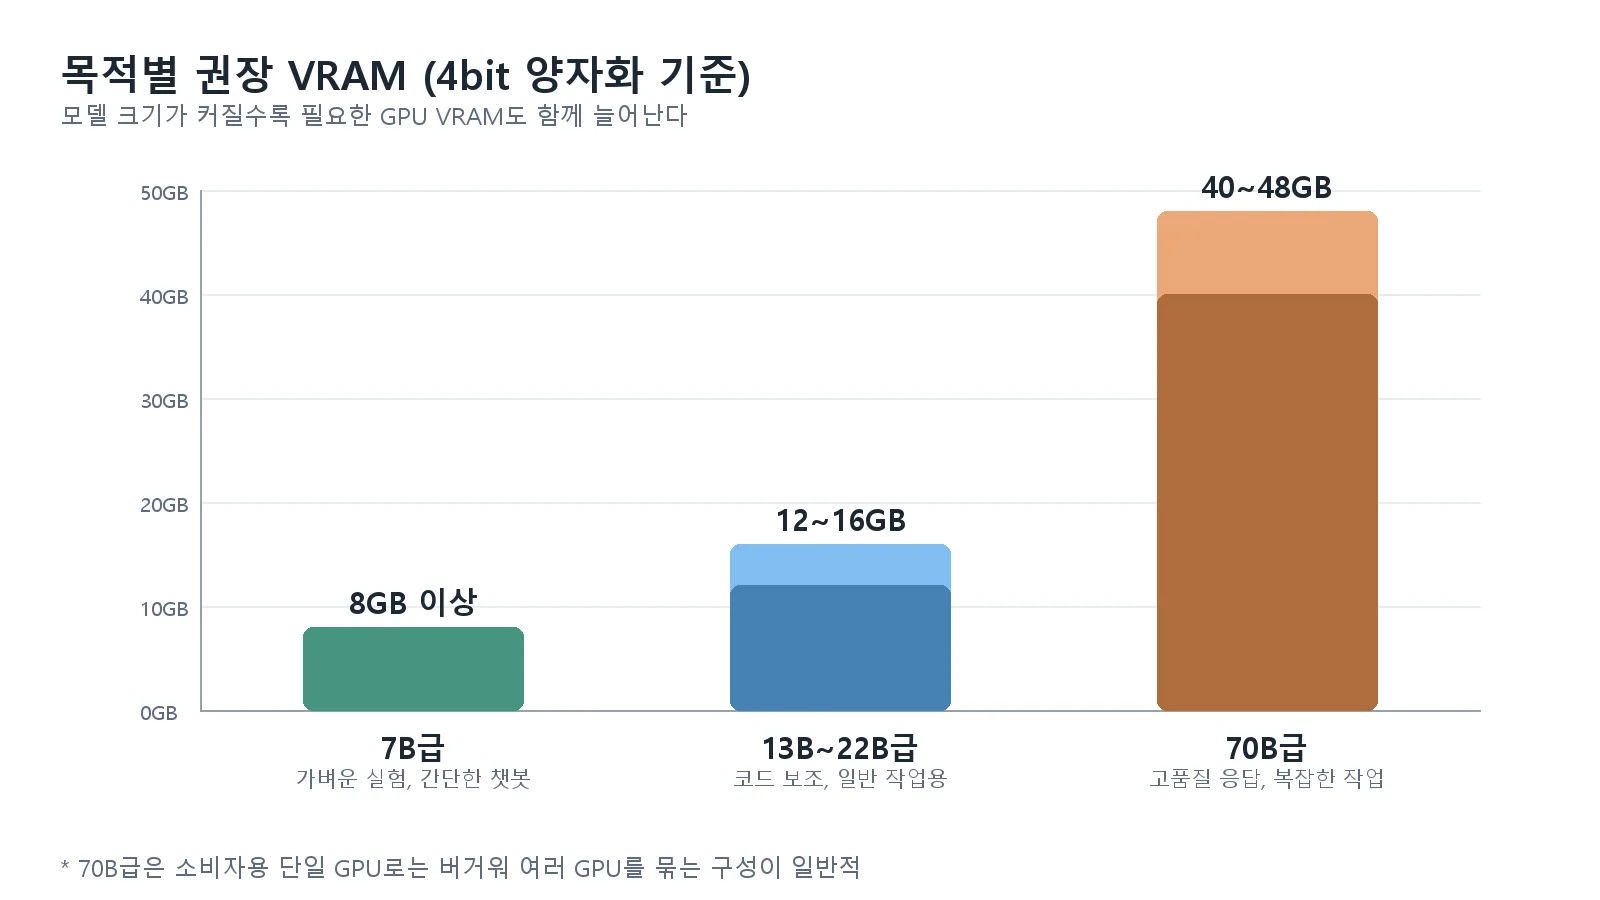
목적별 대략적인 VRAM 기준
| 목적 | 모델 크기(예시) | 권장 VRAM(4bit 양자화 기준) |
|---|---|---|
| 가벼운 실험, 간단한 챗봇 | 7B급 | 8GB 이상 |
| 코드 보조, 일반 작업용 | 13B~22B급 | 12~16GB |
| 고품질 응답, 복잡한 작업 | 70B급 | 40~48GB (또는 GPU 여러 장) |
7B급은 최근 소비자용 GPU 대부분에서 무리 없이 돌아가는 편이고, 13B~22B급부터는 16GB 이상의 VRAM을 가진 카드가 필요해진다. 70B급은 소비자용 단일 GPU로는 버겁고, VRAM이 큰 워크스테이션/서버용 GPU나 여러 GPU를 묶는 구성이 일반적이다.
Context 길이도 VRAM을 갉아먹는다
같은 모델이라도 대화가 길어지거나 긴 문서를 한 번에 넣으면 KV 캐시가 커지면서 VRAM 사용량이 늘어난다. 짧은 질문·답변 위주로 쓸 때보다, 긴 문서를 요약하거나 긴 대화를 이어갈 때는 모델 크기 기준으로 계산한 VRAM보다 여유를 더 둬야 한다.
GPU 고를 때 체크리스트
- VRAM 우선, 클럭 속도는 그다음 — 같은 예산이면 코어 클럭이 조금 낮더라도 VRAM이 더 큰 카드를 선택하는 편이 로컬 LLM 용도에는 유리하다.
- 양자화 수준을 미리 정하기 — 4bit(GGUF/AWQ/GPTQ) 기준으로 필요한 VRAM을 계산하면 예산 대비 더 큰 모델을 돌릴 수 있다.
- CPU/통합 메모리 offload는 최후의 수단 — VRAM이 부족할 때 일부를 RAM으로 넘기는 기능이 있지만, 속도 저하가 크므로 상시 사용 목적이라면 권장하지 않는다.
- 실제 제품 사양은 구매 시점에 재확인 — GPU 라인업과 VRAM 용량은 계속 바뀌므로, 이 글의 표는 일반적인 기준으로만 참고하고 구체적인 모델명·가격은 제조사 공식 사양을 확인해야 한다.
결론
로컬 LLM용 GPU 선택은 “어떤 크기의 모델을 어떤 용도로 쓸 것인가”를 먼저 정하고, 거기에 맞는 VRAM 여유분을 계산하는 순서로 접근하는 것이 합리적이다. 7B급은 8GB, 13B~22B급은 16GB 내외, 70B급은 40GB 이상이 대략적인 기준이며, 실제 사용할 context 길이를 감안해 여유를 두는 것이 안전하다.