AILocal LLM & Hardware
Local LLM이란? Cloud LLM과 장단점 비교
내 컴퓨터에서 직접 실행하는 Local LLM이 ChatGPT·Claude 같은 Cloud LLM과 무엇이 다른지, 언제 유리한지 정리한다.
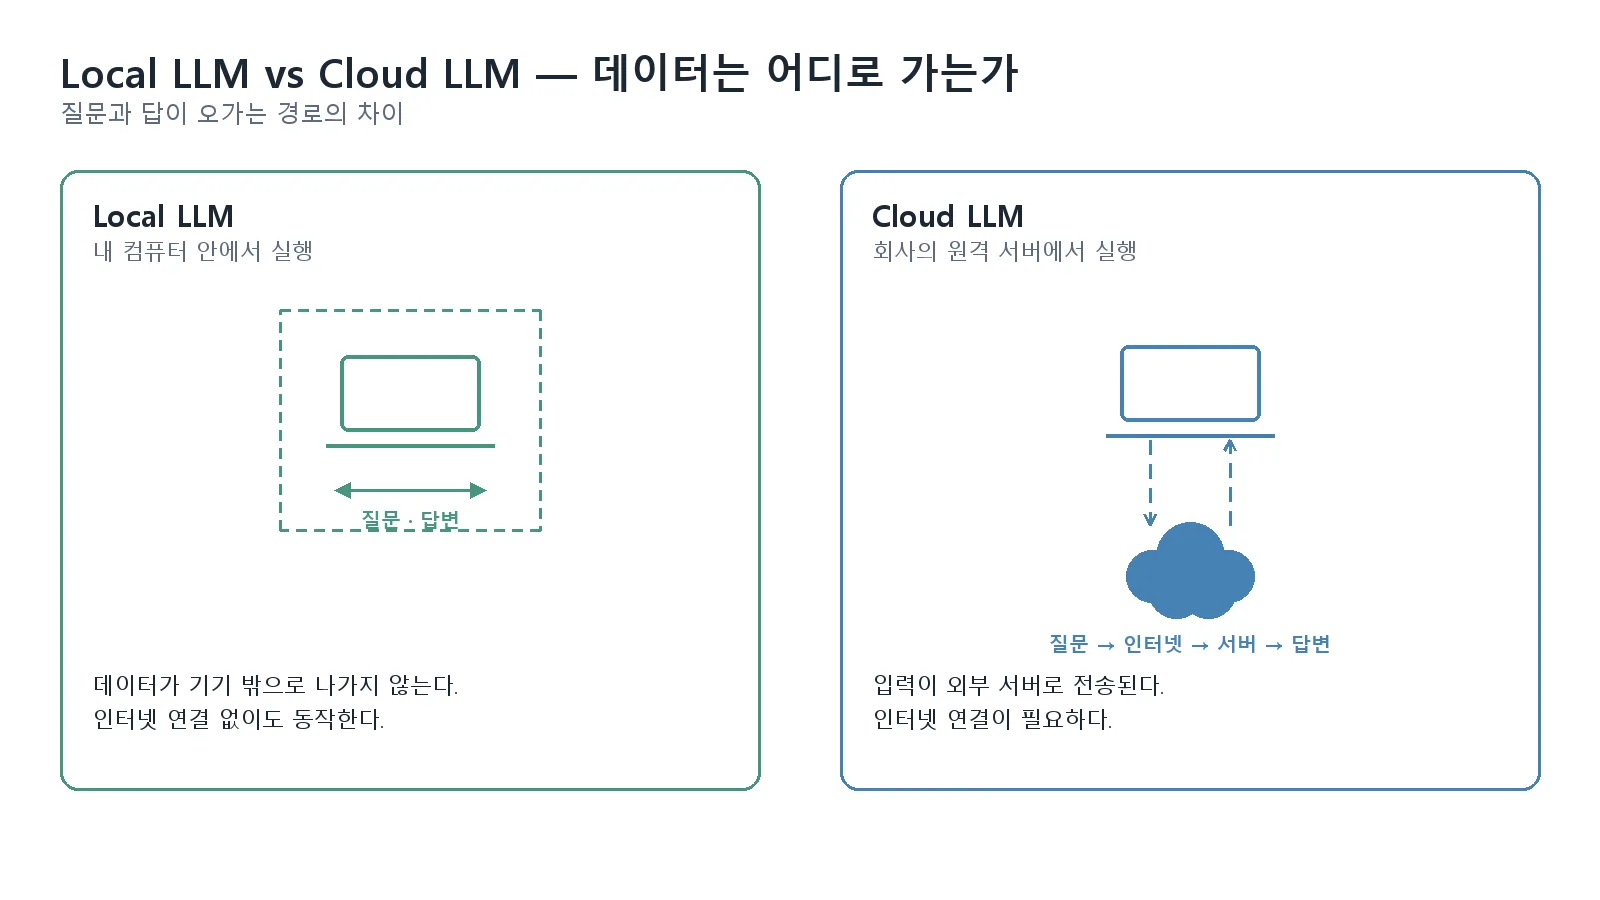
Local LLM은 ChatGPT나 Claude처럼 인터넷 너머 회사 서버에 요청을 보내는 대신, 내 컴퓨터(또는 사내 서버) 안에서 직접 실행하는 LLM을 말한다. 질문을 입력하면 인터넷을 거치지 않고 내 하드웨어에서 바로 답이 생성된다. LM Studio나 Ollama 같은 도구가 이를 쉽게 만들어주는 대표적인 프로그램이다.
Advertisement
Cloud LLM과 무엇이 다른가
| 구분 | Cloud LLM (ChatGPT, Claude 등) | Local LLM |
|---|---|---|
| 실행 위치 | 회사의 원격 서버 | 내 컴퓨터/사내 서버 |
| 데이터 이동 | 입력이 외부 서버로 전송됨 | 데이터가 기기 밖으로 나가지 않음 |
| 비용 구조 | 사용량 기반 과금(API) 또는 구독 | 초기 하드웨어 투자 후 추가 비용 없음(전기세 제외) |
| 성능 | 최신·최상위 모델 사용 가능 | 하드웨어 성능에 따라 제한됨 |
| 인터넷 필요 여부 | 필요 | 불필요(오프라인 실행 가능) |
Local LLM의 장점
- 프라이버시: 입력한 내용이 외부로 전송되지 않는다. 민감한 사내 문서나 개인정보를 다룰 때 특히 중요하다.
- 오프라인 사용: 인터넷 연결 없이도 동작한다.
- 장기적 비용 구조: 초기 하드웨어(특히 GPU) 투자가 필요하지만, 일단 갖추면 사용량이 늘어나도 추가 API 비용이 들지 않는다. 사용량이 매우 많은 경우(예: 월 5억 토큰 이상) 손익분기점을 넘기면 Cloud API보다 저렴해질 수 있다는 분석도 있다.
- 예측 가능한 비용: 사용량이 급증해도 청구서가 갑자기 커지지 않는다.
Local LLM의 단점
- 성능 격차: 개인용 하드웨어에서 돌릴 수 있는 모델은 GPT-5.6이나 Claude Sonnet 5 같은 최상위 클라우드 모델보다 추론·코딩 벤치마크에서 뒤처지는 경우가 많다고 보고된다.
- 속도: GPU 없이 CPU만으로 돌리면 클라우드 대비 눈에 띄게 느리다.
- 하드웨어 요구사항: 큰 모델일수록 많은 VRAM(그래픽 메모리)이 필요해, 별도의 GPU 투자 없이는 선택지가 제한된다.
- 설정 복잡도: 클릭 몇 번으로 끝나는 Cloud LLM 사용에 비해 초기 설정이 더 필요하다 — 다만 LM Studio나 Ollama 덕분에 이 장벽은 계속 낮아지고 있다.
Advertisement
언제 Local LLM을 고려해야 할까
- 민감한 데이터를 외부로 보낼 수 없는 환경(의료, 법률, 사내 기밀 문서 등)
- 인터넷이 불안정하거나 완전히 끊긴 환경에서 AI 기능이 필요한 경우
- 매우 많은 양의 반복 작업을 돌려야 해서 API 비용이 부담되는 경우
- 실험적으로 다양한 오픈소스 모델을 자유롭게 테스트해보고 싶은 경우
반대로 최고 수준의 정확도가 필요하거나, 별도 하드웨어 투자 없이 바로 시작하고 싶다면 Cloud LLM이 여전히 합리적인 선택이다. 실무에서는 둘을 상황에 따라 섞어 쓰는 하이브리드 접근도 자주 쓰인다 — 평소 반복 작업은 로컬로, 정말 어려운 작업만 클라우드 API로 보내는 식이다.
Advertisement
한계와 주의할 점
- Local LLM의 성능은 사용하는 모델과 하드웨어(특히 GPU VRAM 용량)에 크게 좌우되므로, 이 글의 일반론이 모든 상황에 그대로 적용되지는 않는다.
- 비용 손익분기점(몇 개월 만에 회수되는지 등)은 분석마다 가정이 달라 편차가 크다. 이 글에 인용한 수치는 특정 시나리오를 가정한 분석 자료(tier2)에 근거하며, 실제 상황에 따라 달라질 수 있다.
결론
Local LLM은 “성능은 조금 포기하더라도 데이터를 내 손 밖으로 내보내지 않거나, 장기적으로 비용을 통제하고 싶은” 상황에 적합한 선택지다. 실제로 시작하는 방법은 LM Studio 사용법과 Ollama vs LM Studio 글에서 이어서 다룬다.