CVPR 2026 Best Paper: 영상 한 편으로 4D 장면을 재구성하는 D4RT
Google DeepMind·UCL·Oxford 연구팀이 CVPR 2026 Best Paper를 수상한 D4RT는 하나의 Transformer로 깊이·3D 궤적·카메라 자세를 동시에 예측해 동적 장면을 재구성한다.
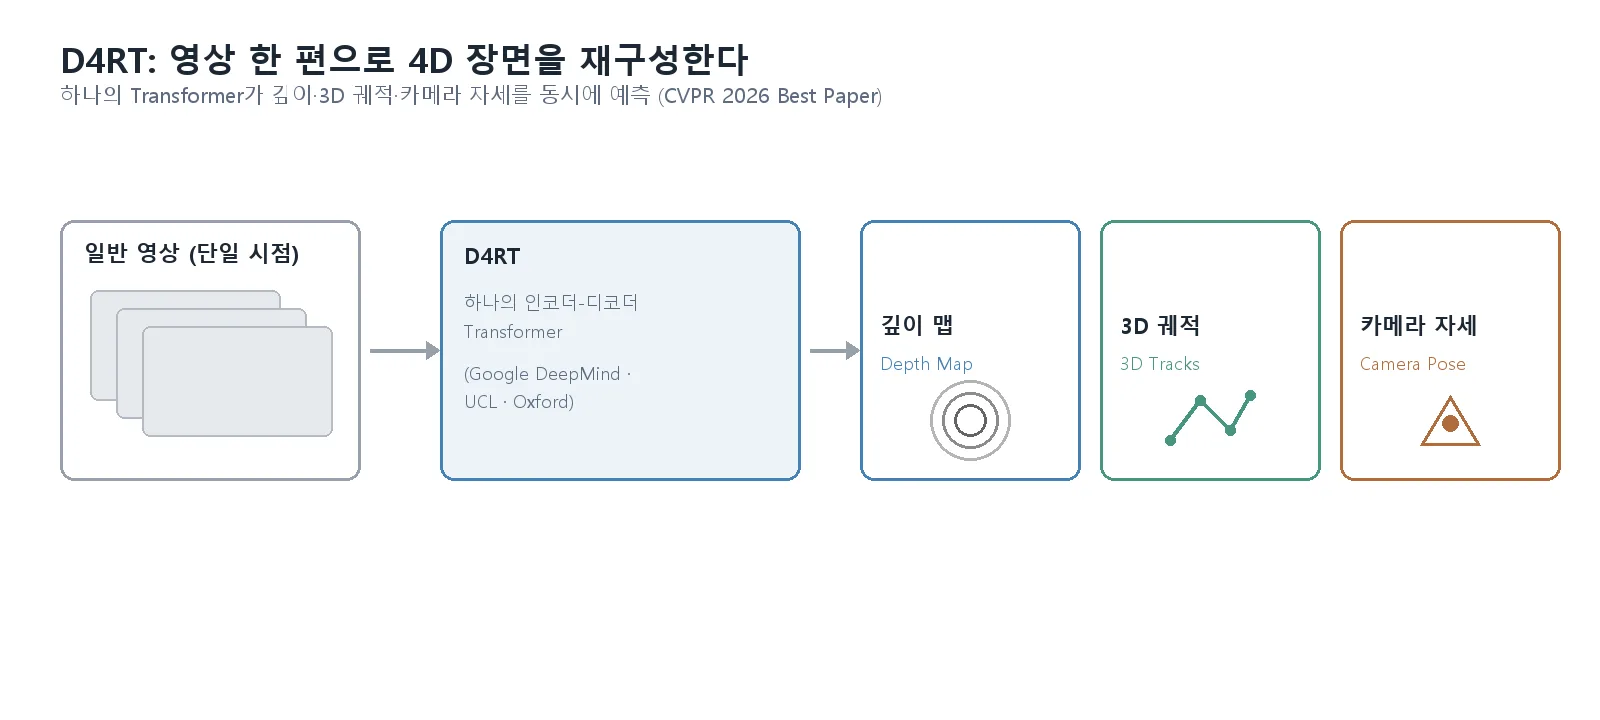
2026년 6월 3~7일 미국 덴버에서 열린 CVPR 2026에서, Google DeepMind·University College London(UCL)·University of Oxford 공동 연구팀의 “Efficiently Reconstructing Dynamic Scenes One D4RT at a Time” 논문이 Best Paper Award를 수상했다. 이 논문이 제안한 D4RT는 하나의 Transformer로 일반 영상에서 깊이 맵(depth map)·3D 궤적(3D tracks)·카메라 자세(camera pose)를 동시에 예측해, 움직이는 4D(3D 공간 + 시간) 장면을 재구성하는 통합 모델이다.
무엇이 새로운가
기존에는 깊이 추정, 3D 궤적 추적, 카메라 자세 추정을 각각 별도의 신경망으로 따로 처리하는 경우가 많았다. D4RT는 이 세 가지를 하나의 인코더-디코더 Transformer 구조 안에서 동시에 처리한다는 점이 핵심이다. Stereo Vision이 두 대의 카메라로 깊이를 계산하는 것과 달리, D4RT는 일반적인 단일 시점 영상만으로도 동적 장면의 4D 구조를 복원할 수 있다.
대회 규모와 선정 과정
CVPR 2026은 16,092건의 제출 논문 중 4,089건이 채택돼 약 25.4%의 채택률을 기록했다. 시상식은 6월 5일 개회식에서 진행됐으며, D4RT 외에도 Meta Superintelligence Labs의 “SAM 3D: 3Dfy Anything in Images”가 Best Paper Honorable Mention을 받았다 — 단일 이미지에서 물체의 기하학적 구조·텍스처·배치를 예측하는 생성 모델로, 이 사이트에서 다룬 SAM 계열의 확장선에 있는 연구다.
왜 중요한가
깊이·궤적·카메라 자세를 각각의 전용 모델로 따로 계산하던 방식에서, 하나의 통합 모델로 동시에 처리하는 방향으로 연구 흐름이 이동하고 있다는 점을 보여주는 사례다. 이런 통합 접근은 SenseNova-Vision이 탐지·분할·깊이·3D 복원을 하나의 모델로 처리하려 한 시도와도 맥이 닿아 있다 — 여러 Computer Vision 과제를 개별 모델의 조합이 아니라 하나의 아키텍처로 통합하려는 흐름이 여러 연구 그룹에서 동시에 나타나고 있다.
한계와 주의할 점
- 이 글은 학회 공식 발표와 보도자료를 기준으로 작성했으며, 논문의 상세한 기술적 구현(모델 구조 세부사항, 정량 성능 지표 등)은 원 논문을 직접 확인하는 것이 정확하다.
- Best Paper 수상이 곧 실무 도입 준비가 됐다는 의미는 아니며, 연구 단계의 성과와 상용화 가능성은 별개로 평가해야 한다.
결론
D4RT는 깊이·궤적·카메라 자세라는 서로 다른 Computer Vision 과제를 하나의 Transformer로 통합해 동적 장면의 4D 재구성 문제를 효율적으로 푼 연구로, CVPR 2026이 인정한 올해의 성과다. 여러 비전 과제를 하나의 모델로 합치려는 흐름은 D4RT뿐 아니라 SAM 3D, SenseNova-Vision 등에서도 함께 관찰되고 있어, 앞으로 이 사이트에서도 계속 주목할 만한 방향이다.