센스타임, 통합 비전 모델 SenseNova-Vision 오픈소스 공개
중국 AI 기업 센스타임이 탐지·분할·깊이 추정·3D 복원을 하나의 모델로 처리하는 SenseNova-Vision을 오픈소스로 공개했다.
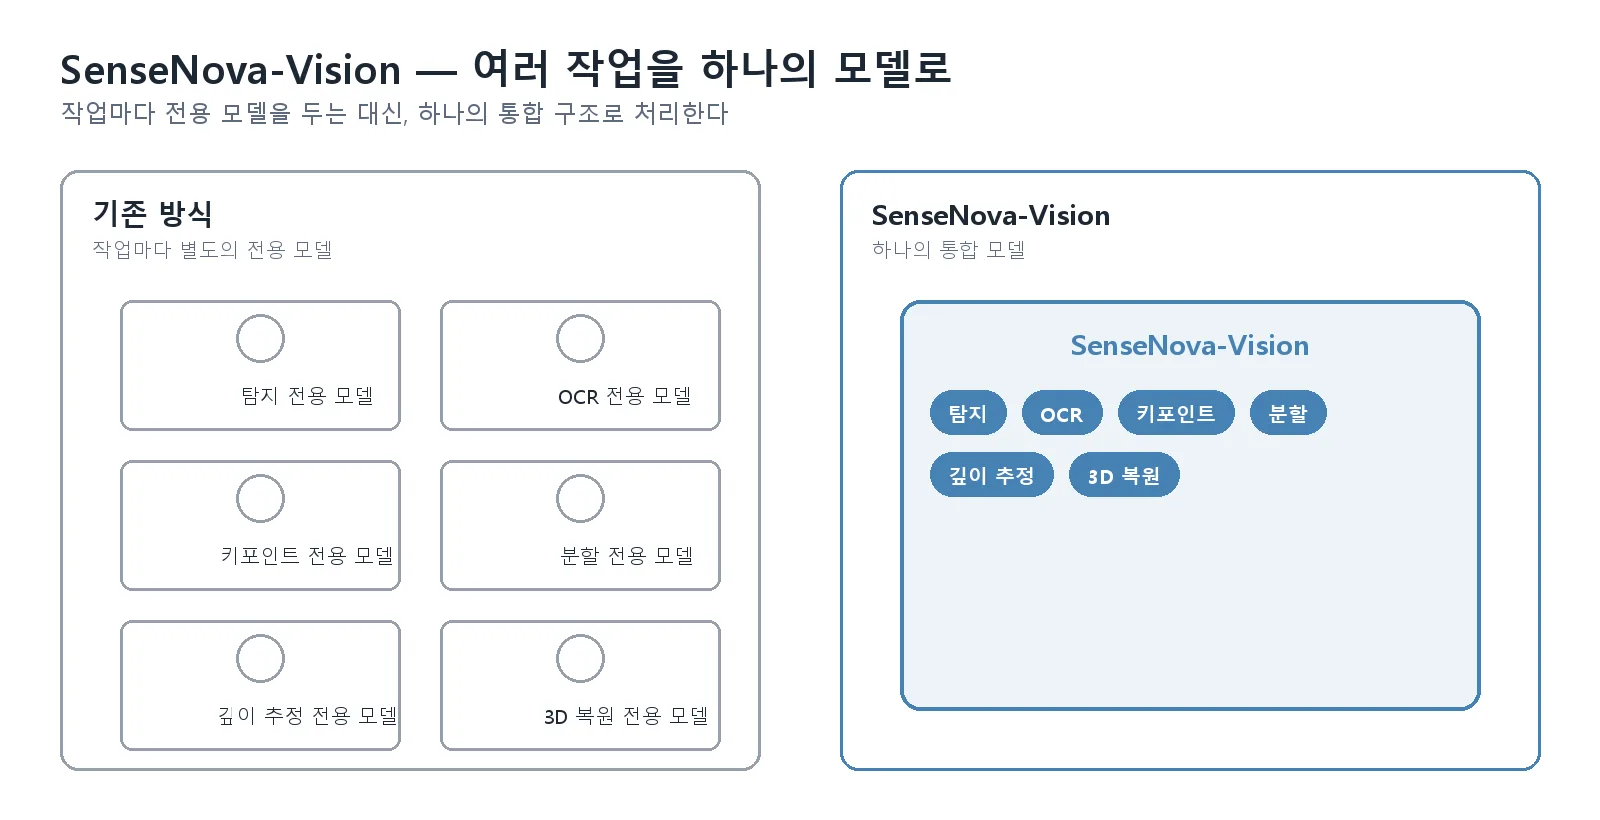
중국 AI 기업 센스타임(SenseTime)이 2026년 7월, 물체 탐지·OCR·키포인트 위치 추정·이미지 분할·깊이 추정·3D 복원을 하나의 모델로 처리하는 통합 비전 모델 SenseNova-Vision을 오픈소스로 공개했다. 작업마다 별도의 전문 모델을 쓰는 대신, 하나의 시스템으로 다양한 비전 과제를 처리하도록 설계됐다.
어떻게 하나의 모델로 여러 작업을 처리하나
SenseNova-Vision은 서로 다른 시각 인식 과제들을 텍스트 생성, 이미지 생성, 또는 텍스트-이미지 혼합 생성 문제로 재구성하는 방식을 사용한다. 즉 탐지·분할·깊이·표면 법선(normal) 추정 같은 작업마다 별도의 전용 head나 decoder, loss 함수를 두는 대신, 하나의 생성 구조 안에서 처리한다는 접근이다. 표면 법선 추정 같은 조밀한 기하 정보 예측은 물론, 여러 시점 이미지를 이용한 point cloud 복원, 카메라 자세 추정 같은 멀티뷰 3D 작업까지 지원한다.
학습 데이터: 5천만 샘플 규모의 시각 지시 데이터셋
센스타임은 이 모델과 함께 5천만 개 샘플 규모의 시각 지시(visual instruction) 데이터셋인 “SenseNova-Vision Corpus-50M”도 함께 공개했다. 모델과 코드는 GitHub와 Hugging Face를 통해 오픈소스로 제공된다.
참고
이 사이트의 SAM과 YOLO의 차이, Segment Anything Model(SAM)이란?에서 다루는 탐지·분할 모델들이 각각 하나의 과제에 특화된 것과 달리, SenseNova-Vision은 여러 비전 과제를 하나의 통합 모델로 처리하려는 시도라는 점에서 접근 방식의 차이가 있다. 정확한 벤치마크 수치와 라이선스 조건은 실제 도입 전 공식 GitHub 저장소를 확인하는 것을 권장한다.